跳转到主要内容
ToolPotion
AI 顾问
提交(免费)

d1-2B

d1-2B 是一个基于 LFM3-VL-2B 构建的决策模型,旨在进行文本、图片和视频分析。它在单次前向传递中提供校准答案,而无需生成令牌。该模型在各种决策基准测试中表现出色,提供超越分类的能力,包括文本提取、物体定位和数量估算。它经过优化,适用于多种应用中的快速决策。

访问URL
分享
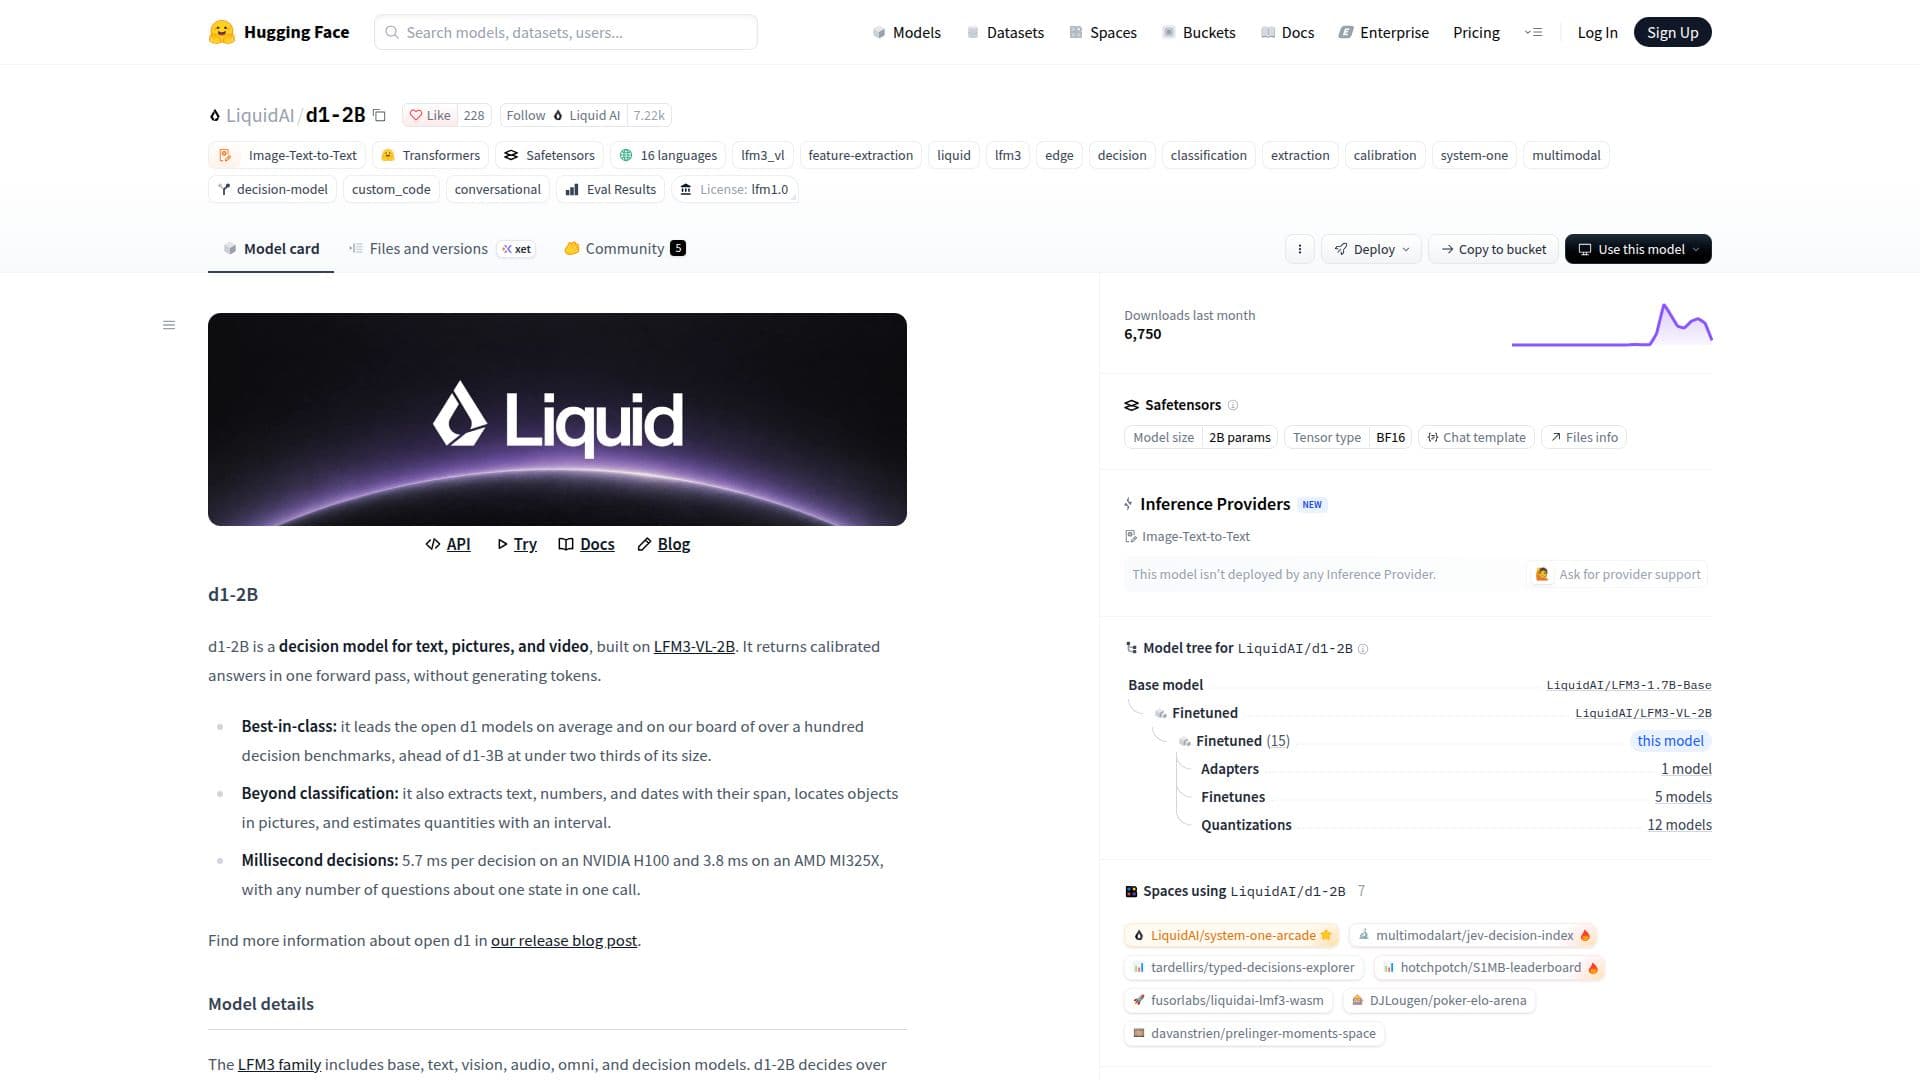
d1-2B 截图
d1-2B 截图

d1-2B 是由 LiquidAI 开发的高效决策模型,托管在 Hugging Face 上。基于 LFM3-VL-2B 架构,该模型旨在处理并根据多模态输入(包括文本、图片和视频)做出决策。d1-2B 的一个关键特性是能够在单次前向传递中返回校准答案,消除了生成令牌的需要,从而提高了速度和效率。

阅读更多

该模型在开放的 d1 模型中表现出色,在一百多个决策基准测试中平均领先。尽管其规模小于 d1-3B,但它通常表现更佳,展示了其优化设计。除了传统的分类任务外,d1-2B 还提供高级功能,如提取特定文本、数字和日期及其范围,精确定位图像中的物体,以及在定义区间内估算数量。

性能是一个显著优势,d1-2B 在 NVIDIA H100 上的决策时间为 5.7 毫秒,在 AMD MI325X 上为 3.8 毫秒。即使在一次调用中对单一状态提出多个问题,这种快速处理也得以保持。LFM3 系列包括 d1-2B,具有基础、文本、视觉、音频、全能和决策模型。虽然 d1-2B 处理文本、图片和视频,但其兄弟模型 d1-Omni-2B 扩展了音频处理能力。

d1-2B 拥有 19.2 亿个参数,LFM3 骨干架构由 24 层组成(13 层门控短卷积、5 层滑动窗口注意力、6 层全局注意力),支持 128K 令牌的上下文长度和 128,000 令牌的词汇量。它接受状态(文本或 JSON)、图片或视频作为输入,以及任意数量的命名问题,生成带有概率的类型化答案,而无需生成令牌。它支持多种语言,包括英语、阿拉伯语、中文、法语、德语、意大利语、日语、韩语、葡萄牙语、西班牙语、越南语、泰语、印尼语、印地语、俄语和波兰语。

d1-2B 多才多艺,适用于需要决策的各种管道步骤,如路由和分流、内容审核、意图和主题分类、文档数据提取、评估和重新排序以及视觉检查。特别指出的是,它不是一个聊天模型。虽然在知识密集型问题上有效,但在超过 64K 令牌的状态下,可靠性可能会下降。对于计数和评分的估算是可靠的,但对于自由数量的估算则不然。该模型在 Transformers 中运行,使用自己的代码,无需采样参数。

  • 类别AI 模型与大语言模型
  • 定价模式开源
  • 部署云端
  • 平台网页版

  • 多模态决策模型(文本、图片、视频)

  • 20 亿参数

  • 单次前向传递以获得校准答案

  • 无令牌生成

  • 最佳决策基准测试性能

  • 文本、数字和日期提取

  • 图片中的物体定位

  • 带区间的数量估算

  • 毫秒级决策速度(例如,在 AMD MI325X 上为 3.8 毫秒)

  • LFM3 骨干架构

  • 128K 令牌上下文长度

  • 128,000 令牌词汇量

  • 多语言支持(15 种以上语言)

  • 设计用于路由、分流、审核、提取

  • 在 Transformers 中运行,使用自定义模型代码

  1. 访问模型页面:导航到 Hugging Face 上的 LiquidAI/d1-2B 模型页面。

  2. 浏览文件:查看提供的模型详细信息、架构和规格。

  3. 配置推理:利用 Transformers 库设置模型进行推理。

  4. 准备输入:提供状态(文本或 JSON)、图片或视频,以及命名问题。

  5. 执行调用:使用 `system_one` 进行单次请求,或使用 `system_one_batch` 进行批量请求。

  6. 解释输出:接收带有概率的类型化答案,无需生成令牌。

  • 路由和分流
  • 审核和保护措施
  • 意图分类
  • 主题分类
  • 文档提取
  • 评估和重新排序
  • 视觉检查
  • 多模态决策

d1-2B 评价

加载中...

与 d1-2B 类似的热门AI工具

LiquidAI d1-omni-600M

大语言模型

LiquidAI d1-omni-600M 是一个拥有 600M 参数的决策模型,旨在对文本、图像和语音进行单次决策。它高效处理多模态输入,快速、准确地提供响应,而无需生成输出标记。

AI 模型与大语言模型
查看工具

大语言模型

拥有 600M 参数的决策模型,旨在对文本、图像和语音进行单次决策。它高效处理多模态输入,快速、准确地提供响应,而无需生成输出标记。LiquidAI d1-omni-600M 是一个拥有 600M 参数的决策模型,旨在对文本、图像和语音进行单次决策。它高效处理多模态输入,快速、准确地提供响应,而无需生成输出标记。

AI 模型与大语言模型
查看 大语言模型 Top 50

LiquidAI d1-Omni-2B 是一个用于处理文本、图像和音频的决策模型。它能够快速提供经过校准的答案,而无需生成令牌,非常适合用于呼叫路由和声音事件检测等应用。

AI 模型与大语言模型
查看工具

用于处理文本、图像和音频的决策模型。它能够快速提供经过校准的答案,而无需生成令牌,非常适合用于呼叫路由和声音事件检测等应用。LiquidAI d1-Omni-2B 是一个用于处理文本、图像和音频的决策模型。它能够快速提供经过校准的答案,而无需生成令牌,非常适合用于呼叫路由和声音事件检测等应用。

AI 模型与大语言模型
查看 AI 模型 Top 5

d3-ultra

AI 模型

d3-ultra 是来自 vLLM 语义路由器的 27B 多模态决策模型。它处理文本、JSON、图像和视频,以概率形式回答问题。非常适合复杂决策任务,支持每个问题最多 131,072 个标记,并提供免费的 API 供测试。

AI 模型与大语言模型
查看工具

AI 模型

来自 vLLM 语义路由器的 27B 多模态决策模型。它处理文本、JSON、图像和视频,以概率形式回答问题。非常适合复杂决策任务,支持每个问题最多 131,072 个标记,并提供免费的 API 供测试。d3-ultra 是来自 vLLM 语义路由器的 27B 多模态决策模型。它处理文本、JSON、图像和视频,以概率形式回答问题。非常适合复杂决策任务,支持每个问题最多 131,072 个标记,并提供免费的 API 供测试。

AI 模型与大语言模型
查看 AI 模型 Top 5

GLiDE 27B

大语言模型

GLiDE 27B 是由 Fastino 开发的一个 270 亿参数的决策模型。它处理包含文本、JSON 和可选图像的状态,以概率形式回答输入的问题。该模型非常适合分类、路由和评分任务,为各种决策应用提供精确的非生成性概率输出。

AI 模型与大语言模型
查看工具

大语言模型

由 Fastino 开发的一个 270 亿参数的决策模型。它处理包含文本、JSON 和可选图像的状态,以概率形式回答输入的问题。该模型非常适合分类、路由和评分任务,为各种决策应用提供精确的非生成性概率输出。GLiDE 27B 是由 Fastino 开发的一个 270 亿参数的决策模型。它处理包含文本、JSON 和可选图像的状态,以概率形式回答输入的问题。该模型非常适合分类、路由和评分任务,为各种决策应用提供精确的非生成性概率输出。

AI 模型与大语言模型
查看 大语言模型 Top 50

DeepSeek-V4-Flash-Vision-Exp 是 DeepSeek-V4 系列中的一个实验性多模态模型,增强了视觉理解能力。它基于 DeepSeek-V4-Flash 架构,提供了改进的多模态代理能力,同时保持文本仅性能。

AI 模型与大语言模型
查看工具

DeepSeek-V4 系列中的一个实验性多模态模型,增强了视觉理解能力。它基于 DeepSeek-V4-Flash 架构,提供了改进的多模态代理能力,同时保持文本仅性能。DeepSeek-V4-Flash-Vision-Exp 是 DeepSeek-V4 系列中的一个实验性多模态模型,增强了视觉理解能力。它基于 DeepSeek-V4-Flash 架构,提供了改进的多模态代理能力,同时保持文本仅性能。

AI 模型与大语言模型
查看 大语言模型 Top 50

Ling-3.1-flash

大语言模型

Ling-3.1-flash 是一个先进的混合推理模型,旨在处理复杂的现实世界任务。它具有5600亿个参数和1百万个令牌的上下文窗口,提升了在医疗、金融和软件工程等多个领域的性能。

AI 模型与大语言模型

大语言模型 排名第 41 位

查看工具

大语言模型

先进的混合推理模型,旨在处理复杂的现实世界任务。它具有5600亿个参数和1百万个令牌的上下文窗口,提升了在医疗、金融和软件工程等多个领域的性能。Ling-3.1-flash 是一个先进的混合推理模型,旨在处理复杂的现实世界任务。它具有5600亿个参数和1百万个令牌的上下文窗口,提升了在医疗、金融和软件工程等多个领域的性能。

AI 模型与大语言模型
大语言模型 排名第 41 位

LiquidAI LFM3-1.7B

大语言模型

LiquidAI LFM3-1.7B 是一款为本地代理和专业应用设计的文本模型。它具有三重混合架构,并支持 256K 令牌上下文窗口,使其适合边缘设备。该模型可适应特定领域的微调。

AI 模型与大语言模型
查看工具

大语言模型

为本地代理和专业应用设计的文本模型。它具有三重混合架构,并支持 256K 令牌上下文窗口,使其适合边缘设备。该模型可适应特定领域的微调。LiquidAI LFM3-1.7B 是一款为本地代理和专业应用设计的文本模型。它具有三重混合架构,并支持 256K 令牌上下文窗口,使其适合边缘设备。该模型可适应特定领域的微调。

AI 模型与大语言模型
查看 大语言模型 Top 50

MiniMax-M3.1-Flash

大语言模型

MiniMax-M3.1-Flash 是一个多模态专家混合模型,旨在用于编码、代理工作流和网络安全。它支持文本、图像和视频输入,通过稀疏注意力和量化感知训练提供改进的任务性能和推理效率。

AI 模型与大语言模型
查看工具

大语言模型

多模态专家混合模型,旨在用于编码、代理工作流和网络安全。它支持文本、图像和视频输入,通过稀疏注意力和量化感知训练提供改进的任务性能和推理效率。MiniMax-M3.1-Flash 是一个多模态专家混合模型,旨在用于编码、代理工作流和网络安全。它支持文本、图像和视频输入,通过稀疏注意力和量化感知训练提供改进的任务性能和推理效率。

AI 模型与大语言模型
查看 大语言模型 Top 50
1/8