描述
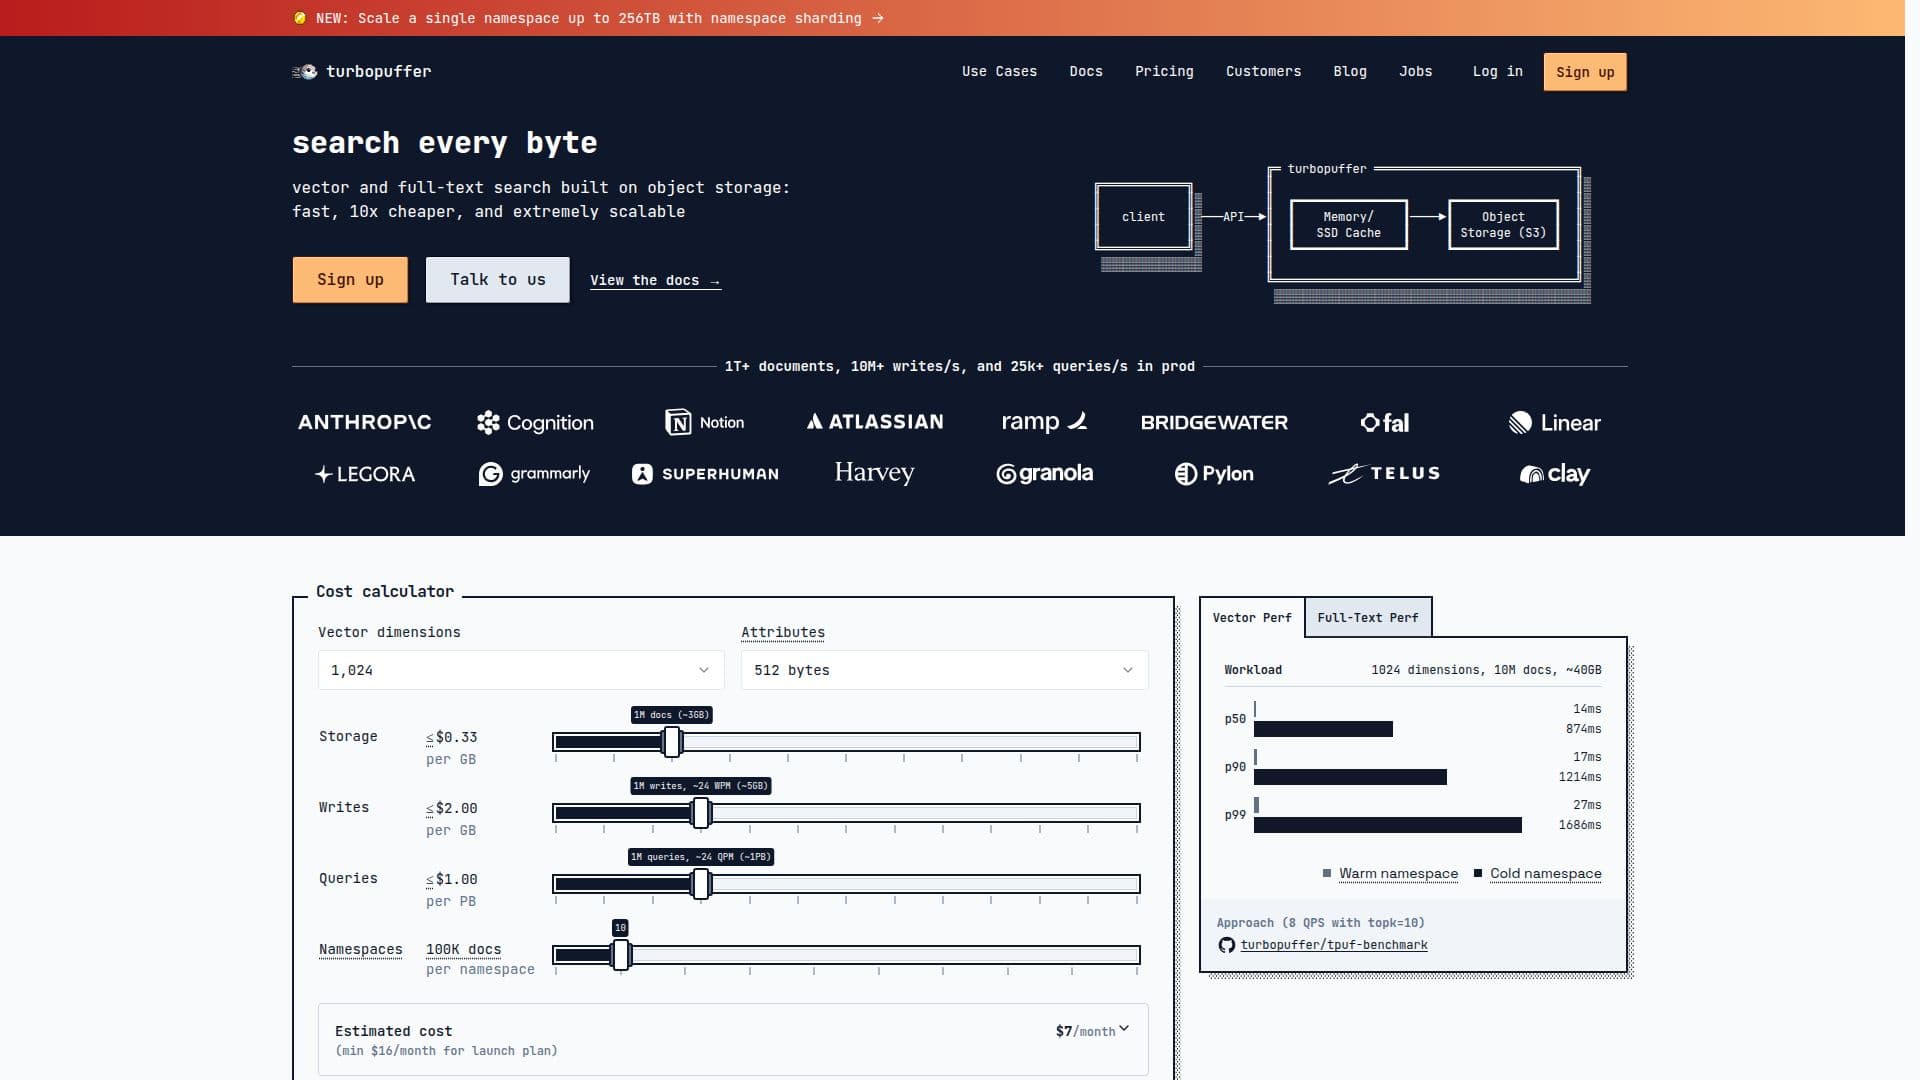
Turbopuffer 旨在使每个字节都可搜索,提供一个基于对象存储的快速且可扩展的搜索引擎。它支持向量和全文搜索,使用户能够高效地搜索大量数据。Turbopuffer 能够处理超过 1 万亿个文档,每秒 1000 万次写入和每秒 25000 次查询,专为高性能和可靠性而设计。
阅读更多
Turbopuffer 的架构利用对象存储作为唯一的真实数据源,这使得显著的成本节约和可扩展性成为可能。通过分离计算和存储,Turbopuffer 最小化了操作复杂性,同时确保搜索索引能够自动扩展以满足需求。这种独特的方法使用户能够为数据创建隔离的命名空间,确保严格的数据隔离和安全性,这对医疗和金融等行业尤其有利。
Turbopuffer 特别适合需要在大数据集上快速、可靠搜索能力的组织。其基于对象存储的设计允许高效的索引和检索,使其成为需要搜索超过 1000 万个文档的应用程序的优秀选择。该平台还支持统一 API,用于各种搜索类型,包括密集和稀疏向量搜索、全文搜索和正则表达式搜索,为开发人员提供灵活性。
Turbopuffer 专注于性能,实现了高查询速度和低延迟,使其成为希望增强数据检索能力的企业的强有力竞争者。定价模型基于使用量,使其对各种规模的组织都可负担,并且设计为随着数据需求的增长而无缝扩展。总体而言,Turbopuffer 作为一个强大的工具,能够将 AI 与大量新鲜数据连接起来,实现更智能、更高效的搜索解决方案。
- 类别向量数据库与检索
- 定价模式按用量计费
- 部署云端
- 平台网页版
turbopuffer的核心功能
向量搜索,召回率超过 90%
全文搜索功能
具有快速三元组索引的正则表达式搜索
多租户或单租户部署
客户控制密钥的加密选项
无限命名空间以实现数据隔离
每秒超过 1000 万次写入的高写入吞吐量
每秒超过 25000 次查询的快速查询处理
如何使用 turbopuffer?
配置:设置您的 turbopuffer 环境并连接到您的对象存储。
索引:将文档写入 turbopuffer 以创建可搜索的索引。
查询:使用统一 API 在您的索引数据中执行搜索。
优化:根据需要调整查询性能和数据检索的设置。
turbopuffer的使用案例
- 文档搜索
- 推荐系统
- AI 数据检索
- 多租户应用程序
- 网页搜索