跳转到主要内容
ToolPotion
AI 顾问
提交(免费)

Flide

Flide 是一个高性能推理基础设施,专为 Jev 风格的决策模型设计。它通过在一次前向传递中将单一状态分叉为所有问题,从而加速决策推理,确保每个问题都能获得与单独提问时相同的答案。这种方法显著提高了吞吐量,并在复杂决策过程中保持高准确性。

访问URL
分享
Flide 截图
Flide 截图

Flide 是一个先进的推理基础设施,专门设计用于加速 Jev 风格的决策模型。其核心创新在于能够执行精确的状态分叉,允许单个输入状态在一次前向传递中处理多个问题。这意味着状态只读取一次,然后高效地分叉,确保每个问题都能获得其在孤立提问时所得到的精确答案。

阅读更多

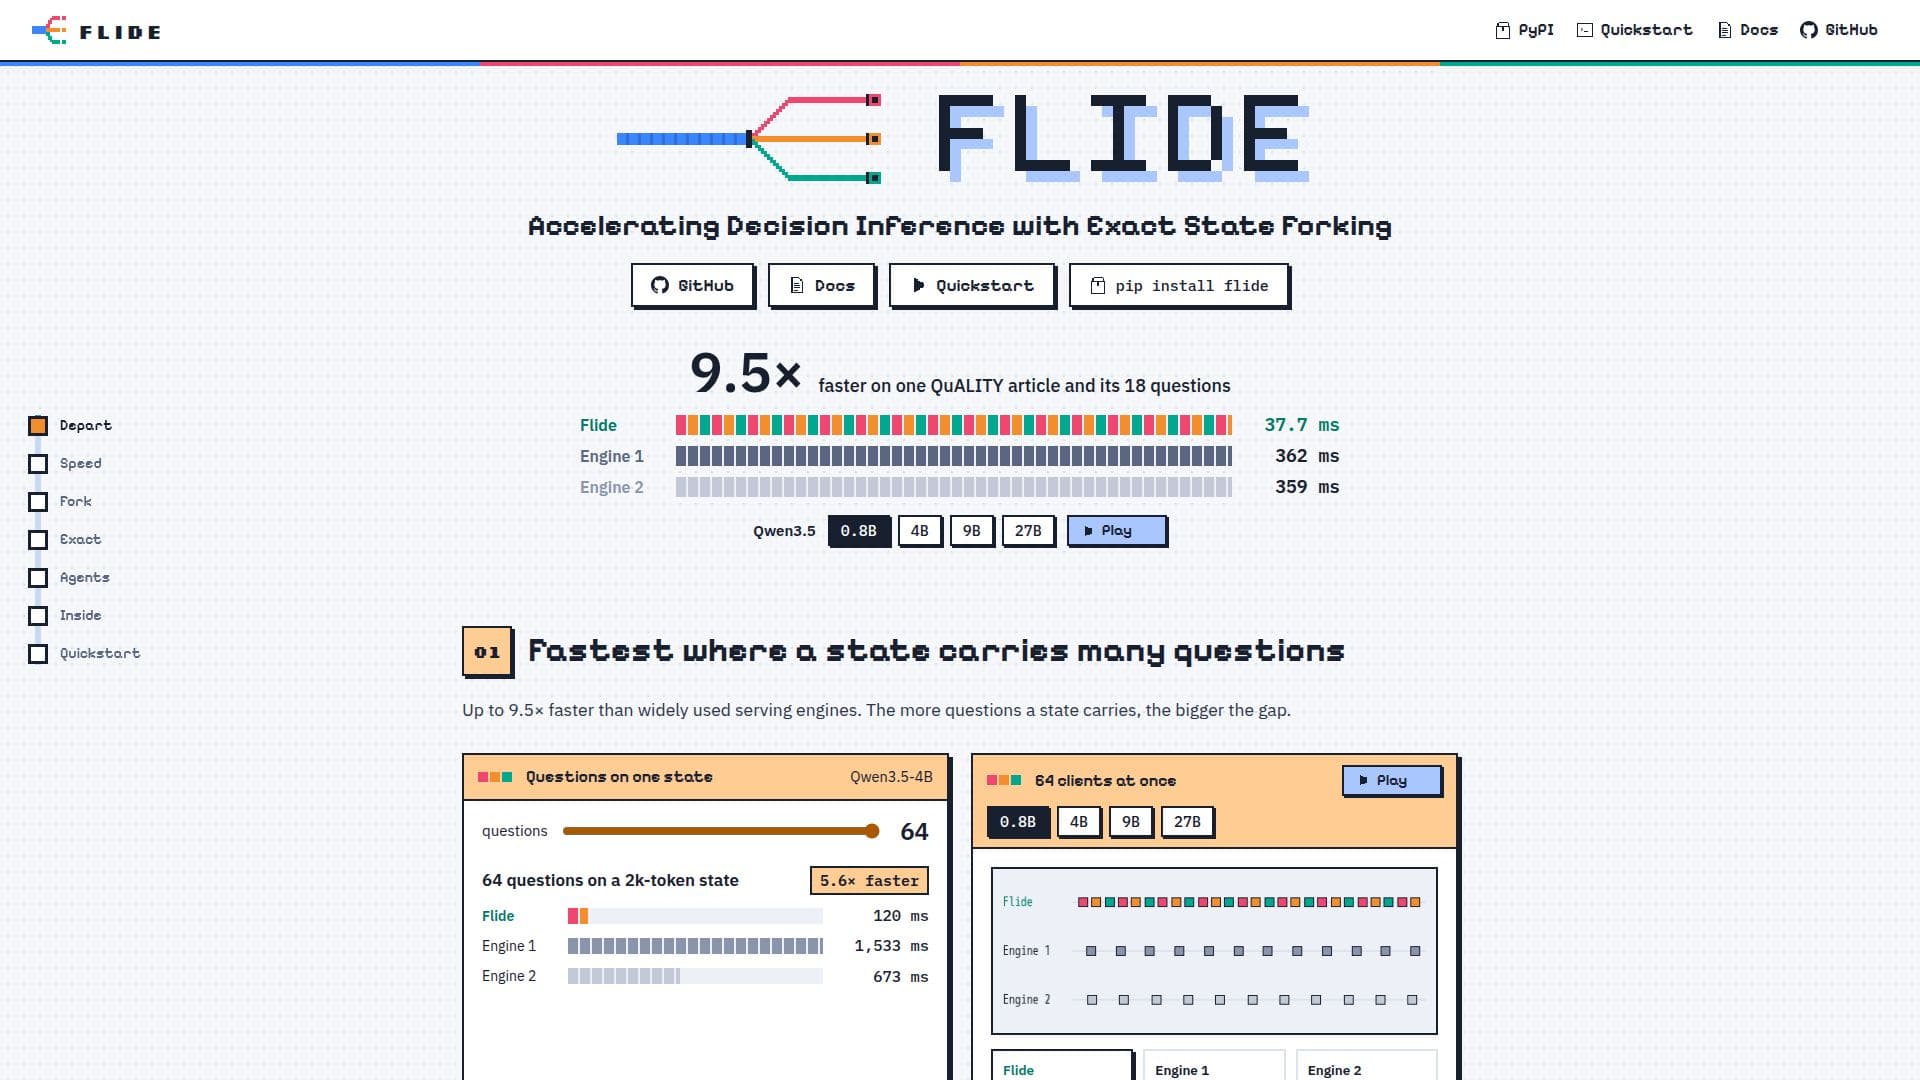
这种独特的架构提供了显著的性能提升,Flide 的推理速度比广泛使用的服务引擎如 vLLM 和 SGLang 快多达 9.5 倍。随着与给定状态相关的问题数量增加,性能优势变得更加明显。例如,在一个 2k-token 状态上,64 个问题时,Flide 实现了 9.5 倍的加速和 2.2 倍的吞吐量,支持 64 个客户端。

除了速度,Flide 还优先考虑准确性,保持在 float32 参考值的 1.1 分以内,使其成为最接近真实参考的引擎之一。它支持多种模型,包括基于 Qwen3.5 和 Gemma 4 的聊天模型,以及 OneJev 模型。Flide 还处理混合模型,其中 Gated DeltaNet 层确保每个问题从共享上下文的确切状态开始。该系统提供了 `--batch-invariant` 选项,确保请求无论如何批处理都能产生相同的结果。

通过 pip 安装非常简单,并且支持使用针对各种 NVIDIA GPU(包括 A40、A10、RTX 30、H100 和 H200)预构建的内核进行服务。Flide 暴露与 vLLM 和 SGLang 相同的 `/v1/systemone` API,为每个选项提供概率。它支持多模态输入,包括文本、图像和视频,具体取决于基础模型。像 FP8 量化用于在 Ada、Hopper 和 Blackwell GPU 上运行 Qwen3.5,以及用于恢复代理状态的会话缓存,进一步增强了其能力。

  • 类别MLOps 与模型部署
  • 部署自托管
  • 平台网页版

  • 精确状态分叉:在一次前向传递中处理一个状态的所有问题。

  • 加速推理:比其他服务引擎快多达 9.5 倍。

  • 高吞吐量:在特定基准测试中,支持 64 个客户端时实现 2.2 倍的吞吐量。

  • 接近 Float32 参考:在准确性上保持在 float32 参考值的 1.1 分以内。

  • 批处理不变性:通过 `--batch-invariant` 确保结果一致,无论如何批处理。

  • ForkAttention 机制:每个问题在其状态中就地读取,仿佛是单独提问。

  • 混合模型的精确性:支持 Gated DeltaNet 层以精确处理上下文。

  • 单一流处理:将请求作为单个令牌流通过 CUDA 图重放。

  • 与 vLLM/SGLang 兼容的 API:使用 `/v1/systemone` API 标准。

  • 预构建内核:针对 NVIDIA A40、A10、RTX 30、H100 和 H200 GPU 进行了优化。

  • 模型骨干:支持 Qwen3.5(0.8B、2B、4B、9B、27B)和 Gemma 4(E2B、E4B、12B、26B-A4B、31B)。

  • 多模态输入:处理文本、图像和视频输入。

  • FP8 量化:在 Ada、Hopper 和 Blackwell GPU 上以 FP8 运行 Qwen3.5。

  • 会话缓存:保留早期状态以供代理恢复(例如,`--session-cache-gb 40`)。

  • 前端进程:支持在多个客户端中以单独进程运行 HTTP、渲染和标记化。

  1. 安装 Flide:使用 pip 安装 Flide 包。

  2. 启动服务器:运行 `flide serve` 启动推理服务器,可选择指定 `--host`。

  3. 配置模型:直接提供 Qwen3.5 或 Gemma 4 等聊天模型,或合并 Open-Jev 适配器。

  4. 发送请求:使用 `/v1/systemone` API 与服务器交互,发送状态和问题。

  5. 处理多模态输入:在状态中包含图像路径,并发送支持图像的模型的媒体。

  • 加速决策模型
  • 多模态推理
  • 一致的批处理
  • 代理状态管理
  • 高性能 LLM 服务
  • 研究与开发

Flide 评价

加载中...

与 Flide 类似的热门AI工具

vLLM

AI 应用

vLLM 是一个高吞吐量和内存高效的推理和服务引擎,专为大型语言模型(LLMs)设计。它使得 AI 模型的快速部署成为可能,提供先进的性能,使得 LLM 服务对各行业的用户而言变得简单、快速且具有成本效益。

MLOps 与模型部署
查看工具

AI 应用

高吞吐量和内存高效的推理和服务引擎,专为大型语言模型(LLMs)设计。它使得 AI 模型的快速部署成为可能,提供先进的性能,使得 LLM 服务对各行业的用户而言变得简单、快速且具有成本效益。vLLM 是一个高吞吐量和内存高效的推理和服务引擎,专为大型语言模型(LLMs)设计。它使得 AI 模型的快速部署成为可能,提供先进的性能,使得 LLM 服务对各行业的用户而言变得简单、快速且具有成本效益。

MLOps 与模型部署
查看 AI 应用 Top 250

通用计算

AI 应用

一个高速AI推理提供商,通过专门构建的ASIC基础设施提供模型,采用与OpenAI兼容的API,针对编码代理和实时语音等对延迟敏感的工作负载,提供低的首次令牌时间和高吞吐量。

MLOps 与模型部署
查看工具

AI 应用

一个高速AI推理提供商,通过专门构建的ASIC基础设施提供模型,采用与OpenAI兼容的API,针对编码代理和实时语音等对延迟敏感的工作负载,提供低的首次令牌时间和高吞吐量。

MLOps 与模型部署
查看 AI 应用 Top 250

Inference.net

AI 应用

Inference.net 为 AI 原生团队提供基础设施,以运行、监控和优化 AI 工作负载。它为开源、自定义和微调模型提供超快推理,确保低成本和快速延迟。

MLOps 与模型部署

微调AI模型 排名第 78 位

查看工具

AI 应用

AI 原生团队提供基础设施,以运行、监控和优化 AI 工作负载。它为开源、自定义和微调模型提供超快推理,确保低成本和快速延迟。Inference.net 为 AI 原生团队提供基础设施,以运行、监控和优化 AI 工作负载。它为开源、自定义和微调模型提供超快推理,确保低成本和快速延迟。

MLOps 与模型部署
微调AI模型 排名第 78 位

Jev AI

AI 应用

Jev AI 是一款为软件团队提供的决策智能工具,拥有快速的 AI 模型且无需排队。它将现实世界的状态转化为结构化、基于概率的决策,从而实现高效的分类、路由、评分和安全检查。

AI DevOps 与云工具
查看工具

AI 应用

为软件团队提供的决策智能工具,拥有快速的 AI 模型且无需排队。它将现实世界的状态转化为结构化、基于概率的决策,从而实现高效的分类、路由、评分和安全检查。Jev AI 是一款为软件团队提供的决策智能工具,拥有快速的 AI 模型且无需排队。它将现实世界的状态转化为结构化、基于概率的决策,从而实现高效的分类、路由、评分和安全检查。

AI DevOps 与云工具
查看 AI 应用 Top 250

JevModel

AI 应用

JevModel 是一个使用 Jev 模型进行结构化 AI 决策的平台,提供 Choice、Score 和 Noul 输出。它允许用户测试文本或 JSON,构建决策流程,处理批量数据,并访问 API 以实现无缝集成。

机器学习平台
查看工具

AI 应用

使用 Jev 模型进行结构化 AI 决策的平台,提供 Choice、Score 和 Noul 输出。它允许用户测试文本或 JSON,构建决策流程,处理批量数据,并访问 API 以实现无缝集成。JevModel 是一个使用 Jev 模型进行结构化 AI 决策的平台,提供 Choice、Score 和 Noul 输出。它允许用户测试文本或 JSON,构建决策流程,处理批量数据,并访问 API 以实现无缝集成。

机器学习平台
查看 AI 应用 Top 250

Morph

AI 应用

一个为编码代理构建的推理平台,提供快速的前沿模型以及用于代码搜索、应用编辑、上下文压缩和监控的专业模型,通过一个兼容OpenAI的API进行操作。

MLOps 与模型部署
查看工具

AI 应用

一个为编码代理构建的推理平台,提供快速的前沿模型以及用于代码搜索、应用编辑、上下文压缩和监控的专业模型,通过一个兼容OpenAI的API进行操作。

MLOps 与模型部署
查看 AI 应用 Top 250

vLLM

AI GitHub 仓库

vllm-project/vllm 是一个高吞吐量和内存高效的推理和服务引擎,专为大型语言模型(LLMs)设计。它在优化性能的同时最小化资源使用,使其适用于人工智能和机器学习的各种应用。

MLOps 与模型部署

AI GitHub 仓库 排名第 23 位

查看工具

AI GitHub 仓库

高吞吐量和内存高效的推理和服务引擎,专为大型语言模型(LLMs)设计。它在优化性能的同时最小化资源使用,使其适用于人工智能和机器学习的各种应用。vllm-project/vllm 是一个高吞吐量和内存高效的推理和服务引擎,专为大型语言模型(LLMs)设计。它在优化性能的同时最小化资源使用,使其适用于人工智能和机器学习的各种应用。

精选MLOps 与模型部署
AI GitHub 仓库 排名第 23 位

trnrt

AI GitHub 仓库

trnrt是一个开源的LLM推理引擎,专为AWS Trainium设计,提供NKI大内核并支持1M-token上下文。由RunAnywhere开发,提供与OpenAI兼容的API,使在专用AWS硬件上高效且可扩展的大型语言模型部署成为可能。该项目为开发者和组织提供了先进的AI模型推理支持。

MLOps 与模型部署

MLOps 与模型部署 排名第 160 位

查看工具

AI GitHub 仓库

开源的LLM推理引擎,专为AWS Trainium设计,提供NKI大内核并支持1M-token上下文。由RunAnywhere开发,提供与OpenAI兼容的API,使在专用AWS硬件上高效且可扩展的大型语言模型部署成为可能。该项目为开发者和组织提供了先进的AI模型推理支持。trnrt是一个开源的LLM推理引擎,专为AWS Trainium设计,提供NKI大内核并支持1M-token上下文。由RunAnywhere开发,提供与OpenAI兼容的API,使在专用AWS硬件上高效且可扩展的大型语言模型部署成为可能。该项目为开发者和组织提供了先进的AI模型推理支持。

MLOps 与模型部署
MLOps 与模型部署 排名第 160 位
1/8