描述
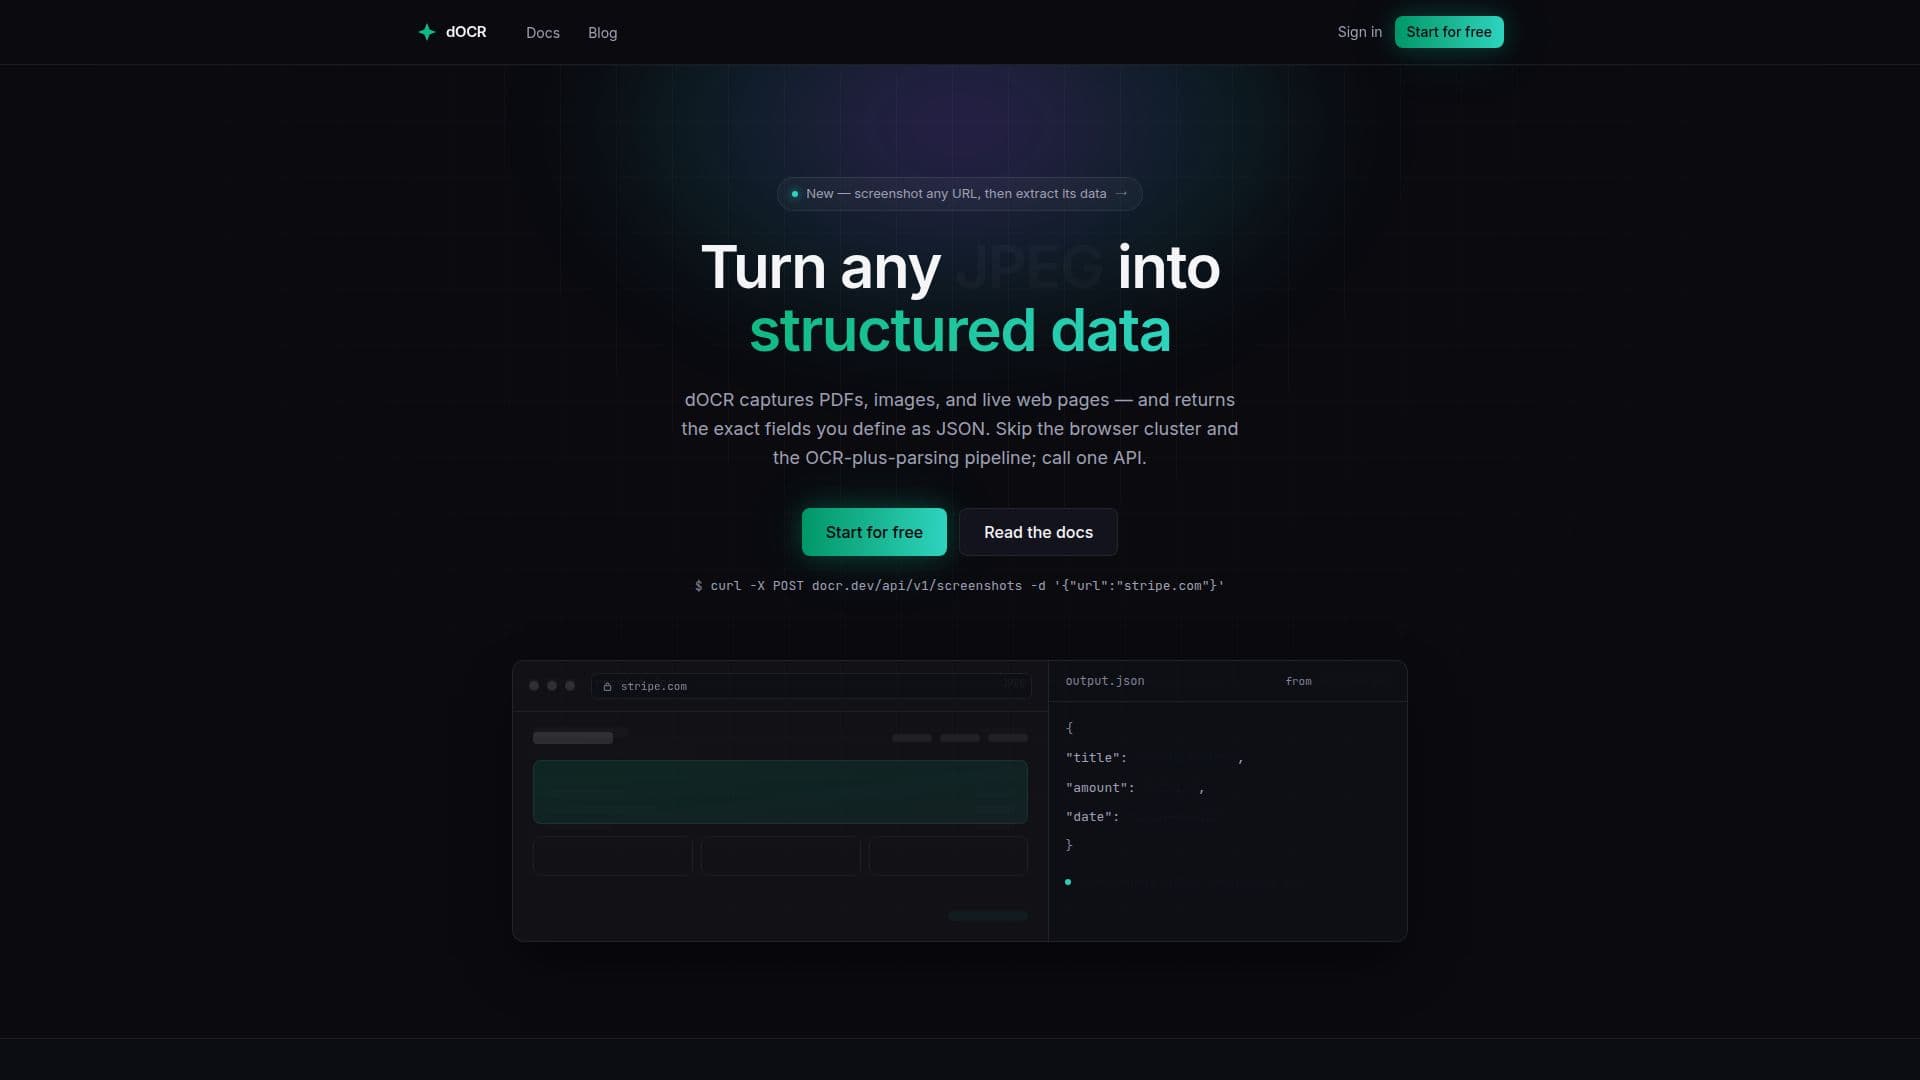
dOCR 提供了一个强大的文档数据提取 API,旨在将各种文档类型和实时网页转换为结构化的 JSON 数据。该服务处理渲染页面和解析文档的复杂性,提供干净的截图和经过验证的 JSON 字段。这种方法使用户能够绕过传统的浏览器集群和 OCR 加解析流程,通过一次 API 调用简化数据获取。
阅读更多
该平台支持广泛的输入,包括 PDF、图像和实时 URL。用户可以定义所需的确切字段,dOCR 将定位、验证并评分每个字段,确保一致的数据输出,而无需任何解析代码。这一能力对于处理商业文档(如发票、收据、表单和身份证)以及从任何实时网页提取数据特别有用。
主要功能包括能够截图任何 URL,将页面渲染为 PNG、JPEG、WebP 或 PDF 等多种格式,支持全页捕获和不同设备视口。dOCR 还会自动阻止广告和 Cookie 横幅,进一步简化数据捕获过程。该服务设计为快速处理,大多数文档在几秒钟内处理完成,包括多页 PDF,使其适合实时请求而非批处理作业。
用户可以定义自定义文档类型,一次性指定所需字段,以确保每次提取返回的数据具有确切的形状。该平台提供了一个仪表板,用于测试和浏览提取历史,以及一个用于后端自动化的 API。这种灵活性使开发人员能够以最小的基础设施开销将 dOCR 集成到他们的工作流程中。
透明性是 dOCR 的核心方面,提供每次提取的详细日志。用户可以追踪每个字段从上传到 OCR、字段提取和模式验证的过程,附带置信度分数。这种可见性有助于识别和解决任何差异,确保数据的准确性和可靠性。该服务通过一个 API 密钥访问,支持截图和结构化数据提取,并提供免费层以便开始使用。
- 类别网页抓取与数据提取
- 定价模式免费增值
- 部署云端
- 平台网页版
dOCR的核心功能
文档数据提取 API
将文档和网站转换为结构化 JSON
支持发票、收据、表单和身份证
捕获 PDF、图像和实时网页
以 JSON 格式返回用户定义的字段
提供网页的干净截图
验证并评分提取的 JSON 字段
将页面渲染为 PNG、JPEG、WebP 或 PDF
在网页捕获期间阻止广告和 Cookie 横幅
快速处理,通常在几秒钟内
支持多页 PDF 处理
允许定义自定义文档类型
提供用于测试和历史记录的仪表板
提供带有置信度分数的详细提取日志
单个 API 密钥用于所有功能
如何使用 dOCR?
创建账户:在 docr.dev 注册以获取 API 密钥。
定义文档类型:指定要提取的 JSON 字段。
发送文档或 URL:使用 API 发送文档(PDF、图像、DOCX)或实时 URL。
接收结构化数据:以经过验证的 JSON 格式返回定义的字段及置信度分数。
查看提取:在仪表板中监控提取历史和日志以确保透明性。
dOCR的使用案例
- 发票处理自动化
- 收据数据捕获
- 表单数据提取
- 网页数据抓取
- 带元数据的文档归档
- 实时数据处理
- 自动化报告
- 合规性和审计跟踪