描述
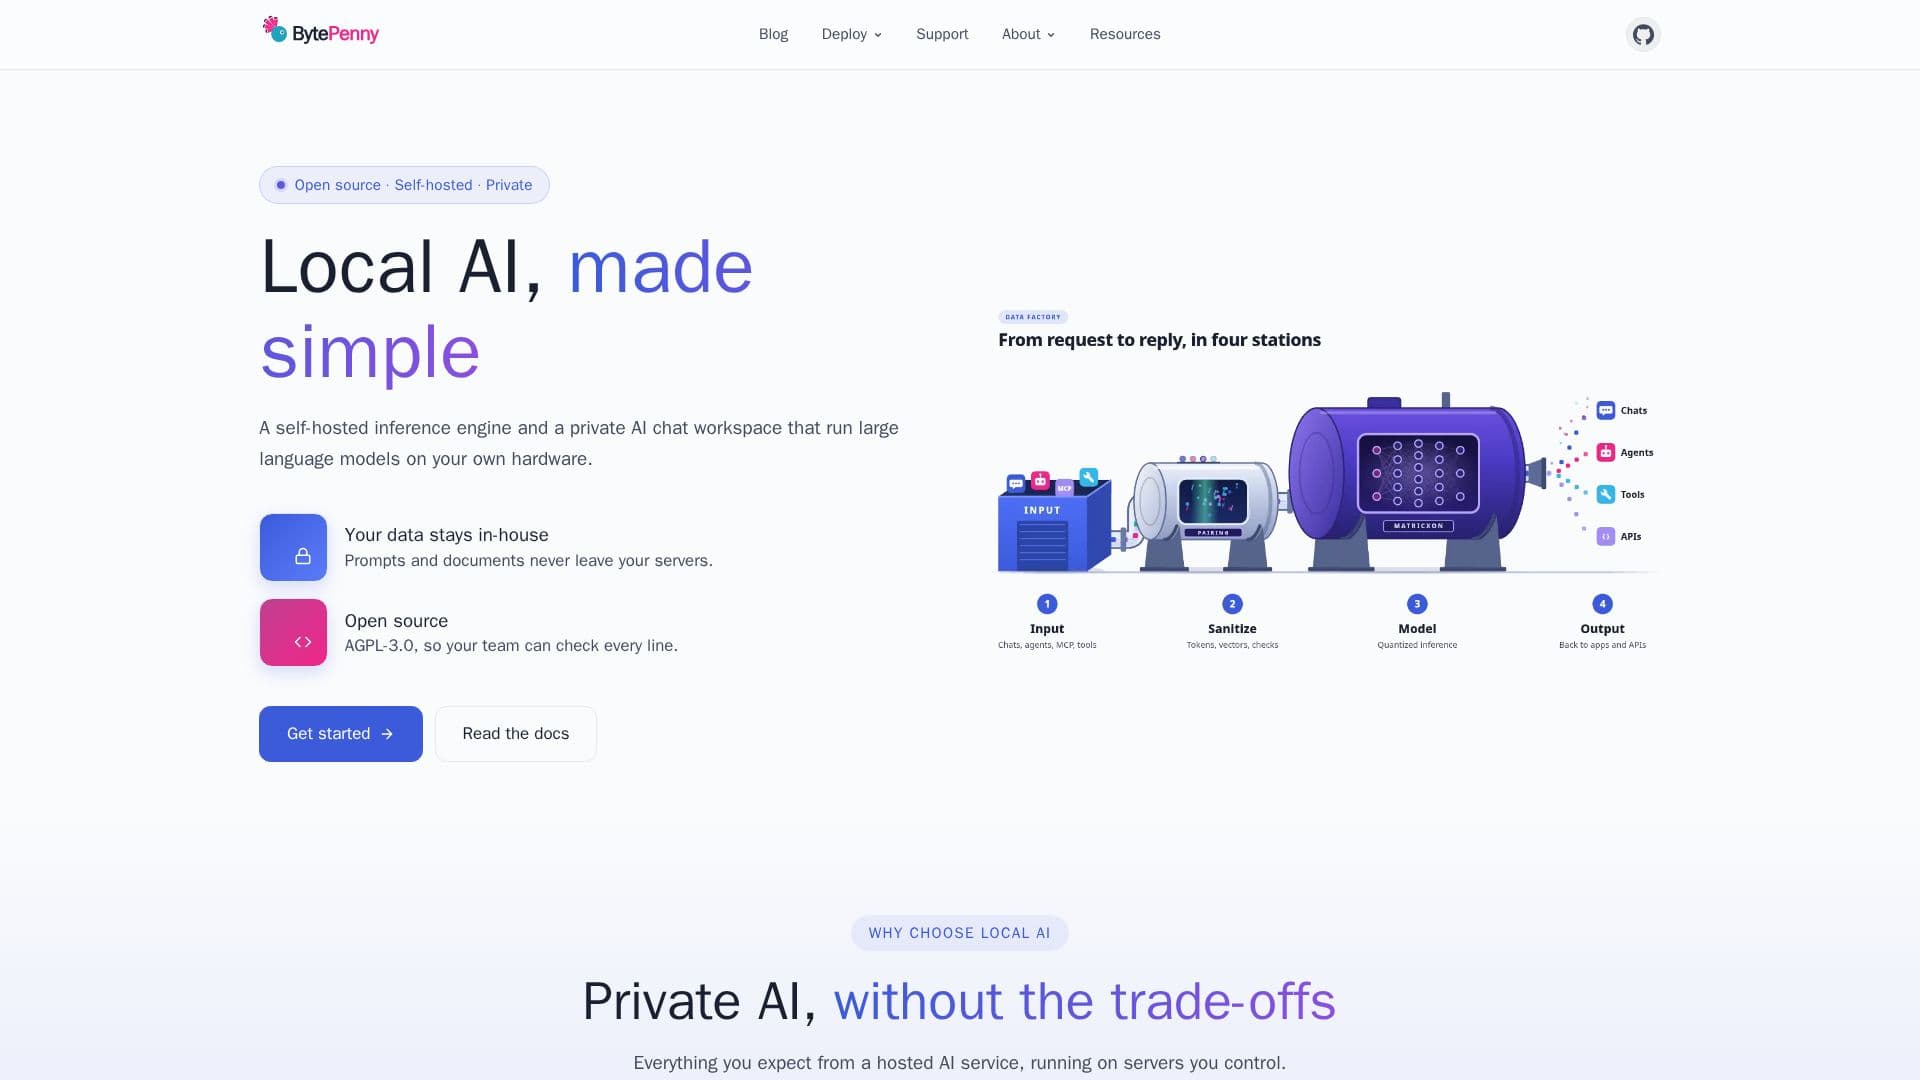
BytePenny 提供了一整套开源的自托管 AI 工具,旨在保护隐私和控制。核心产品包括 Matricxon,一个开源的 GGUF 推理引擎,以及 pAIring,一个为团队量身定制的私有 AI 聊天工作区。这些产品使组织能够直接在自己的硬件上运行大型语言模型,确保提示、文档和聊天数据永远不会离开他们的服务器。
阅读更多
该平台强调数据隐私,完全离线操作以保持所有敏感信息在内部。它支持来自 Hugging Face、llama.cpp 或 Matricxon 引擎的各种 GGUF 模型,并可以与 MCP 工具服务器集成。BytePenny 采用开源理念,使用 AGPL-3.0 许可证,允许团队检查和修改每一行代码,促进透明度和信任。
Matricxon 是一个轻量级、可读的 LLM 运行时,使用 Python 和 PyTorch 编写,具有本地 C 内核以加速性能。它支持用于聊天、文本生成、嵌入、重排序、视觉语言模型和时间序列预测等任务的 GGUF 模型,通过 HTTP API 提供服务。它在 CPU 上高效运行,并为 NVIDIA GPU 提供 BETA 支持,计划扩展到 AMD 和 Apple Silicon GPU。Matricxon 还支持集群模式,以便在多个节点之间共享模型和聊天缓存,通过 pAIring UI 进行管理。
pAIring 是一个为团队协作设计的私有 AI 聊天工作区,提供基于角色的访问、共享频道和集成知识库等功能。它提供加密的聊天缓存,并确保提示不会用于模型训练。该系统具有可扩展性,允许用户从单个服务器开始,并通过添加节点实现负载均衡和故障转移能力进行扩展。对于需要更多计算能力的场景,pAIring 可以连接到多个云服务提供商,如 Bedrock、Vertex AI、Azure OpenAI、Gemini、Groq 等,提供灵活性以混合本地和云引擎。
BytePenny 消除了按令牌计费,允许组织利用现有硬件并在使用增长时保持固定成本。整个技术栈设计为开放,从 AGPL-3.0 代码到开放权重模型,使其非常适合私有和封闭网络。安全性是首要关注点,具有 bcrypt 哈希密码、加密存储的秘密、AES-256-GCM 加密的聊天缓存以及服务器端角色检查等功能,确保管理员操作的安全性。Matricxon 和 pAIring 都获得了 OpenSSF 最佳实践的“通过”徽章,展示了对安全开发实践的承诺。
- 类别MLOps 与模型部署
- 定价模式Open Source (AGPL-3.0), No Per-Token Bills
- 部署Self-Hosted, On-Premise, Cloud (Hybrid)
- 平台Windows, Linux
BytePenny的核心功能
自托管的 AI 推理引擎(Matricxon)
团队的私有 AI 聊天工作区(pAIring)
在自己的硬件上运行大型语言模型
数据保持在内部;提示和文档永远不会离开服务器
开源,采用 AGPL-3.0 许可证
完全离线工作
使用 AES-256-GCM 加密的聊天缓存
团队的基于角色的访问
提示从未用于模型训练
支持来自 Hugging Face、llama.cpp、Matricxon 的 GGUF 模型
支持 CPU 和 NVIDIA GPU 的量化内核
没有按令牌计费;使用增长时保持固定成本
可扩展部署:单节点、共享集群或独立服务器
连接到 12 个以上的云服务提供商(Bedrock、Vertex AI、Azure OpenAI、Gemini、Groq 等)
使用 Python 从头编写,便于可读性和可定制性
如何使用 BytePenny?
部署 BytePenny:在自己的服务器或云基础设施上安装 Matricxon 和 pAIring。
配置推理引擎:将 Matricxon 设置为本地推理引擎或将 pAIring 连接到首选的云服务提供商。
添加模型:集成来自 Hugging Face 或其他来源的 GGUF 模型,或通过连接器利用云托管的模型。
管理用户和团队:配置基于角色的访问,创建共享频道,并在 pAIring 中建立知识库。
开始聊天:开始私有 AI 对话,并利用知识库进行团队协作。
监控和扩展:观察系统状态,管理集群节点,并在使用增长时扩展硬件,而无需承担按令牌计费的费用。
BytePenny的使用案例
- 私有团队聊天
- 本地 LLM 推理
- 安全文档分析
- 成本控制的 AI 操作
- 离线 AI 工作流程
- 自定义模型部署
- 可扩展的 AI 基础设施
- 开源 AI 开发