描述
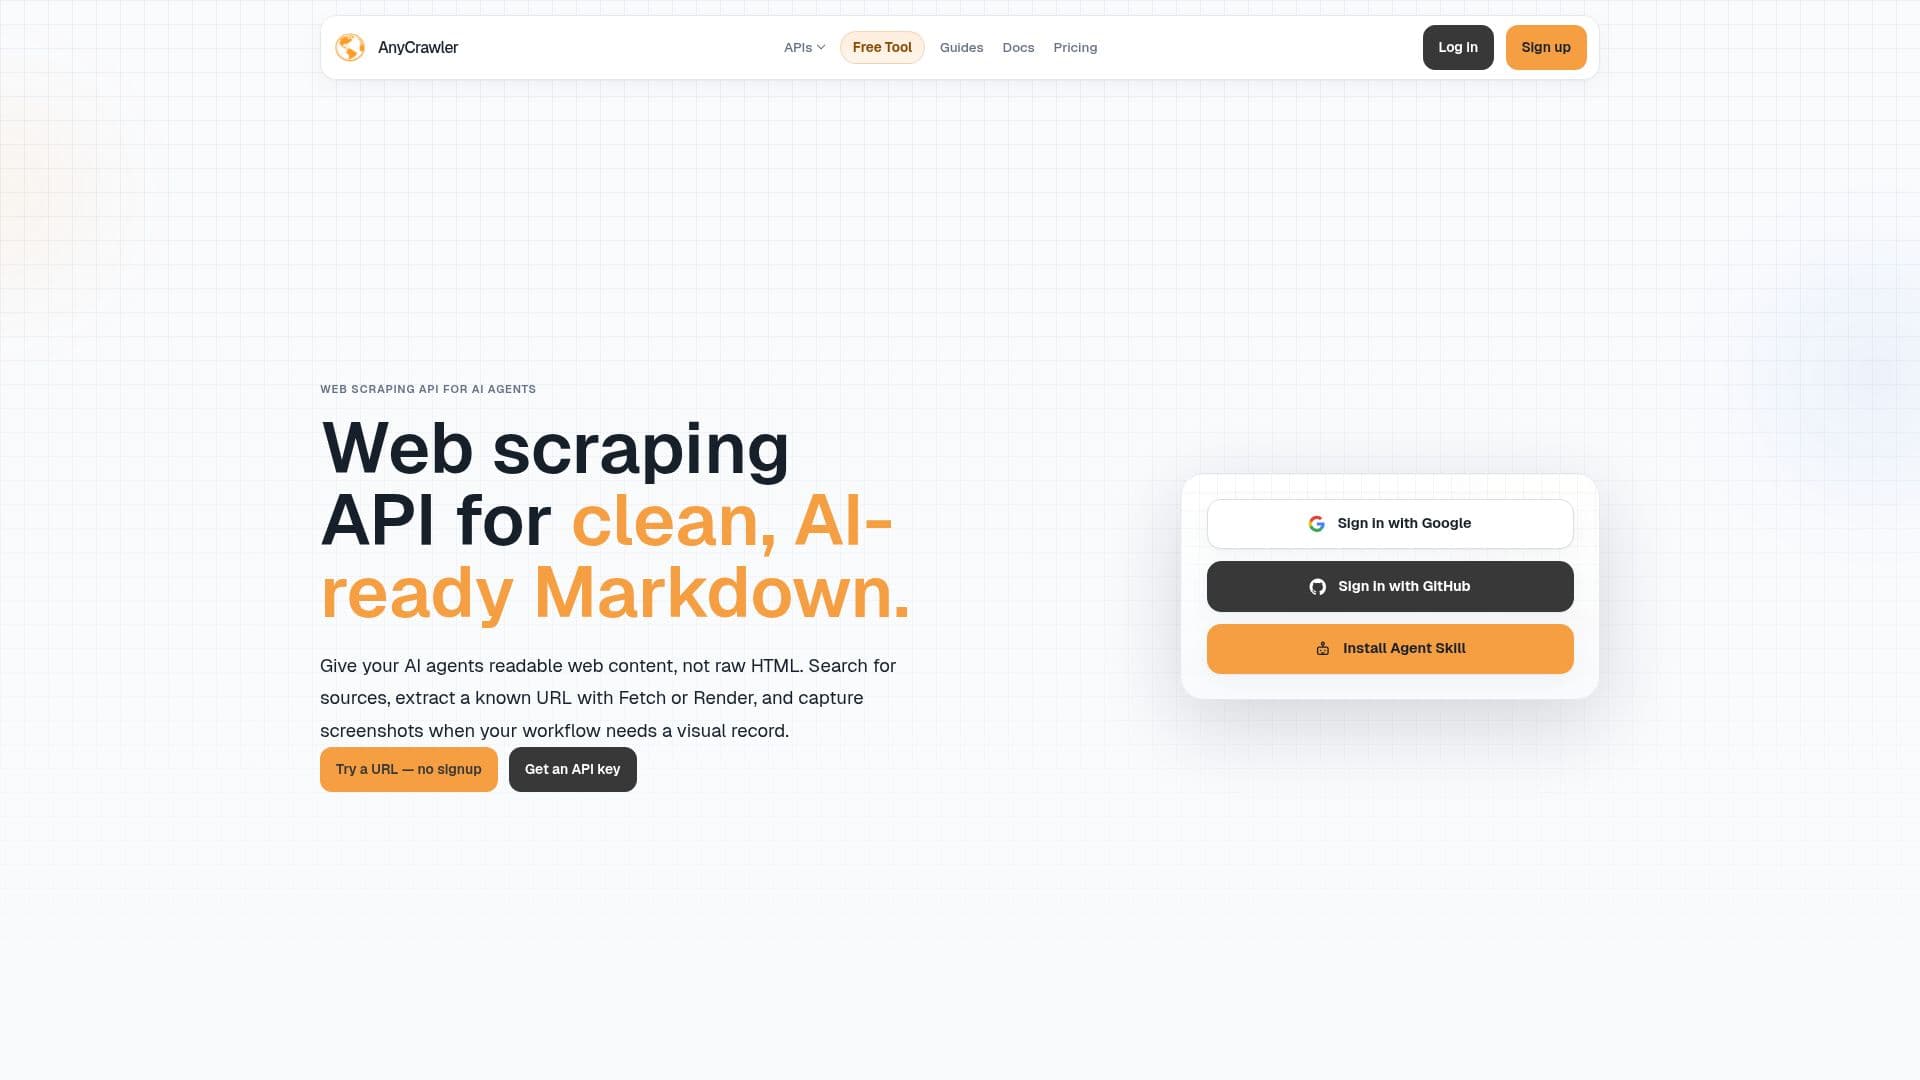
AnyCrawler 提供一个全面的网络爬虫 API,专门为 AI 代理、RAG 系统、研究工具、监控产品和自动化工作流程而设计。它提供了一个统一的解决方案来访问当前的网络数据,消除了用户管理搜索、爬虫、浏览器渲染、解析和使用控制等单独系统的需要。该 API 支持一系列操作,包括搜索源 URL、获取 HTML 优先页面、在浏览器中渲染 JavaScript 重的页面、提取干净的 Markdown 和捕获页面截图。
阅读更多
该平台旨在向 AI 代理提供可读的网络内容,而不是原始 HTML。用户可以根据内容是否在初始 HTML 中可用或需要 JavaScript 执行来选择 Fetch 和 Render 模式。两种模式都返回结构化的 Markdown 输出,确保后续 AI 处理步骤的一致性。此外,AnyCrawler 包含一个网络搜索 API,以发现候选页面、新闻、图像、视频或学术来源,允许用户筛选和选择最相关的结果以进行进一步提取或截图工作流程。
AnyCrawler 采用灵活的基于信用的计费系统,不同的网络访问任务会产生明确的信用成本。该模型允许团队高效地组合能力,而不受固定定价结构的限制。例如,搜索、获取、渲染和截图操作各自具有不同的信用值,确保用户仅为所执行的工作付费。该服务还提供一个免费层,包含 5,000 个一次性信用,使用户能够立即开始爬虫并验证他们的工作流程。
AnyCrawler 为开发人员和团队而建,提供稳定的 API 端点、清晰的响应格式、API 密钥和使用日志,促进从原型到生产的顺利过渡。它旨在简化实时网络访问与 AI 代理的集成,提供一个管理层用于搜索、爬虫、渲染、截图和结构化输出,从而减少自定义浏览器基础设施开发的需求。
- 类别网页抓取与数据提取
- 定价模式免费增值
- 部署云端
- 平台网页版
AnyCrawler的核心功能
为 AI 代理提供的网络爬虫 API
搜索源 URL
获取 HTML 优先页面
渲染 JavaScript 页面
提取干净的 Markdown 输出
捕获页面截图
灵活的基于信用的计费
API 密钥和请求日志
使用控制
为 AI 工作流程提供结构化输出
支持 RAG 系统
开发者友好的 API 文档
包含 5,000 个信用的免费层
提供多种定价计划
浏览器并发插槽
如何使用 AnyCrawler?
注册:创建一个账户以获取 5,000 个免费信用并访问 API。
选择操作:根据您的网络数据需求选择搜索、获取、渲染或截图。
集成 API:使用提供的 API 密钥和文档将 AnyCrawler 集成到您的应用程序或 AI 代理中。
发送请求:进行 API 调用以搜索 URL、提取内容或捕获截图。
处理输出:接收干净的 Markdown 或 PNG 图像,准备好用于您的 AI 工作流程或数据产品。
监控使用情况:通过您的账户仪表板跟踪信用消耗并管理 API 密钥。
扩展工作流程:根据您的需求增长,升级到付费计划以获得更高的每月信用和更高的吞吐量。
AnyCrawler的使用案例
- AI 代理网络访问
- RAG 系统数据来源
- 研究工具开发
- 监控产品
- 自动化工作流程
- 内容提取
- 视觉证据捕获
- 网络发现