描述
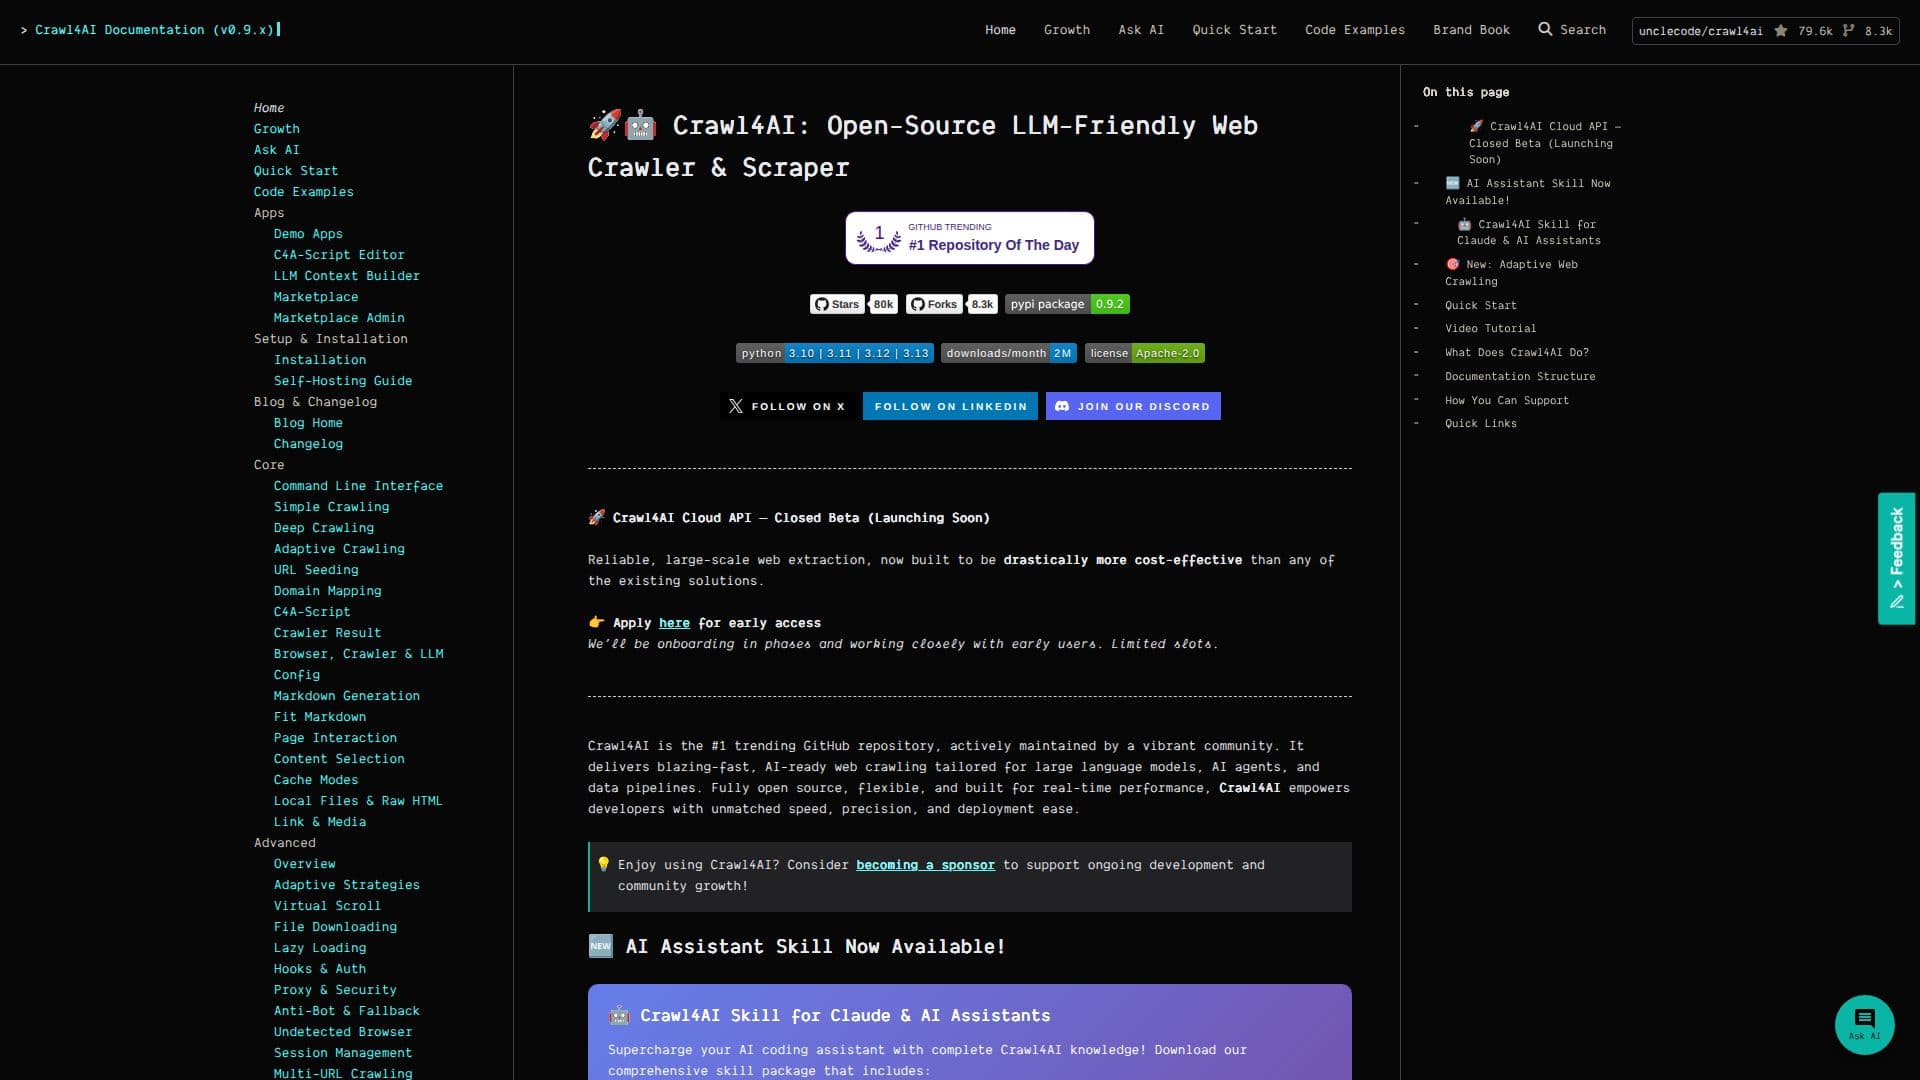
Crawl4AI 是一个开源的、适合大型语言模型的网络爬虫和抓取工具,帮助开发者高效地从网络中提取数据。它为大型语言模型和人工智能代理构建,提供了一种可靠的网页提取解决方案,既经济实惠又易于部署。
阅读更多
该平台由一个充满活力的社区积极维护,并已获得 #1 热门 GitHub 仓库的认可。凭借其闪电般的性能,Crawl4AI 专为实时应用量身定制,是希望将网页抓取集成到数据管道中的开发者的理想选择。
Crawl4AI 的一大亮点是其生成干净 Markdown 的能力,非常适合用于检索增强生成(RAG)管道或直接输入到大型语言模型中。它支持结构化提取,允许用户使用 CSS、XPath 或基于大型语言模型的提取方法解析重复模式。此外,Crawl4AI 提供了高级浏览器控制,具有钩子、代理、隐身模式和会话重用等功能,提供对爬取过程的细粒度控制。
Crawl4AI 还引入了智能自适应爬取,利用先进的信息觅食算法来确定何时收集到足够的信息以回答查询。此功能通过最小化不必要的请求来提高数据收集的效率。
文档结构良好,提供了关于设置、安装和高级功能的清晰部分。用户可以找到动手指南、代码示例和参考资料,帮助他们快速入门。该平台鼓励社区参与,允许用户通过提交拉取请求、报告问题和在 Discord 上加入讨论来贡献。
Crawl4AI 的使命是使数据访问民主化,免费使用并高度可配置。它旨在赋能学生、研究人员、企业家和数据科学家,以快速和创造性的自由访问、解析和塑造世界的数据。
- 类别网页抓取与数据提取
- 定价模式免费
- 部署云端
- 平台跨平台
Crawl4AI的核心功能
开源
适合大型语言模型
自适应爬取
结构化提取
高级浏览器控制
高性能
实时应用案例
无强制 API 密钥
如何使用 Crawl4AI?
配置:通过 pip 或 Docker 设置 Crawl4AI。
使用:使用提供的示例开始您的第一次爬取。
提取:利用结构化提取方法进行数据解析。
优化:实施自适应爬取和会话持久性等高级功能。
Crawl4AI的使用案例
- 数据提取
- 网页抓取
- 研究
- 人工智能训练
- 内容聚合