跳转到主要内容
ToolPotion
AI 顾问
提交(免费)

XCrawl

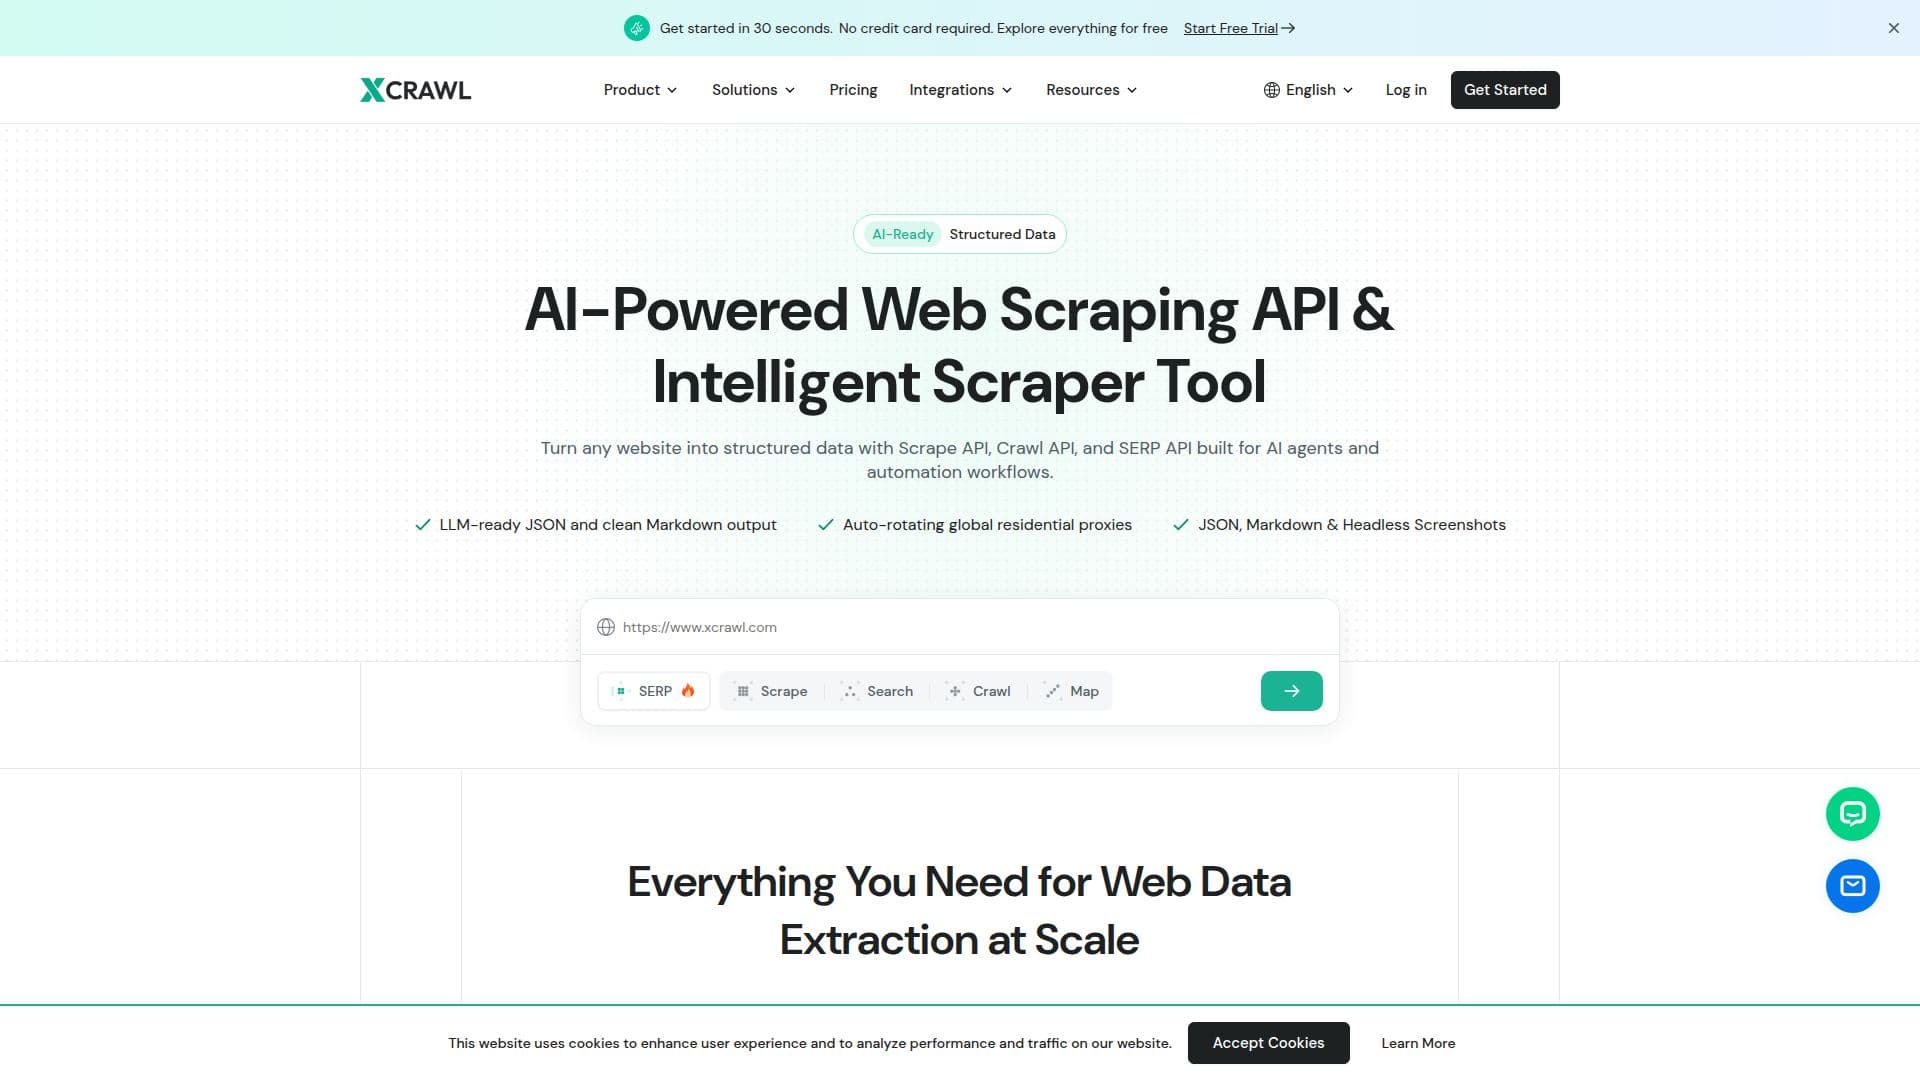
XCrawl 是一个 AI 准备好的网页抓取 API,可以将任何网站转换为结构化的 JSON、Markdown、HTML 或截图,内置代理、爬虫和 SERP 数据,适用于开发者和 AI 代理。

访问URL
分享
XCrawl 截图
XCrawl 截图

XCrawl 是一个网页抓取 API 平台,可以从任何页面提取结构化数据,并在单个请求中返回干净的 JSON、AI 准备好的 Markdown、原始 HTML 或截图。它集成了抓取 API、SERP API、爬虫 API、地图 API 和社交媒体抓取工具,内置住宅代理和反机器人处理,使团队无需自行管理轮换或 CAPTCHA。

阅读更多

该平台专为 AI 和 LLM 工作流而构建,提供高效的 Markdown 以支持 RAG 管道和微调数据集。它支持无头浏览器渲染 JavaScript 重的网站、单页面应用和无限滚动,在关键元素加载后提取数据。原生模型上下文协议(MCP)支持使 AI 助手如 Claude 能够访问实时网络数据,并与 n8n、Zapier 和 Make 的集成实现无代码自动化。

XCrawl 是一个 REST API,支持任何语言,提供 Python 和 Node.js/TypeScript 的官方 SDK,以及 Go、Ruby、PHP 和 cURL 的示例。每个新账户包括 1,000 个免费积分,无需信用卡,请求根据复杂性消耗积分。

  • 类别网页抓取与数据提取
  • 定价模式免费增值
  • 部署云端
  • 平台网页版

  • 基于 AI 的结构化提取到 JSON、Markdown、HTML 或截图

  • 一个平台上的抓取 API、SERP API、爬虫 API 和地图 API

  • 内置住宅代理,具备反机器人和 CAPTCHA 处理功能

  • 针对 JavaScript 重和动态网站的无头浏览器渲染

  • 对 AI 助手如 Claude 的原生 MCP 支持

  • 与 n8n、Zapier 和 Make 的无代码集成

  • 官方 Python 和 Node.js/TypeScript SDK 以及 REST 访问

  • 社交媒体抓取工具和实时数据管道

  1. 创建账户:在 xcrawl.com 注册以获得 1,000 个免费积分,无需信用卡。

  2. 获取 API 密钥:从仪表板复制您的 API 密钥。

  3. 选择端点:根据所需数据选择抓取、搜索、爬虫或地图。

  4. 发送请求:使用 SDK、cURL 或像 n8n 或 Zapier 这样的无代码工具进行首次调用。

  5. 使用输出:在您的应用程序或 AI 工作流中使用返回的 JSON、Markdown、HTML 或截图。

  • LLM 训练数据
  • 潜在客户生成
  • 价格监控
  • SEO 和 SERP 分析
  • 评论挖掘

XCrawl 评价

加载中...

与 XCrawl 类似的热门AI工具

Firecrawl

AI 应用

Firecrawl 是一个上下文 API,可大规模搜索、抓取和交互式处理网络。它将任何网络源转换为干净的 Markdown 或结构化数据,使其能够被 AI 代理轻松使用。通过可靠的、为 LLM 准备好的网络数据为您的 AI 应用提供强大支持。

网页抓取与数据提取
查看工具

AI 应用

上下文 API,可大规模搜索、抓取和交互式处理网络。它将任何网络源转换为干净的 Markdown 或结构化数据,使其能够被 AI 代理轻松使用。通过可靠的、为 LLM 准备好的网络数据为您的 AI 应用提供强大支持。Firecrawl 是一个上下文 API,可大规模搜索、抓取和交互式处理网络。它将任何网络源转换为干净的 Markdown 或结构化数据,使其能够被 AI 代理轻松使用。通过可靠的、为 LLM 准备好的网络数据为您的 AI 应用提供强大支持。

精选网页抓取与数据提取
查看 AI 应用 Top 250

Scrapingdog

AI 应用

Scrapingdog 是一个全方位的网页抓取 API,能够为您管理代理和无头浏览器。它提供 40 多个专用端点,用于一般抓取、谷歌、社交媒体和电子商务数据,按信用系统计费。

网页抓取与数据提取
查看工具

AI 应用

全方位的网页抓取 API,能够为您管理代理和无头浏览器。它提供 40 多个专用端点,用于一般抓取、谷歌、社交媒体和电子商务数据,按信用系统计费。Scrapingdog 是一个全方位的网页抓取 API,能够为您管理代理和无头浏览器。它提供 40 多个专用端点,用于一般抓取、谷歌、社交媒体和电子商务数据,按信用系统计费。

网页抓取与数据提取
查看 AI 应用 Top 250

ScrapeGraphAI

AI 应用

ScrapeGraphAI 是一个基于 AI 的网页抓取 API,使用自然语言提示从网站提取结构化数据。它消除了对代理、选择器和维护的需求,提供与 AI 代理的无缝集成。

网页抓取与数据提取

网页抓取与数据提取 排名第 15 位

查看工具

AI 应用

基于 AI 的网页抓取 API,使用自然语言提示从网站提取结构化数据。它消除了对代理、选择器和维护的需求,提供与 AI 代理的无缝集成。ScrapeGraphAI 是一个基于 AI 的网页抓取 API,使用自然语言提示从网站提取结构化数据。它消除了对代理、选择器和维护的需求,提供与 AI 代理的无缝集成。

网页抓取与数据提取
网页抓取与数据提取 排名第 15 位

WebScraping.AI 提供一个由AI驱动的API,用于从任何网站提取数据。它处理代理、浏览器和验证码,提供干净的HTML、文本或结构化的AI提取数据。非常适合需要可扩展网页抓取而无需管理基础设施的开发者。

网页抓取与数据提取
查看工具

提供一个由AI驱动的API,用于从任何网站提取数据。它处理代理、浏览器和验证码,提供干净的HTML、文本或结构化的AI提取数据。非常适合需要可扩展网页抓取而无需管理基础设施的开发者。WebScraping.AI 提供一个由AI驱动的API,用于从任何网站提取数据。它处理代理、浏览器和验证码,提供干净的HTML、文本或结构化的AI提取数据。非常适合需要可扩展网页抓取而无需管理基础设施的开发者。

网页抓取与数据提取
查看 AI 应用 Top 250

ScrapingBee

AI 应用

ScrapingBee 是一个网络爬虫 API,通过管理代理和无头浏览器简化数据提取,使用户能够高效地专注于收集所需数据。

网页抓取与数据提取
查看工具

AI 应用

网络爬虫 API,通过管理代理和无头浏览器简化数据提取,使用户能够高效地专注于收集所需数据。ScrapingBee 是一个网络爬虫 API,通过管理代理和无头浏览器简化数据提取,使用户能够高效地专注于收集所需数据。

网页抓取与数据提取
查看 AI 应用 Top 250

Crawl4AI

AI 应用

Crawl4AI 是一个开源的、适合大型语言模型的网络爬虫和抓取工具,专为开发者设计。它提供高速数据提取、实时性能和高效网页抓取与自动化的高级功能。

网页抓取与数据提取

网页抓取与数据提取 排名第 8 位

查看工具

AI 应用

开源的、适合大型语言模型的网络爬虫和抓取工具,专为开发者设计。它提供高速数据提取、实时性能和高效网页抓取与自动化的高级功能。Crawl4AI 是一个开源的、适合大型语言模型的网络爬虫和抓取工具,专为开发者设计。它提供高速数据提取、实时性能和高效网页抓取与自动化的高级功能。

网页抓取与数据提取
网页抓取与数据提取 排名第 8 位

ScraperAPI

AI 应用

ScraperAPI 是一个网络爬虫 API,允许用户从任何公共网站收集数据,而无需管理代理、浏览器或验证码的麻烦。它提供 5,000 次免费的 API 调用以供入门。

网页抓取与数据提取
查看工具

AI 应用

网络爬虫 API,允许用户从任何公共网站收集数据,而无需管理代理、浏览器或验证码的麻烦。它提供 5,000 次免费的 API 调用以供入门。ScraperAPI 是一个网络爬虫 API,允许用户从任何公共网站收集数据,而无需管理代理、浏览器或验证码的麻烦。它提供 5,000 次免费的 API 调用以供入门。

网页抓取与数据提取
查看 AI 应用 Top 250

WaterCrawl

AI 应用

WaterCrawl 是一个现代的开源网络爬虫框架,可以将任何网站转换为适合 LLM 的结构化数据。它为开发者而生,结合了智能爬取、内容提取、网络搜索和 AI 驱动的处理。

网页抓取与数据提取

网页抓取与数据提取 排名第 46 位

查看工具

AI 应用

现代的开源网络爬虫框架,可以将任何网站转换为适合 LLM 的结构化数据。它为开发者而生,结合了智能爬取、内容提取、网络搜索和 AI 驱动的处理。WaterCrawl 是一个现代的开源网络爬虫框架,可以将任何网站转换为适合 LLM 的结构化数据。它为开发者而生,结合了智能爬取、内容提取、网络搜索和 AI 驱动的处理。

网页抓取与数据提取
网页抓取与数据提取 排名第 46 位
1/8