설명
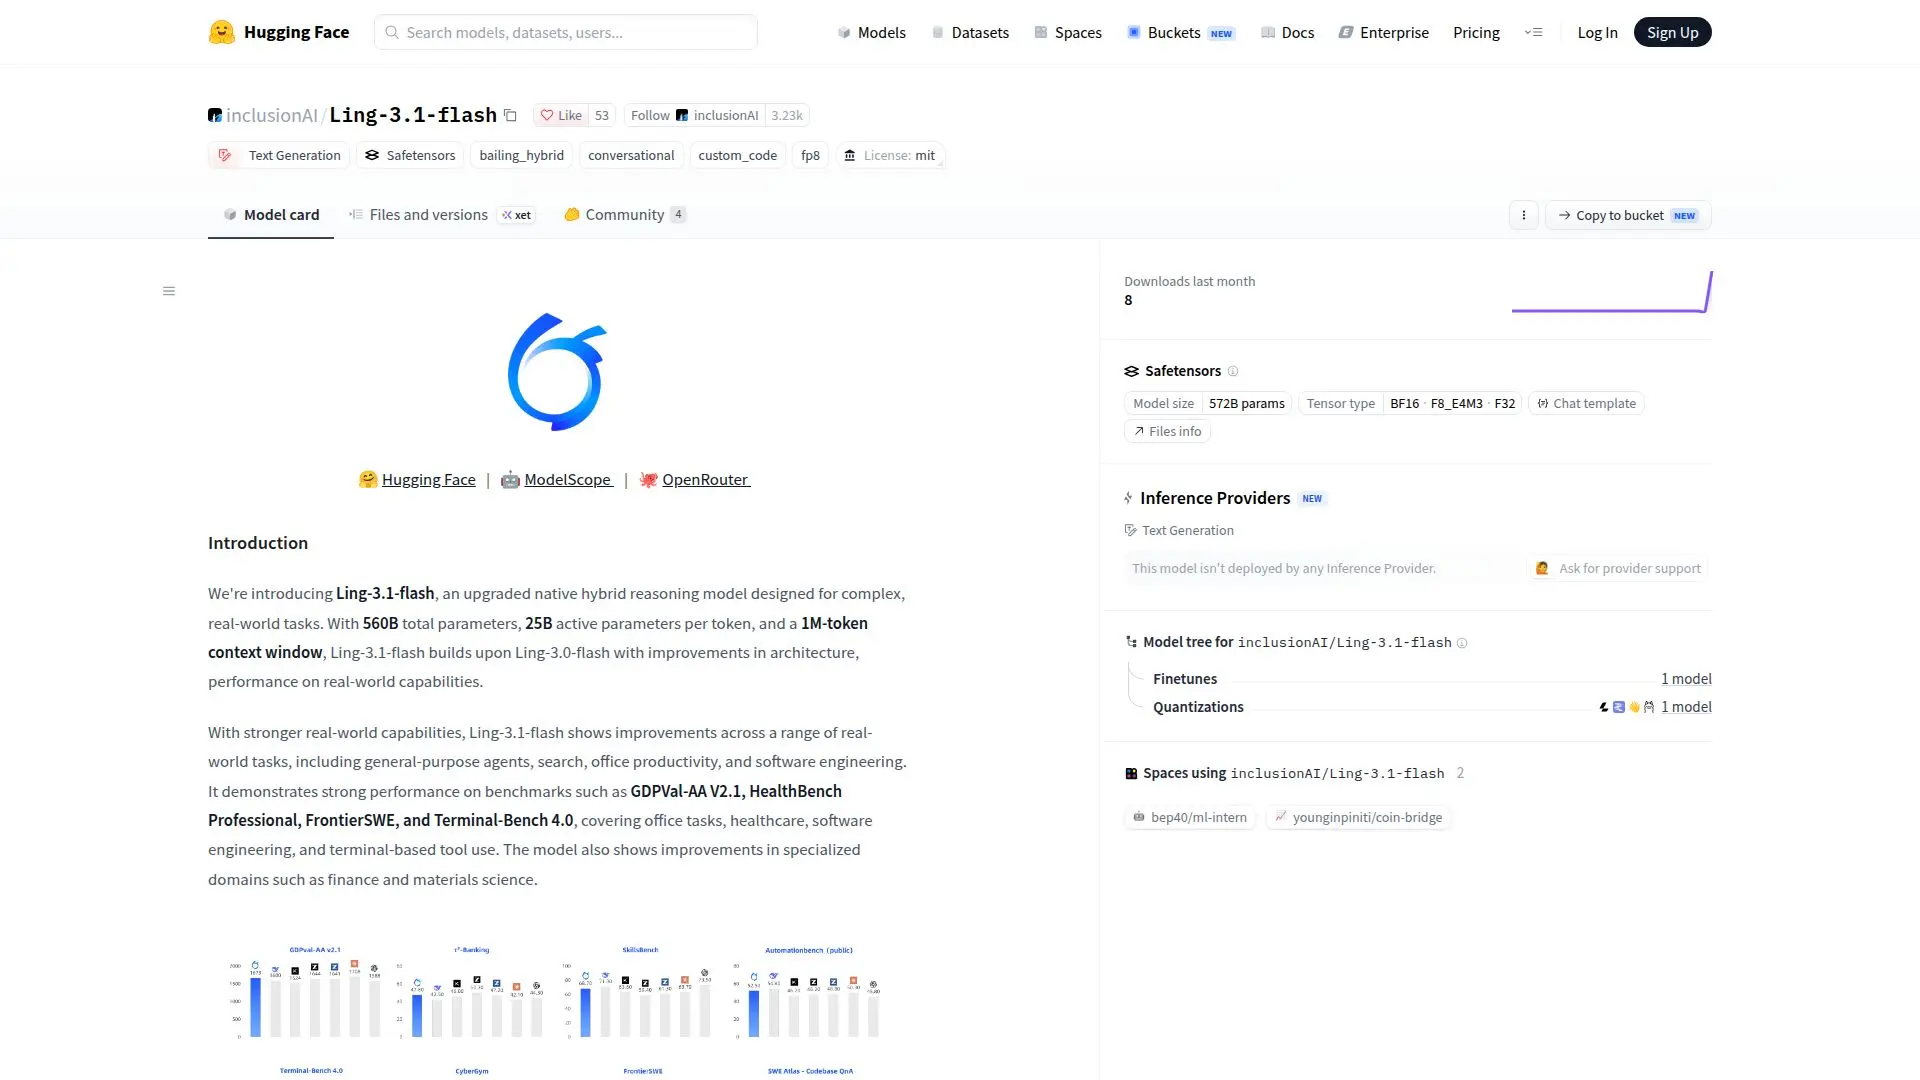
Ling-3.1-flash는 Hugging Face 플랫폼에서 inclusionAI에 의해 소개된 업그레이드된 네이티브 하이브리드 추론 모델입니다. 복잡한 실제 작업을 해결하기 위해 설계된 이 모델은 총 5600억 개의 매개변수를 자랑하며, 토큰당 250억 개의 활성 매개변수와 100만 토큰의 컨텍스트 창을 가지고 있습니다. 이러한 개선 사항은 이전 모델인 Ling-3.0-flash를 기반으로 하여 아키텍처와 성능을 향상시킵니다.
더 읽기
이 모델은 일반 목적의 에이전트, 검색, 사무 생산성 및 소프트웨어 엔지니어링과 같은 다양한 실제 응용 프로그램에서 뛰어난 성능을 발휘합니다. GDPVal-AA V2.1, HealthBench Professional, FrontierSWE 및 Terminal-Bench 4.0과 같은 벤치마크에서 강력한 성능을 입증했습니다. 이러한 벤치마크는 사무 작업, 의료, 소프트웨어 엔지니어링 및 터미널 기반 도구 사용을 포함한 다양한 작업을 다룹니다. 또한 Ling-3.1-flash는 금융 및 재료 과학과 같은 전문 분야에서도 주목할 만한 개선을 보여줍니다.
Ling-3.1-flash의 아키텍처는 하이브리드-선형 전문가 혼합(MoE) 모델을 기반으로 하며, 63 KDA 및 9 Gated MLA 변환기 레이어, 4개의 밀집 레이어 및 512개의 라우팅된 전문가를 특징으로 합니다. 이 모델은 또한 64개의 주의 헤드와 4096의 숨겨진 크기를 가지고 있으며, 어휘 크기는 157,184입니다.
Ling-3.1-flash는 여러 권위 있는 벤치마크에서 평가되어 코딩 및 에이전틱 작업에서 강력한 성능을 보여줍니다. Claude Code, Kilo Code, Qwen Code, Hermes Agent 및 OpenClaw와 같은 프레임워크를 지원합니다. 이 모델은 또한 복잡하고 긴 코딩 작업의 성능을 향상시키는 오픈 소스 코딩 에이전트 Pi를 기반으로 한 하네스인 LingCode를 도입합니다.
시작하려는 사용자에게 권장되는 SGLang 이미지는 Ling-3.1-flash 지원, MTP 추측 디코딩 및 Hopper 디코드 최적화를 포함합니다. 이 모델은 다양한 서버 구성에서 추론을 위해 사용할 수 있으며, 다양한 하드웨어 설정에 대한 검증된 레시피가 제공됩니다.
- 카테고리AI 모델 및 LLM
- 요금제오픈소스
- 배포클라우드
- 플랫폼웹
Ling-3.1-flash 하이라이트
560B 총 매개변수
1M 토큰 컨텍스트 창
하이브리드-선형 MoE 아키텍처
63 KDA + 9 Gated MLA 레이어
512개의 라우팅된 전문가
64개의 주의 헤드
여러 프레임워크 지원
강력한 벤치마크 성능
Ling-3.1-flash 시작하기
모델 페이지에 접근: Hugging Face 방문
인증: 계정에 로그인
구성: 서버 또는 클라이언트 환경 설정
프롬프트 전송: 추론을 위한 검증된 레시피 사용
Ling-3.1-flash의 사용 사례
- 일반 목적의 에이전트
- 사무 생산성
- 소프트웨어 엔지니어링
- 의료 응용 프로그램
- 재무 분석