

설명
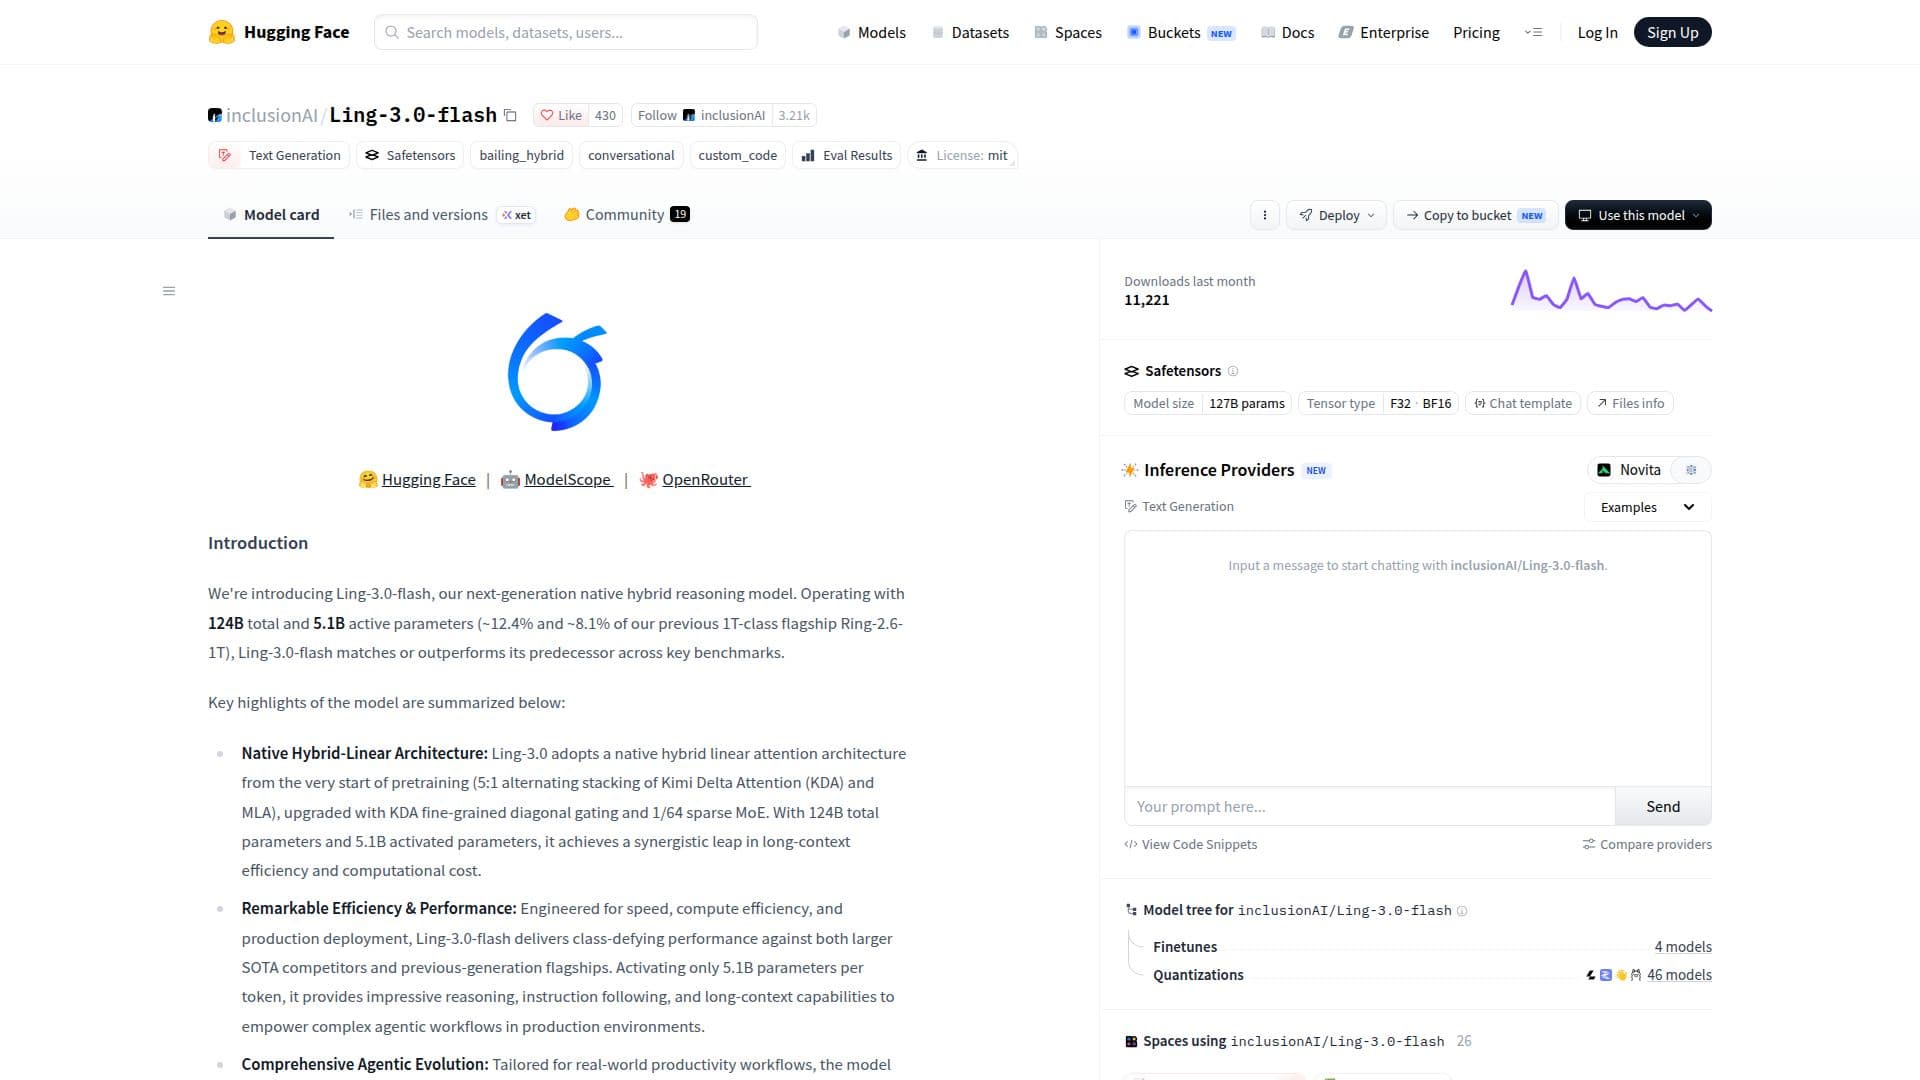
Ling-3.0-flash는 inclusionAI에 의해 개발되고 Hugging Face에 호스팅되는 최첨단 하이브리드 추론 모델입니다. 총 1240억 개의 매개변수로 운영되며, 토큰당 51억 개가 활성화되어 있어 놀라운 효율성과 성능을 제공합니다. 이 모델은 Kimi Delta Attention(KDA)와 MLA를 특징으로 하는 네이티브 하이브리드 선형 주의 아키텍처를 채택하고 있으며, 세밀한 대각선 게이팅과 희소 MoE로 업그레이드되었습니다. 이 아키텍처는 Ling-3.0-flash가 긴 맥락 효율성과 계산 비용에서 시너지 효과를 달성할 수 있게 합니다.
더 읽기
속도와 계산 효율성을 위해 설계된 Ling-3.0-flash는 더 큰 최첨단 경쟁자 및 이전 세대 플래그십 모델에 비해 뛰어난 성능을 제공합니다. 이 모델은 생산 환경에서 복잡한 에이전트 작업 흐름을 지원하며, 토큰당 51억 개의 매개변수만 활성화합니다. 모델은 코딩, 일반 및 심층 연구 에이전트 작업 전반에 걸쳐 엔드 투 엔드 폐쇄 루프 실행을 달성하기 위해 10,000개 이상의 상호작용 훈련 환경을 통합합니다.
Ling-3.0-flash는 물리적 이중 풀과 클러스터 공유 L3 캐시를 특징으로 하는 SGLang HiCache + Mooncake 계층 캐싱 아키텍처를 통합합니다. 이 설정은 긴 수평 상호작용 중 중복 재계산을 제거하여 긴 입력 시나리오에서 첫 번째 토큰까지의 시간(TTFT)을 60%에서 80% 이상 단축합니다. 이 모델은 SWE-Bench Pro, SWE-Bench Multilingual, Tau3-banking-AA, MCP-Atlas 및 SkillsBench를 포함한 여러 권위 있는 벤치마크에서 강력한 성능을 발휘합니다.
이 모델은 실제 생산성 작업 흐름에 맞춰 조정되어 일반 지식, 수학적 추론, 지시 따르기 및 긴 맥락 이해에서 강력한 성능을 제공합니다. Ling-3.0-flash는 생산 배포를 위해 설계되었으며, 인상적인 추론 능력과 긴 맥락 효율성을 제공하여 복잡한 에이전트 작업 흐름에 적합합니다.
- 카테고리AI 모델 및 LLM
- 요금제프리미엄
- 배포클라우드
- 플랫폼웹
Ling-3.0-flash 하이라이트
네이티브 하이브리드-선형 아키텍처
놀라운 효율성 및 성능
포괄적인 에이전트 진화
SGLang HiCache + Mooncake 캐싱
엔드 투 엔드 폐쇄 루프 실행
긴 맥락 효율성
지시 따르기
수학적 추론
Ling-3.0-flash 시작하기
모델 페이지에 접근하기: Hugging Face 방문
인증하기: 계정에 로그인
구성하기: 매개변수 및 기본 설정 설정
프롬프트 전송하기: 쿼리 입력
미세 조정하기: 모델 설정 조정
Ling-3.0-flash의 사용 사례
- 코딩 작업
- 연구 에이전트
- 지시 따르기
- 긴 맥락 이해
- 수학적 추론







