설명
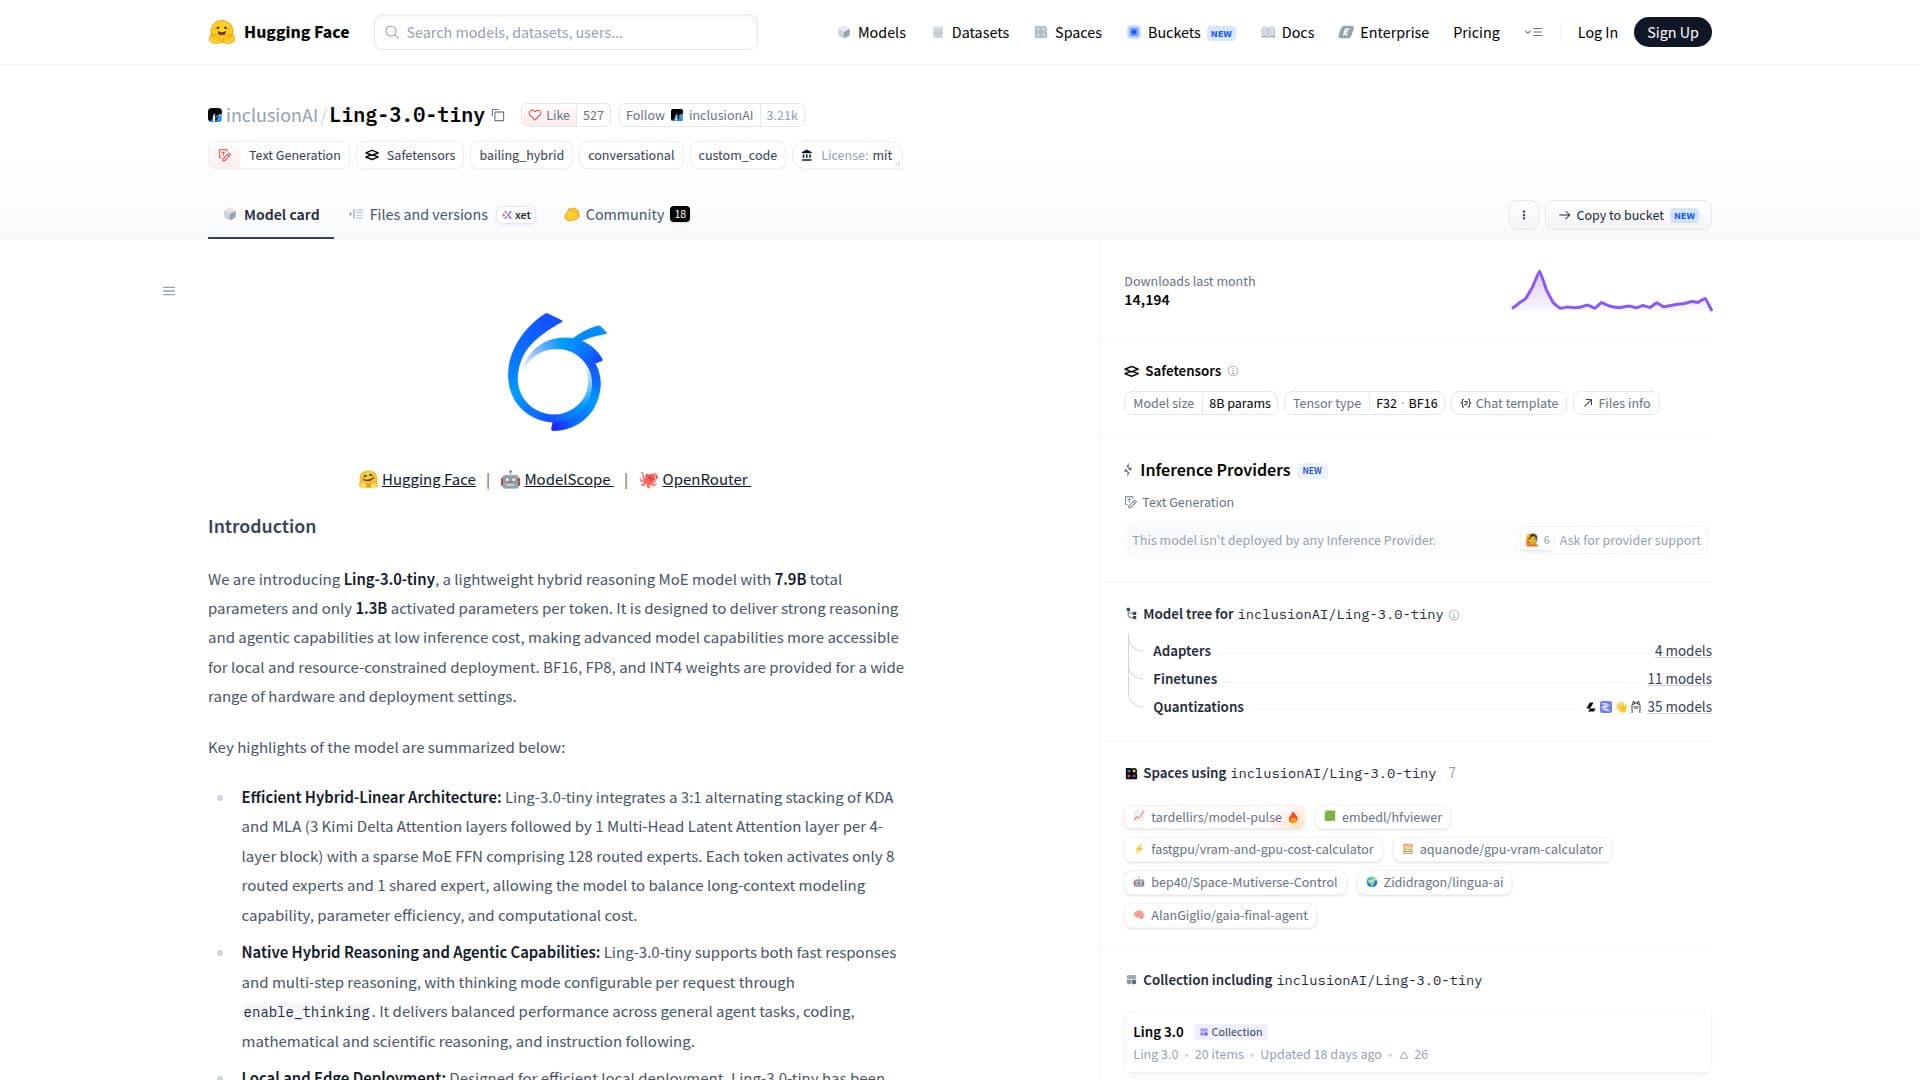
Ling-3.0-tiny는 inclusionAI에 의해 개발된 경량 하이브리드 추론 모델로, Hugging Face에서 호스팅됩니다. 총 79억 개의 매개변수를 특징으로 하며, 토큰당 13억 개만 활성화되어 로컬 및 자원이 제한된 배포에 효율적입니다. 이 모델은 Kimi Delta Attention (KDA)와 Multi-Head Latent Attention (MLA) 레이어의 3:1 교대 스태킹과 128개의 라우팅된 전문가로 구성된 희소 Mixture of Experts (MoE) Feed-Forward Network (FFN)를 통합하여 긴 컨텍스트 모델링 능력, 매개변수 효율성 및 계산 비용의 균형을 맞춥니다.
더 읽기
Ling-3.0-tiny는 낮은 추론 비용으로 강력한 추론 및 에이전트 기능을 제공하도록 설계되었습니다. 빠른 응답과 다단계 추론을 지원하며, 구성 가능한 사고 모드를 갖추고 있습니다. 이 모델은 NVIDIA DGX Spark 및 Apple Silicon MacBook을 포함한 다양한 하드웨어에서 검증되어 데이터 센터급 GPU 없이도 유능한 추론 및 에이전트 작업을 수행할 수 있습니다. FP8을 사용하여 DGX Spark에서 초당 약 100-105 토큰, M4 Pro MacBook에서 초당 86-90 토큰을 달성하며, 8K 컨텍스트 길이에서 약 8.34 GiB의 피크 메모리 사용량을 기록합니다.
모델의 효율성은 Artificial Analysis Intelligence Index v4.1.1에서 25점을 기록하고, Artificial Analysis Agentic Index에서 16점을 기록함으로써 강조됩니다. 500 토큰 응답에 대해 약 18초의 종단 간 지연 시간으로 초당 160개 이상의 토큰 출력 속도를 달성합니다. Ling-3.0-tiny는 에이전트 작업, 코딩, 긴 컨텍스트 이해, 지식 신뢰성, 수학적 및 과학적 추론, 지시 사항 따르기 등 다양한 작업에 적합합니다.
- 카테고리AI 모델 및 LLM
- 요금제프리미엄
- 배포로컬 실행
- 플랫폼웹
Ling-3.0-tiny 하이라이트
총 79억 개의 매개변수
토큰당 13억 개의 활성화된 매개변수
하이브리드 추론 기능
효율적인 로컬 배포
3:1 KDA-MLA 아키텍처
128명의 전문가가 포함된 희소 MoE FFN
빠른 응답 및 다단계 추론 지원
NVIDIA DGX Spark 및 Apple Silicon에서 검증됨
Ling-3.0-tiny 시작하기
모델 페이지에 접근: Hugging Face 방문
인증: 계정에 로그인
구성: 모델 매개변수 설정
프롬프트 전송: 추론을 위해 모델 사용
미세 조정: 특정 작업에 맞게 설정 조정
Ling-3.0-tiny의 사용 사례
- 에이전트 작업
- 코딩
- 과학적 추론
- 지시 사항 따르기
- 로컬 배포