설명
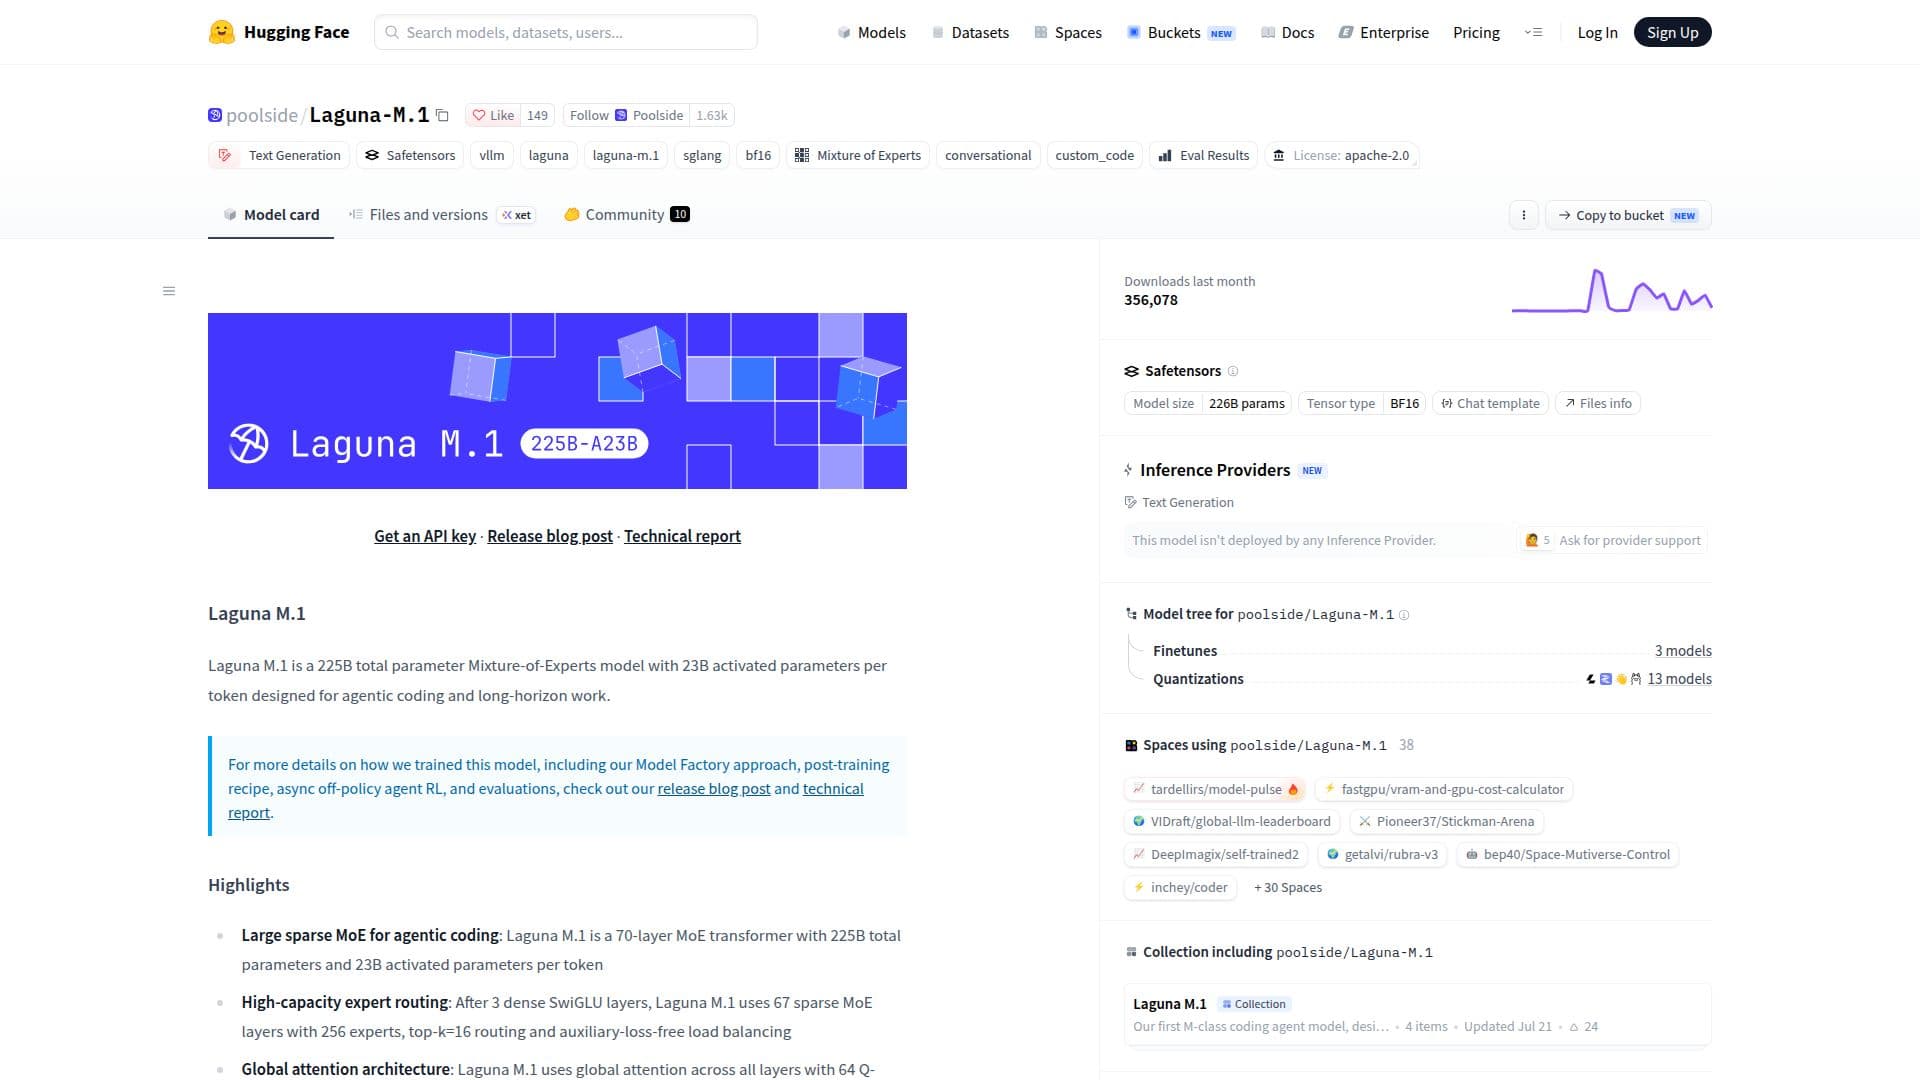
Laguna M.1은 에이전틱 코딩 및 장기 작업을 위해 개발된 정교한 혼합 전문가(MoE) 모델입니다. 총 2250억 개의 매개변수와 토큰당 230억 개의 활성화된 매개변수를 갖춘 이 모델은 복잡한 계산 작업을 효율적으로 처리하도록 설계되었습니다. 이 모델은 70개의 레이어로 구성되어 있으며, 256명의 전문가가 있는 67개의 희소 MoE 레이어를 포함하고 있으며, 높은 용량의 전문가 라우팅 메커니즘을 활용합니다. 이러한 설계는 top-k=16 라우팅 및 보조 손실 없는 로드 밸런싱을 가능하게 하여 계산 효율성을 향상시킵니다.
더 읽기
모델은 모든 레이어에서 글로벌 주의 아키텍처를 사용하며, 64개의 Q-헤드와 8개의 KV-헤드를 특징으로 하며, 소프트플러스 주의 출력 게이팅을 제공합니다. 이 설정은 도구 호출 간의 교차 사고를 가능하게 하는 기본적인 추론 기능을 지원하며, 요청에 따라 활성화하거나 비활성화할 수 있습니다. Laguna M.1은 SWE-bench Verified, SWE-bench Multilingual, SWE-Bench Pro 및 Terminal-Bench 2.0을 포함한 여러 벤치마크에서 강력한 성능을 보여주어 최신 모델들과 경쟁력을 갖추고 있습니다.
Laguna M.1은 Apache 2.0 라이선스 하에 라이선스가 부여되어 상업적 및 비상업적 목적으로 자유롭게 사용 및 수정할 수 있습니다. NVIDIA와의 협업 덕분에 vLLM, SGLang, Transformers 및 TRT-LLM을 포함한 다양한 플랫폼에서 지원됩니다. 이 모델은 소프트웨어 엔지니어링 및 에이전틱 코딩 사용 사례를 위해 설계되었으며, 성능 최적화를 위해 메시지 기록에서의 추론을 보존하는 데 중점을 두고 있습니다.
사용자는 vLLM 또는 SGLang을 사용하여 Laguna M.1을 로컬로 배포할 수 있으며, 도구 호출, 스트리밍 응답 및 추론 파싱을 지원합니다. 이 모델은 다양한 배포 요구를 수용하기 위해 FP8 및 NVFP4와 같은 양자화된 형식으로도 제공됩니다. 그 기능을 탐색하고자 하는 분들은 vLLM 및 SGLang과 같은 플랫폼을 통해 Laguna M.1에 접근할 수 있으며, 각 문서에서 자세한 배포 지침을 확인할 수 있습니다.
- 카테고리AI 모델 및 LLM
- 요금제오픈소스
- 배포클라우드, 셀프 호스팅
- 플랫폼웹, macOS, Linux
Laguna M.1 하이라이트
총 225B 매개변수
토큰당 23B 활성화된 매개변수
70층 MoE 변환기
top-k=16 라우팅을 가진 256명의 전문가
글로벌 주의 아키텍처
기본 추론 지원
Apache 2.0 라이선스
강력한 벤치마크 성능
Laguna M.1 시작하기
모델 페이지에 접근: Laguna M.1의 Hugging Face 페이지를 방문하세요.
인증: 접근을 위한 API 키를 얻으세요.
구성: 원하는 매개변수로 모델을 설정하세요.
프롬프트 전송: 텍스트-투-텍스트 작업에 모델을 사용하세요.
미세 조정: 특정 사용 사례에 맞게 모델을 조정하세요.
Laguna M.1의 사용 사례
- 에이전틱 코딩
- 장기 작업
- 벤치마크 테스트
- 도구 통합
- 연구 및 개발