メインコンテンツへスキップ
ToolPotion
AI アドバイザー
送信(無料)

GLiDE 27B

LLMAIモデルとLLM営業に問い合わせ · Web

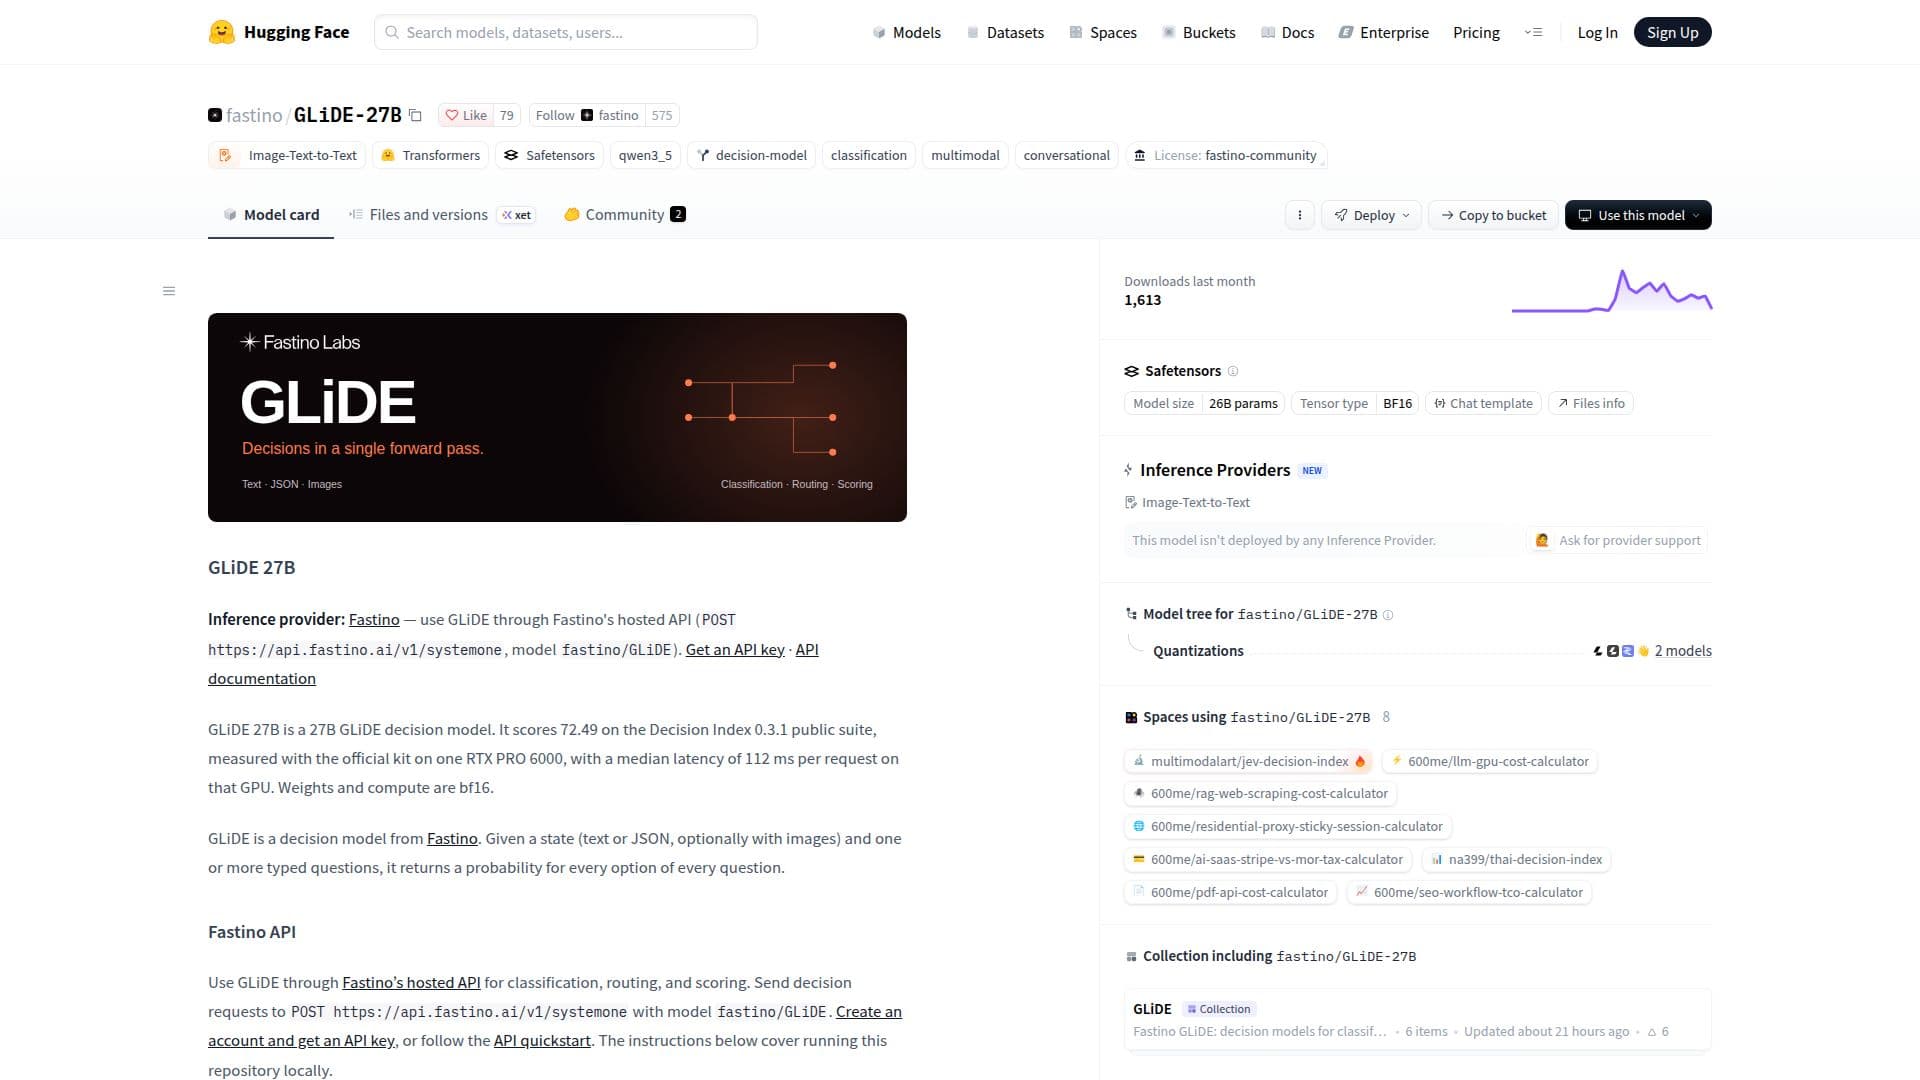
GLiDE 27Bは、Fastinoによって開発された270億パラメータの意思決定モデルです。テキスト、JSON、およびオプションの画像を含む状態を処理し、各オプションの確率を伴って入力された質問に回答します。このモデルは、分類、ルーティング、スコアリングタスクに最適であり、さまざまな意思決定アプリケーションに対して正確で非生成的な確率出力を提供します。

URLを訪問
共有
GLiDE 27B のスクリーンショット

GLiDE 27Bは、Fastinoによって開発された高度な270億パラメータの意思決定モデルであり、多様な入力状態に基づいて入力された質問に確率的な回答を提供するように設計されています。このモデルは、テキスト生成ではなく、正確な分類、ルーティング、スコアリングを必要とするシナリオで優れた性能を発揮します。テキスト、JSON、および画像を含む入力状態を処理し、包括的な意思決定分析のためのマルチモーダル機能を提供します。

続きを読む

ユーザーは、FastinoがホストするAPIを介してGLiDE 27Bと対話でき、POSTエンドポイントを介して意思決定リクエストをサポートします。このAPIは、255の名前付きオプションから1つを選択する「選択」や、P(はい)を返す「ノール」、順序付けられたレベルを割り当てる「スコア」など、さまざまな質問タイプをサポートしています。各質問に対して、GLiDE 27Bは255方向の意思決定リードアウトから導出されたすべての可能なオプションの確率を返し、生成的なテキストは生成されません。

このモデルは効率性を考慮して設計されており、各質問ごとに1回のフォワードパスを実行し、リクエスト内のすべての質問をスコアリングし、マイクロバッチで同時リクエストを処理します。デフォルトで、状態、質問、オプション、および画像トークンを含む最大40,000トークンの長いコンテキストをサポートします。インターフェースは、Python APIおよびSystem Oneフォーマットを使用して通信するHTTPサーバーを介して利用可能です。

GLiDE 27Bはbf16ウェイトで動作し、80GB以上のメモリを持つGPU(例:NVIDIA RTX PRO 6000 Blackwell Server Edition)を必要とします。このハードウェア上でのリクエストあたりの中央値のレイテンシは112msを示しています。モデルのアーキテクチャには、51.2GBの言語モデル、0.92GBのビジョンエンコーダー、および2.6MBのリードアウトが含まれています。Fastinoは、簡単な統合と展開のためにAPIキーシステムとドキュメントを提供しています。このモデルはFastinoコミュニティライセンスの下でライセンスされており、サードパーティのコンポーネントは元のライセンスを保持します。

  • カテゴリーAIモデルとLLM
  • 料金モデル営業に問い合わせ
  • デプロイクラウド
  • プラットフォームWeb

  • 270億パラメータ

  • 画像-テキストからテキストへの意思決定モデル

  • 入力された意思決定質問(選択、ノール、スコア)

  • すべてのオプションに対する確率出力

  • テキスト生成なし(非生成的)

  • マルチモーダル入力(テキスト、JSON、画像)

  • 長いコンテキストサポート(最大40,000トークン)

  • Python APIおよびHTTPサーバーインターフェース

  • 効率のためのマイクロバッチ処理

  • bf16ウェイトおよび計算

  • 80GB以上のGPUメモリが必要

  • FastinoホストAPIが利用可能

  • APIキー認証

  • インライン画像をサポート(データURL、Base64)

  • バッチ処理と同時実行の設定可能

  1. APIキーを取得する:FastinoからAPIキーを取得して、ホストされたGLiDE APIにアクセスします。

  2. リクエストを準備する:状態(テキスト、JSON、または画像を含むマルチモーダル)と1つ以上の入力された質問をフォーマットします。

  3. リクエストを送信する:Fastino APIエンドポイント(POST https://api.fastino.ai/v1/systemone)を使用し、モデル`fastino/GLiDE`を指定します。

  4. レスポンスを受け取る:最も可能性の高い選択肢、ノール確率、またはスコアとともに、すべてのオプションの確率を含むレスポンスを受け取ります。

  5. ローカルで統合する(オプション):リポジトリの指示に従って、PythonまたはHTTPサーバーを使用してGLiDE 27Bをローカルで実行します。

  • 分類タスク
  • 意思決定ルーティング
  • スコアリングシステム
  • マルチモーダル分析
  • 感情分析
  • コンテンツモデレーション
  • カスタマーサポートトリアージ
  • 調査分析

GLiDE 27B のレビュー

読み込み中...

GLiDE 27B に似た人気のAIツール

GLiDEはFastinoによって開発された内部使用のための意思決定モデルです。テキスト、JSON、画像を処理し、さまざまな意思決定オプションの確率を返します。FastinoのAPIを介してアクセス可能で、分類、ルーティング、スコアリングタスクをサポートします。

AIモデルとLLM
ツールを見る

Fastinoによって開発された内部使用のための意思決定モデルです。テキスト、JSON、画像を処理し、さまざまな意思決定オプションの確率を返します。FastinoのAPIを介してアクセス可能で、分類、ルーティング、スコアリングタスクをサポートします。GLiDEはFastinoによって開発された内部使用のための意思決定モデルです。テキスト、JSON、画像を処理し、さまざまな意思決定オプションの確率を返します。FastinoのAPIを介してアクセス可能で、分類、ルーティング、スコアリングタスクをサポートします。

AIモデルとLLM
LLM トップ50を見る

d3-ultra

AI モデル

d3-ultraは、vLLM Semantic Routerからの27Bマルチモーダル意思決定モデルです。テキスト、JSON、画像、動画を処理して、確率を用いて質問に回答します。複雑な意思決定タスクに最適で、1つの質問につき最大131,072トークンをサポートし、テスト用の無料APIを提供します。

AIモデルとLLM
ツールを見る

AI モデル

vLLM Semantic Routerからの27Bマルチモーダル意思決定モデルです。テキスト、JSON、画像、動画を処理して、確率を用いて質問に回答します。複雑な意思決定タスクに最適で、1つの質問につき最大131,072トークンをサポートし、テスト用の無料APIを提供します。d3-ultraは、vLLM Semantic Routerからの27Bマルチモーダル意思決定モデルです。テキスト、JSON、画像、動画を処理して、確率を用いて質問に回答します。複雑な意思決定タスクに最適で、1つの質問につき最大131,072トークンをサポートし、テスト用の無料APIを提供します。

AIモデルとLLM
AI モデル トップ5を見る

d3-turbo

AI モデル

d3-turboは、vLLMセマンティックルーターからの高度な27Bマルチモーダル意思決定モデルです。テキスト、JSON、画像、動画を処理して確率を伴う回答を提供し、効率的な意思決定能力を提供します。

AIモデルとLLM
ツールを見る

AI モデル

vLLMセマンティックルーターからの高度な27Bマルチモーダル意思決定モデルです。テキスト、JSON、画像、動画を処理して確率を伴う回答を提供し、効率的な意思決定能力を提供します。d3-turboは、vLLMセマンティックルーターからの高度な27Bマルチモーダル意思決定モデルです。テキスト、JSON、画像、動画を処理して確率を伴う回答を提供し、効率的な意思決定能力を提供します。

AIモデルとLLM
AI モデル トップ5を見る

d1-2Bは、テキスト、画像、動画分析のために設計されたLFM3-VL-2Bに基づく意思決定モデルです。トークンを生成することなく、単一のフォワードパスでキャリブレーションされた回答を提供します。このモデルは、分類を超えた能力を提供し、テキスト抽出、オブジェクトの位置特定、数量推定を含むさまざまな意思決定ベンチマークで優れた性能を発揮します。多様なアプリケー…

AIモデルとLLM
ツールを見る

テキスト、画像、動画分析のために設計されたLFM3-VL-2Bに基づく意思決定モデルです。トークンを生成することなく、単一のフォワードパスでキャリブレーションされた回答を提供します。このモデルは、分類を超えた能力を提供し、テキスト抽出、オブジェクトの位置特定、数量推定を含むさまざまな意思決定ベンチマークで優れた性能を発揮します。多様なアプリケー…d1-2Bは、テキスト、画像、動画分析のために設計されたLFM3-VL-2Bに基づく意思決定モデルです。トークンを生成することなく、単一のフォワードパスでキャリブレーションされた回答を提供します。このモデルは、分類を超えた能力を提供し、テキスト抽出、オブジェクトの位置特定、数量推定を含むさまざまな意思決定ベンチマークで優れた性能を発揮します。多様なアプリケー…

AIモデルとLLM
LLM トップ50を見る

Sarvam-Prism

AI モデル

Sarvam-Prismは、テキスト分類のために設計されたSarvam-105Bに基づく意思決定モデルです。コンテキストと複数の質問を受け取り、それぞれに事前定義された回答があり、単一のパスで各オプションの確率を返します。このモデルはテキストを生成せず、常に提供された選択肢から回答を選択するため、構造化された意思決定タスクに最適です。

AIモデルとLLM
ツールを見る

AI モデル

テキスト分類のために設計されたSarvam-105Bに基づく意思決定モデルです。コンテキストと複数の質問を受け取り、それぞれに事前定義された回答があり、単一のパスで各オプションの確率を返します。このモデルはテキストを生成せず、常に提供された選択肢から回答を選択するため、構造化された意思決定タスクに最適です。Sarvam-Prismは、テキスト分類のために設計されたSarvam-105Bに基づく意思決定モデルです。コンテキストと複数の質問を受け取り、それぞれに事前定義された回答があり、単一のパスで各オプションの確率を返します。このモデルはテキストを生成せず、常に提供された選択肢から回答を選択するため、構造化された意思決定タスクに最適です。

AIモデルとLLM
AI モデル トップ5を見る

LiquidAI d1-omni-600Mは、テキスト、画像、音声に対する単一パスの意思決定のために設計された600Mパラメータの意思決定モデルです。マルチモーダル入力を効率的に処理し、出力トークンを生成することなく迅速かつ正確な応答を提供します。

AIモデルとLLM
ツールを見る

テキスト、画像、音声に対する単一パスの意思決定のために設計された600Mパラメータの意思決定モデルです。マルチモーダル入力を効率的に処理し、出力トークンを生成することなく迅速かつ正確な応答を提供します。LiquidAI d1-omni-600Mは、テキスト、画像、音声に対する単一パスの意思決定のために設計された600Mパラメータの意思決定モデルです。マルチモーダル入力を効率的に処理し、出力トークンを生成することなく迅速かつ正確な応答を提供します。

AIモデルとLLM
LLM トップ50を見る

Clef

AI モデル

Clefは、タイプ付き質問の状態とスキーマを意思決定に変換するために設計された27Bのマルチモーダルモデルです。テキスト、JSON、画像、またはビデオなどの入力を処理し、各質問のすべての選択肢に対する確率を単一のフォワードパスで返します。

AIモデルとLLM
ツールを見る

AI モデル

タイプ付き質問の状態とスキーマを意思決定に変換するために設計された27Bのマルチモーダルモデルです。テキスト、JSON、画像、またはビデオなどの入力を処理し、各質問のすべての選択肢に対する確率を単一のフォワードパスで返します。Clefは、タイプ付き質問の状態とスキーマを意思決定に変換するために設計された27Bのマルチモーダルモデルです。テキスト、JSON、画像、またはビデオなどの入力を処理し、各質問のすべての選択肢に対する確率を単一のフォワードパスで返します。

AIモデルとLLM
AI モデル トップ5を見る

ej

AI アプリ

ejは、CPU上でのルーティングおよびトリアージタスクのために設計されたコンパクトな意思決定モデルです。テキストベースのクエリを処理し、確率に基づく回答を提供します。ファイルサイズは11 MBで、APIやGPUは不要なため、オフラインでの使用に適しています。

AIモデルとLLM
ツールを見る

AI アプリ

CPU上でのルーティングおよびトリアージタスクのために設計されたコンパクトな意思決定モデルです。テキストベースのクエリを処理し、確率に基づく回答を提供します。ファイルサイズは11 MBで、APIやGPUは不要なため、オフラインでの使用に適しています。ejは、CPU上でのルーティングおよびトリアージタスクのために設計されたコンパクトな意思決定モデルです。テキストベースのクエリを処理し、確率に基づく回答を提供します。ファイルサイズは11 MBで、APIやGPUは不要なため、オフラインでの使用に適しています。

AIモデルとLLM
AI アプリ トップ250を見る
1 / 8