メインコンテンツへスキップ
ToolPotion
AI アドバイザー
送信(無料)

d1-2B

LLMAIモデルとLLMオープンソース · Web

d1-2Bは、テキスト、画像、動画分析のために設計されたLFM3-VL-2Bに基づく意思決定モデルです。トークンを生成することなく、単一のフォワードパスでキャリブレーションされた回答を提供します。このモデルは、分類を超えた能力を提供し、テキスト抽出、オブジェクトの位置特定、数量推定を含むさまざまな意思決定ベンチマークで優れた性能を発揮します。多様なアプリケーションにおける迅速な意思決定のために最適化されています。

URLを訪問
共有
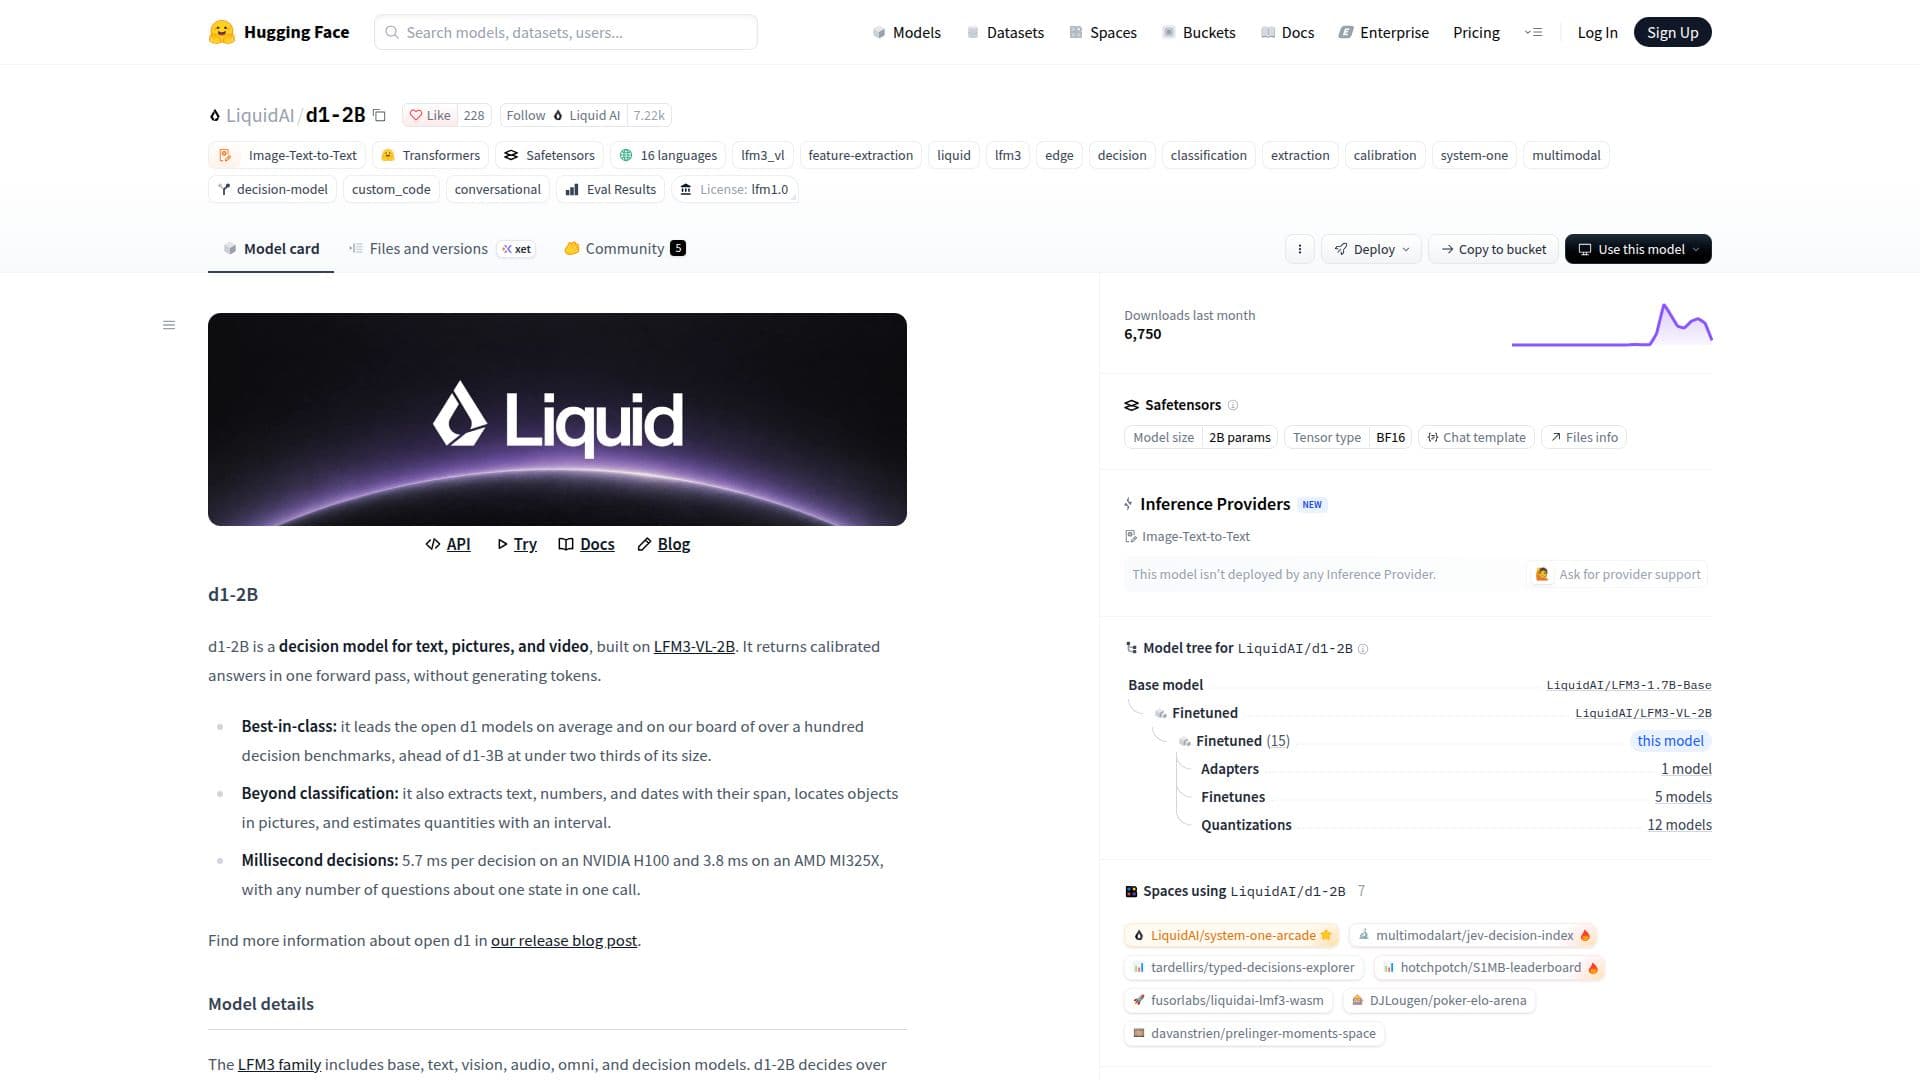
d1-2B のスクリーンショット
d1-2B のスクリーンショット

d1-2Bは、LiquidAIによって開発された非常に効率的な意思決定モデルで、Hugging Faceで利用可能です。LFM3-VL-2Bアーキテクチャに基づいて構築されており、テキスト、画像、動画を含むマルチモーダル入力に基づいて処理し、意思決定を行うように設計されています。d1-2Bの重要な特性は、トークン生成の必要がなく、単一のフォワードパスでキャリブレーションされた回答を返す能力であり、これがその速度と効率に寄与しています。

続きを読む

このモデルは、オープンなd1モデルの中で最高のパフォーマンスを示し、100を超える意思決定ベンチマークで平均してリードしています。d1-3Bよりも小さいにもかかわらず、しばしばそれを上回る性能を示し、最適化された設計を披露しています。従来の分類タスクを超えて、d1-2Bは特定のテキスト、数字、日付をその範囲とともに抽出し、画像内のオブジェクトを正確に特定し、定義された間隔で数量を推定するなどの高度な機能を提供します。

パフォーマンスは大きな利点であり、d1-2BはNVIDIA H100で5.7ミリ秒、AMD MI325Xで3.8ミリ秒の意思決定時間を達成しています。この迅速な処理は、1回の呼び出しで単一の状態に関する複数の質問があっても維持されます。d1-2Bを含むLFM3ファミリーは、ベース、テキスト、ビジョン、オーディオ、オムニ、意思決定モデルを特徴としています。d1-2Bはテキスト、画像、動画を処理しますが、その兄弟モデルであるd1-Omni-2Bはオーディオを含む機能を拡張します。

1.92億のパラメータと24層(13のゲート付き短い畳み込み、5のスライディングウィンドウアテンション、6のグローバルアテンション)からなるLFM3バックボーンアーキテクチャを持つd1-2Bは、128Kトークンのコンテキスト長と128,000トークンの語彙をサポートします。状態(テキストまたはJSON)、画像、または動画を入力として受け入れ、任意の数の名前付き質問を提供し、トークンを生成することなく確率を伴う型付き回答を生成します。英語、アラビア語、中国語、フランス語、ドイツ語、イタリア語、日本語、韓国語、ポルトガル語、スペイン語、ベトナム語、タイ語、インドネシア語、ヒンディー語、ロシア語、ポーランド語を含む幅広い言語をサポートしています。

d1-2Bは、ルーティングやトリアージ、コンテンツモデレーション、意図やトピックの分類、文書からのデータ抽出、評価と再ランキング、視覚検査など、意思決定を必要とするさまざまなパイプラインステップに適しています。チャットモデルではないことが明示的に記載されています。知識が豊富な質問には効果的ですが、64Kトークンを超える状態では信頼性が低下する可能性があります。カウントやスコアの推定は信頼性がありますが、自由な数量についてはそれほどではありません。このモデルは、独自のコードでTransformers内で実行され、サンプリングパラメータは必要ありません。

  • カテゴリーAIモデルとLLM
  • 料金モデルオープンソース
  • デプロイクラウド
  • プラットフォームWeb

  • マルチモーダル意思決定モデル(テキスト、画像、動画)

  • 20億のパラメータ

  • キャリブレーションされた回答のための単一フォワードパス

  • トークン生成なし

  • 最高の意思決定ベンチマークパフォーマンス

  • テキスト、数字、日付の抽出

  • 画像内のオブジェクトの位置特定

  • 間隔を伴う数量推定

  • ミリ秒単位の意思決定速度(例:AMD MI325Xで3.8 ms)

  • LFM3バックボーンアーキテクチャ

  • 128Kトークンのコンテキスト長

  • 128,000トークンの語彙

  • 多言語サポート(15以上の言語)

  • ルーティング、トリアージ、モデレーション、抽出のために設計

  • カスタムモデルコードでTransformers内で実行

  1. モデルページにアクセス: Hugging FaceのLiquidAI/d1-2Bモデルページに移動します。

  2. ファイルを確認: 提供されたモデルの詳細、アーキテクチャ、仕様を確認します。

  3. 推論の設定: Transformersライブラリを利用してモデルを推論のために設定します。

  4. 入力を準備: 状態(テキストまたはJSON)、画像、または動画とともに名前付き質問を提供します。

  5. 呼び出しを実行: 単一のリクエストには`system_one`を、バッチリクエストには`system_one_batch`を使用します。

  6. 出力を解釈: 生成されたトークンなしで確率を伴う型付き回答を受け取ります。

  • ルーティングとトリアージ
  • モデレーションとガードレール
  • 意図分類
  • トピック分類
  • 文書からの抽出
  • 評価と再ランキング
  • 視覚検査
  • マルチモーダル意思決定

d1-2B のレビュー

読み込み中...

d1-2B に似た人気のAIツール

LiquidAI d1-omni-600Mは、テキスト、画像、音声に対する単一パスの意思決定のために設計された600Mパラメータの意思決定モデルです。マルチモーダル入力を効率的に処理し、出力トークンを生成することなく迅速かつ正確な応答を提供します。

AIモデルとLLM
ツールを見る

テキスト、画像、音声に対する単一パスの意思決定のために設計された600Mパラメータの意思決定モデルです。マルチモーダル入力を効率的に処理し、出力トークンを生成することなく迅速かつ正確な応答を提供します。LiquidAI d1-omni-600Mは、テキスト、画像、音声に対する単一パスの意思決定のために設計された600Mパラメータの意思決定モデルです。マルチモーダル入力を効率的に処理し、出力トークンを生成することなく迅速かつ正確な応答を提供します。

AIモデルとLLM
LLM トップ50を見る

LiquidAI d1-Omni-2Bは、テキスト、画像、音声を処理するために設計された意思決定モデルです。トークンを生成することなく迅速に調整された回答を提供し、コールルーティングや音声イベント検出などのアプリケーションに最適です。

AIモデルとLLM
ツールを見る

テキスト、画像、音声を処理するために設計された意思決定モデルです。トークンを生成することなく迅速に調整された回答を提供し、コールルーティングや音声イベント検出などのアプリケーションに最適です。LiquidAI d1-Omni-2Bは、テキスト、画像、音声を処理するために設計された意思決定モデルです。トークンを生成することなく迅速に調整された回答を提供し、コールルーティングや音声イベント検出などのアプリケーションに最適です。

AIモデルとLLM
AI モデル トップ5を見る

d3-ultra

AI モデル

d3-ultraは、vLLM Semantic Routerからの27Bマルチモーダル意思決定モデルです。テキスト、JSON、画像、動画を処理して、確率を用いて質問に回答します。複雑な意思決定タスクに最適で、1つの質問につき最大131,072トークンをサポートし、テスト用の無料APIを提供します。

AIモデルとLLM
ツールを見る

AI モデル

vLLM Semantic Routerからの27Bマルチモーダル意思決定モデルです。テキスト、JSON、画像、動画を処理して、確率を用いて質問に回答します。複雑な意思決定タスクに最適で、1つの質問につき最大131,072トークンをサポートし、テスト用の無料APIを提供します。d3-ultraは、vLLM Semantic Routerからの27Bマルチモーダル意思決定モデルです。テキスト、JSON、画像、動画を処理して、確率を用いて質問に回答します。複雑な意思決定タスクに最適で、1つの質問につき最大131,072トークンをサポートし、テスト用の無料APIを提供します。

AIモデルとLLM
AI モデル トップ5を見る

GLiDE 27Bは、Fastinoによって開発された270億パラメータの意思決定モデルです。テキスト、JSON、およびオプションの画像を含む状態を処理し、各オプションの確率を伴って入力された質問に回答します。このモデルは、分類、ルーティング、スコアリングタスクに最適であり、さまざまな意思決定アプリケーションに対して正確で非生成的な確率出力を提供します。

AIモデルとLLM
ツールを見る

Fastinoによって開発された270億パラメータの意思決定モデルです。テキスト、JSON、およびオプションの画像を含む状態を処理し、各オプションの確率を伴って入力された質問に回答します。このモデルは、分類、ルーティング、スコアリングタスクに最適であり、さまざまな意思決定アプリケーションに対して正確で非生成的な確率出力を提供します。GLiDE 27Bは、Fastinoによって開発された270億パラメータの意思決定モデルです。テキスト、JSON、およびオプションの画像を含む状態を処理し、各オプションの確率を伴って入力された質問に回答します。このモデルは、分類、ルーティング、スコアリングタスクに最適であり、さまざまな意思決定アプリケーションに対して正確で非生成的な確率出力を提供します。

AIモデルとLLM
LLM トップ50を見る

DeepSeek-V4-Flash-Vision-Expは、視覚理解能力を強化するDeepSeek-V4ファミリーの実験的なマルチモーダルモデルです。DeepSeek-V4-Flashアーキテクチャに基づき、テキスト専用のパフォーマンスを維持しながら、マルチモーダルエージェントの能力を向上させます。

AIモデルとLLM
ツールを見る

視覚理解能力を強化するDeepSeek-V4ファミリーの実験的なマルチモーダルモデルです。DeepSeek-V4-Flashアーキテクチャに基づき、テキスト専用のパフォーマンスを維持しながら、マルチモーダルエージェントの能力を向上させます。DeepSeek-V4-Flash-Vision-Expは、視覚理解能力を強化するDeepSeek-V4ファミリーの実験的なマルチモーダルモデルです。DeepSeek-V4-Flashアーキテクチャに基づき、テキスト専用のパフォーマンスを維持しながら、マルチモーダルエージェントの能力を向上させます。

AIモデルとLLM
LLM トップ50を見る

Ling-3.1-flashは、複雑な現実のタスクに対応するために設計された高度なハイブリッド推論モデルです。5600億の総パラメータと100万トークンのコンテキストウィンドウを備え、医療、金融、ソフトウェア工学などのさまざまな分野でのパフォーマンスを向上させます。

AIモデルとLLM

LLMで第41位

ツールを見る

複雑な現実のタスクに対応するために設計された高度なハイブリッド推論モデルです。5600億の総パラメータと100万トークンのコンテキストウィンドウを備え、医療、金融、ソフトウェア工学などのさまざまな分野でのパフォーマンスを向上させます。Ling-3.1-flashは、複雑な現実のタスクに対応するために設計された高度なハイブリッド推論モデルです。5600億の総パラメータと100万トークンのコンテキストウィンドウを備え、医療、金融、ソフトウェア工学などのさまざまな分野でのパフォーマンスを向上させます。

AIモデルとLLM
LLMで第41位

LiquidAI LFM3-1.7Bは、ローカルエージェントおよび専門的なアプリケーション向けに設計されたテキストモデルです。トライハイブリッドアーキテクチャを特徴とし、256Kトークンのコンテキストウィンドウをサポートしているため、エッジデバイスに適しています。このモデルは、ドメイン特化型のファインチューニングに適応可能です。

AIモデルとLLM
ツールを見る

ローカルエージェントおよび専門的なアプリケーション向けに設計されたテキストモデルです。トライハイブリッドアーキテクチャを特徴とし、256Kトークンのコンテキストウィンドウをサポートしているため、エッジデバイスに適しています。このモデルは、ドメイン特化型のファインチューニングに適応可能です。LiquidAI LFM3-1.7Bは、ローカルエージェントおよび専門的なアプリケーション向けに設計されたテキストモデルです。トライハイブリッドアーキテクチャを特徴とし、256Kトークンのコンテキストウィンドウをサポートしているため、エッジデバイスに適しています。このモデルは、ドメイン特化型のファインチューニングに適応可能です。

AIモデルとLLM
LLM トップ50を見る

MiniMax-M3.1-Flashは、コーディング、エージェントワークフロー、サイバーセキュリティのために設計されたマルチモーダルなエキスパート混合モデルです。テキスト、画像、動画の入力をサポートし、スパースアテンションと量子化対応トレーニングにより、タスクのパフォーマンスと推論効率を向上させます。

AIモデルとLLM
ツールを見る

コーディング、エージェントワークフロー、サイバーセキュリティのために設計されたマルチモーダルなエキスパート混合モデルです。テキスト、画像、動画の入力をサポートし、スパースアテンションと量子化対応トレーニングにより、タスクのパフォーマンスと推論効率を向上させます。MiniMax-M3.1-Flashは、コーディング、エージェントワークフロー、サイバーセキュリティのために設計されたマルチモーダルなエキスパート混合モデルです。テキスト、画像、動画の入力をサポートし、スパースアテンションと量子化対応トレーニングにより、タスクのパフォーマンスと推論効率を向上させます。

AIモデルとLLM
LLM トップ50を見る
1 / 8