メインコンテンツへスキップ
ToolPotion
AI アドバイザー
送信(無料)

llmspeed

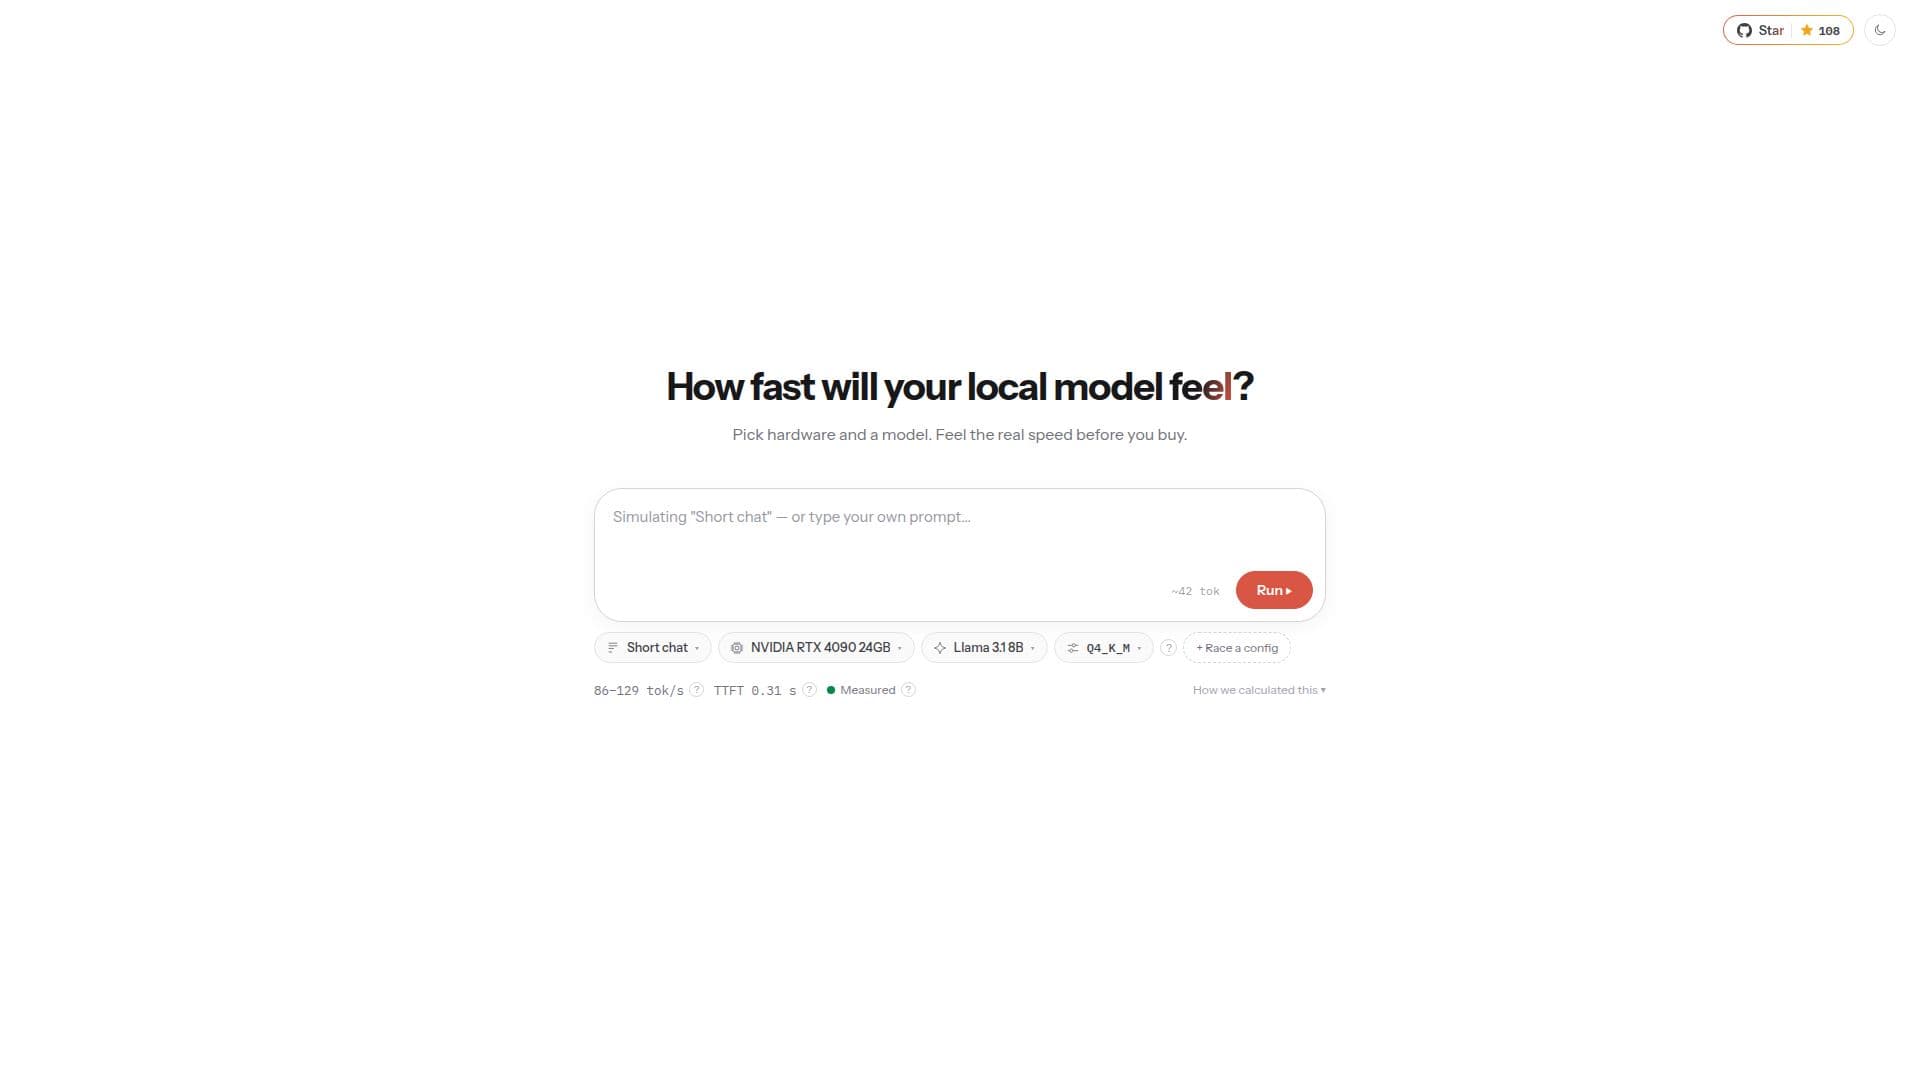
llmspeedは、ユーザーが購入前にローカルLLMの速度をシミュレートできるツールです。ハードウェアとモデルを選択することで、ユーザーは検証済みのベンチマークに基づいたトークン毎秒やファーストトークンまでの時間などのリアルタイムパフォーマンスメトリクスを体験できます。

URLを訪問
共有
llmspeed のスクリーンショット
llmspeed のスクリーンショット

llmspeedは、ユーザーが購入前にローカルの大規模言語モデル(LLM)のパフォーマンスを評価するために設計されたユニークなツールです。ユーザーが特定のハードウェアとモデルを選択できるようにすることで、llmspeedはトークン毎秒やファーストトークンまでの時間などのリアルタイムパフォーマンスメトリクスのシミュレーションを提供します。このシミュレーションは、さまざまなソースからの検証済みのベンチマークに基づいており、正確性と信頼性を保証します。

続きを読む

プラットフォームは、NVIDIA GPU、AMDプロセッサ、Apple Macなど、幅広いハードウェアオプションをサポートしています。ユーザーはQwen、GLM、Gemma、GPT-OSSなどのモデルから選択でき、包括的な評価体験を提供します。llmspeedのオープンソースの性質は、GitHubで利用可能であり、コミュニティの貢献と透明性を可能にします。

価格モデルはUSD 0に設定されており、llmspeedはローカルLLMの潜在的な速度を理解したいすべてのユーザーにアクセス可能です。このツールは、特定のハードウェアやモデルに投資する前に正確なパフォーマンスインサイトを必要とする開発者、研究者、AI愛好者に特に有益です。

全体として、llmspeedはハードウェアの能力とモデルのパフォーマンスのギャップを埋める貴重なサービスを提供し、情報に基づいた購入決定を可能にし、AIワークフローを最適化します。

  • カテゴリーMLOps・モデルデプロイ
  • 料金モデル無料
  • デプロイクラウド
  • プラットフォームウェブ

  • トークン毎秒のシミュレーション

  • ファーストトークンまでの時間の計算

  • 複数のハードウェアオプションをサポート

  • さまざまなLLMモデルを含む

  • 検証済みのベンチマークに基づく

  • GitHubでオープンソース

  • 無料で使用可能

  • コミュニティ主導のインサイト

  1. ハードウェアを選択: サポートされているデバイスの中から選択します

  2. モデルを選択: テストするLLMモデルを選びます

  3. シミュレーション: シミュレーションを実行してパフォーマンスメトリクスを確認します

  4. 評価: 結果を分析して情報に基づいた決定を行います

  • ハードウェア評価
  • モデル比較
  • パフォーマンスベンチマーキング
  • 研究開発
  • AIワークフローの最適化

llmspeed のレビュー

読み込み中...

llmspeed に似た人気のAIツール

CanIRun.ai

AI アプリ

あなたのGPUまたはMacを検出し、ローカルで実行可能なオープンAIモデル(LLM、コーディング、画像、動画モデルを含む)を表示する無料ツールで、VRAM要件と速度の推定値を提供します。

機械学習とデータサイエンス

機械学習とデータサイエンスで第47位

ツールを見る

AI アプリ

あなたのGPUまたはMacを検出し、ローカルで実行可能なオープンAIモデル(LLM、コーディング、画像、動画モデルを含む)を表示する無料ツールで、VRAM要件と速度の推定値を提供します。

機械学習とデータサイエンス
機械学習とデータサイエンスで第47位

ComputeArena

AI アプリ

ComputeArenaは、コミュニティが提出したローカルAIモデルのベンチマークを提供するプラットフォームです。ユーザーは、コミュニティハードウェアからの署名付きレポートを使用して、異なるモデル、量子化、チップ間のパフォーマンスを比較できます。

機械学習とデータサイエンス
ツールを見る

AI アプリ

コミュニティが提出したローカルAIモデルのベンチマークを提供するプラットフォームです。ユーザーは、コミュニティハードウェアからの署名付きレポートを使用して、異なるモデル、量子化、チップ間のパフォーマンスを比較できます。ComputeArenaは、コミュニティが提出したローカルAIモデルのベンチマークを提供するプラットフォームです。ユーザーは、コミュニティハードウェアからの署名付きレポートを使用して、異なるモデル、量子化、チップ間のパフォーマンスを比較できます。

機械学習とデータサイエンス
AI アプリ トップ250を見る

vLLM

AI アプリ

vLLMは、大規模言語モデル(LLM)のための高スループットかつメモリ効率の良い推論および提供エンジンです。これにより、最先端のパフォーマンスを持つAIモデルの迅速な展開が可能になり、さまざまな業界のユーザーにとってLLMの提供が簡単で迅速、かつコスト効率の良いものとなります。

MLOps・モデルデプロイ
ツールを見る

AI アプリ

大規模言語モデル(LLM)のための高スループットかつメモリ効率の良い推論および提供エンジンです。これにより、最先端のパフォーマンスを持つAIモデルの迅速な展開が可能になり、さまざまな業界のユーザーにとってLLMの提供が簡単で迅速、かつコスト効率の良いものとなります。vLLMは、大規模言語モデル(LLM)のための高スループットかつメモリ効率の良い推論および提供エンジンです。これにより、最先端のパフォーマンスを持つAIモデルの迅速な展開が可能になり、さまざまな業界のユーザーにとってLLMの提供が簡単で迅速、かつコスト効率の良いものとなります。

MLOps・モデルデプロイ
AI アプリ トップ250を見る

ラップトップLLMファインダーは、あなたのラップトップがQwen3.8-27BまたはDeepSeek-V4-Flash-0731を単一のCPUで実行できるかどうかを判断するのに役立ちます。RAM、ディスク、OSの要件に対する検証済みのパスを提供し、効率的なローカル推論を確保します。

AIモデルとLLM
ツールを見る

あなたのラップトップがQwen3.8-27BまたはDeepSeek-V4-Flash-0731を単一のCPUで実行できるかどうかを判断するのに役立ちます。RAM、ディスク、OSの要件に対する検証済みのパスを提供し、効率的なローカル推論を確保します。ラップトップLLMファインダーは、あなたのラップトップがQwen3.8-27BまたはDeepSeek-V4-Flash-0731を単一のCPUで実行できるかどうかを判断するのに役立ちます。RAM、ディスク、OSの要件に対する検証済みのパスを提供し、効率的なローカル推論を確保します。

AIモデルとLLM
AI アプリ トップ250を見る

Dreamscale Labs

AI アプリ

Dreamscale Labsは、物理AI向けのリアルタイムクラウド推論を提供し、ロボティクスチームが高価なローカルGPUを必要とせずにモデルを展開および評価できるようにします。このプラットフォームは、低遅延の実行を確保するために、モデル、GPUカーネル、ネットワークレイヤーを最適化します。

ロボティクスと AI ハードウェア

AI DevOps・クラウドツールで第180位

ツールを見る

AI アプリ

物理AI向けのリアルタイムクラウド推論を提供し、ロボティクスチームが高価なローカルGPUを必要とせずにモデルを展開および評価できるようにします。このプラットフォームは、低遅延の実行を確保するために、モデル、GPUカーネル、ネットワークレイヤーを最適化します。Dreamscale Labsは、物理AI向けのリアルタイムクラウド推論を提供し、ロボティクスチームが高価なローカルGPUを必要とせずにモデルを展開および評価できるようにします。このプラットフォームは、低遅延の実行を確保するために、モデル、GPUカーネル、ネットワークレイヤーを最適化します。

ロボティクスと AI ハードウェア
AI DevOps・クラウドツールで第180位

一般計算

AI アプリ

特別に設計されたASICインフラストラクチャ上でモデルを提供する高速AI推論プロバイダーで、OpenAI互換のAPIを通じて、コーディングエージェントやリアルタイム音声などのレイテンシに敏感なワークロードに対して低いファーストトークン時間と高いスループットを提供します。

MLOps・モデルデプロイ
ツールを見る

AI アプリ

特別に設計されたASICインフラストラクチャ上でモデルを提供する高速AI推論プロバイダーで、OpenAI互換のAPIを通じて、コーディングエージェントやリアルタイム音声などのレイテンシに敏感なワークロードに対して低いファーストトークン時間と高いスループットを提供します。

MLOps・モデルデプロイ
AI アプリ トップ250を見る

gpt-ossには、強力なパフォーマンスと効率的な展開のために設計された2つのオープンウェイト言語モデル、gpt-oss-120bとgpt-oss-20bが含まれています。これらはApache 2.0ライセンスの下で利用可能で、さまざまなアプリケーションにアクセスできるようにし、安全性とカスタマイズを確保しています。

AIモデルとLLM
ツールを見る

gpt-ossには、強力なパフォーマンスと効率的な展開のために設計された2つのオープンウェイト言語モデル、gpt-oss-120bとgpt-oss-20bが含まれています。これらはApache 2.0ライセンスの下で利用可能で、さまざまなアプリケーションにアクセスできるようにし、安全性とカスタマイズを確保しています。

注目AIモデルとLLM
LLM トップ50を見る

ZETIC Melange

AI アプリ

ZETIC Melangeは、あらゆるデバイス上のあらゆるモデルに対して、オンデバイスAIのデプロイを自動化します。元Qualcommエンジニアが開発し、NPUアクセラレーションを最適化し、200以上のデバイスでベンチマークを行い、わずか3行のコードで数時間でのデプロイを可能にし、コストとレイテンシを削減します。

MLOps・モデルデプロイ

MLOps・モデルデプロイで第137位

ツールを見る

AI アプリ

あらゆるデバイス上のあらゆるモデルに対して、オンデバイスAIのデプロイを自動化します。元Qualcommエンジニアが開発し、NPUアクセラレーションを最適化し、200以上のデバイスでベンチマークを行い、わずか3行のコードで数時間でのデプロイを可能にし、コストとレイテンシを削減します。ZETIC Melangeは、あらゆるデバイス上のあらゆるモデルに対して、オンデバイスAIのデプロイを自動化します。元Qualcommエンジニアが開発し、NPUアクセラレーションを最適化し、200以上のデバイスでベンチマークを行い、わずか3行のコードで数時間でのデプロイを可能にし、コストとレイテンシを削減します。

MLOps・モデルデプロイ
MLOps・モデルデプロイで第137位
1 / 8