

メインコンテンツへスキップ
ToolPotion
AI アドバイザー
送信(無料)

vLLM

AI アプリMLOps・モデルデプロイオープンソース · NVIDIA、AMD、Google TPU

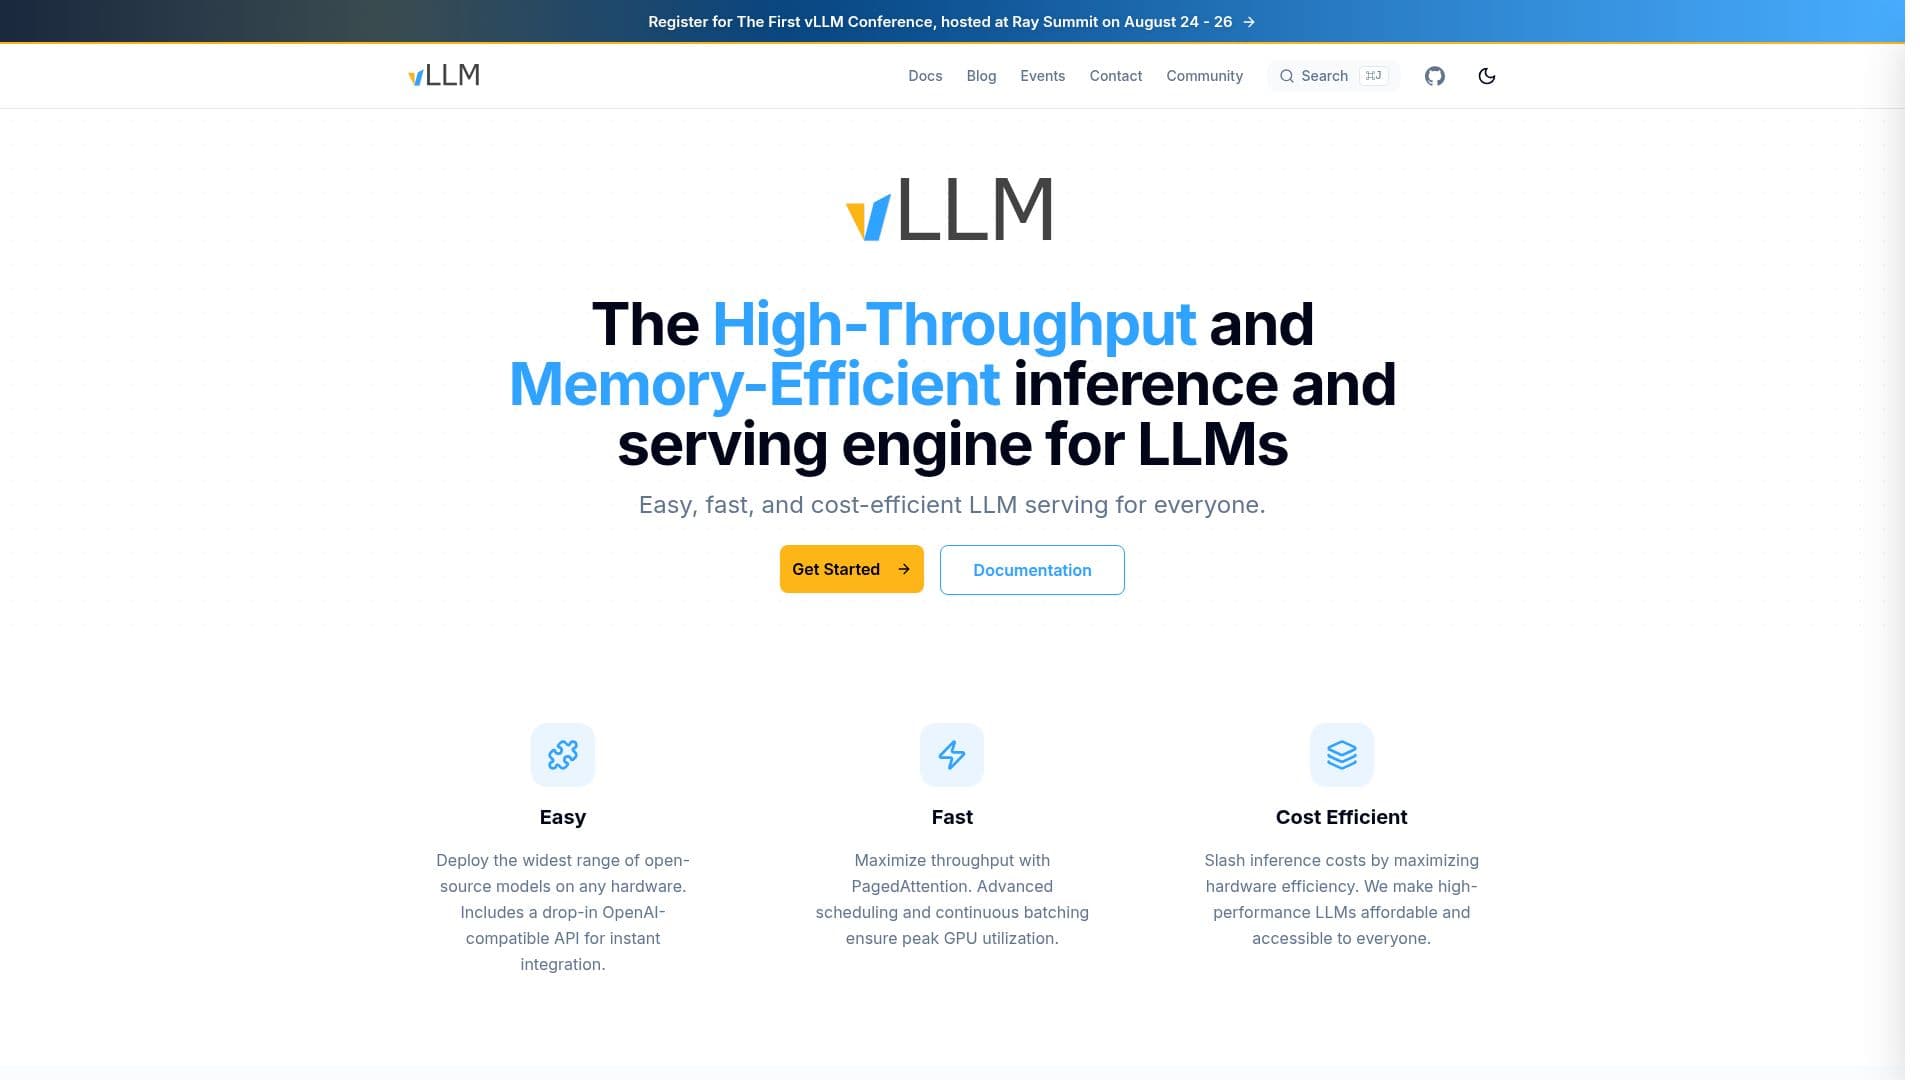
vLLMは、大規模言語モデル(LLM)のための高スループットかつメモリ効率の良い推論および提供エンジンです。これにより、最先端のパフォーマンスを持つAIモデルの迅速な展開が可能になり、さまざまな業界のユーザーにとってLLMの提供が簡単で迅速、かつコスト効率の良いものとなります。

URLを訪問
共有
vLLM のスクリーンショット
vLLM のスクリーンショット

vLLMは、大規模言語モデル(LLM)の推論および提供を最適化するために設計されており、高スループットとメモリ効率に重点を置いています。このエンジンは、CUTLASSやTRTLLM-GENなどのフレームワークを利用し、さまざまな精度のために最適化されたGEMM/MoEカーネルなどの高度な技術を活用しています。vLLMの目標は、AIモデルの展開においてシームレスな体験を提供し、ユーザーがLLMの提供に通常伴う複雑さなしに最先端のパフォーマンスを達成できるようにすることです。

続きを読む

このプラットフォームは、さまざまなハードウェア構成との統合を可能にするために、普遍的な互換性を持って構築されています。これには、NVIDIA GPU、AMD GPU、Google TPUのサポートが含まれます。この柔軟性により、vLLMは異なる環境でAIソリューションを実装しようとする開発者や組織にとって理想的な選択肢となります。ユーザーは、簡単な設定プロセスのおかげで、最小限のセットアップでvLLMの使用を迅速に開始できます。

vLLMはまた、ハードウェアサポートからモデル統合に至るまでのトピックについてユーザーが議論できるフォーラムを提供するコミュニティ主導のアプローチを採用しています。この協力的な環境は知識の共有を促進し、ユーザーがプラットフォームの利用を最適化するのに役立ちます。さらに、vLLMはLlama、BART、GPTなどの人気のあるアーキテクチャを含む幅広いモデルをサポートしています。

要約すると、vLLMはLLMを効率的に展開しようとするすべての人にとって強力なツールとして際立っています。そのパフォーマンス、使いやすさ、コミュニティサポートの組み合わせは、急速に進化するAIの分野において貴重なリソースとしての地位を確立しています。

  • カテゴリーMLOps・モデルデプロイ
  • 料金モデルオープンソース
  • デプロイクラウド
  • プラットフォームNVIDIA、AMD、Google TPU

  • 高スループット

  • メモリ効率

  • 普遍的な互換性

  • 最適化されたGEMM/MoEカーネル

  • 複数のハードウェアのサポート

  • コミュニティフォーラム

  • クイックスタート設定

  • 幅広いモデルサポート

  1. 設定: vLLMをサポートするためにハードウェア環境を設定します。

  2. インストール: ドキュメントに記載されたインストール手順に従います。

  3. 展開: 希望するAIモデルをvLLMエンジンにロードします。

  4. 最適化: 特定のユースケースに基づいてパフォーマンスのために設定を調整します。

  • AIモデルの展開
  • パフォーマンス最適化
  • コミュニティエンゲージメント
  • カスタムモデル統合
  • クロスプラットフォーム互換性

vLLM の製品

vLLM の一部です。

vLLM のレビュー

読み込み中...

vLLM に似た人気のAIツール

vLLM

AI GitHub リポジトリ

vllm-project/vllmは、大規模言語モデル(LLM)向けに設計された高スループットかつメモリ効率の良い推論および提供エンジンです。リソース使用を最小限に抑えつつパフォーマンスを最適化し、AIや機械学習のさまざまなアプリケーションに適しています。

MLOps・モデルデプロイ

AI GitHub リポジトリで第23位

ツールを見る

AI GitHub リポジトリ

大規模言語モデル(LLM)向けに設計された高スループットかつメモリ効率の良い推論および提供エンジンです。リソース使用を最小限に抑えつつパフォーマンスを最適化し、AIや機械学習のさまざまなアプリケーションに適しています。vllm-project/vllmは、大規模言語モデル(LLM)向けに設計された高スループットかつメモリ効率の良い推論および提供エンジンです。リソース使用を最小限に抑えつつパフォーマンスを最適化し、AIや機械学習のさまざまなアプリケーションに適しています。

注目MLOps・モデルデプロイ
AI GitHub リポジトリで第23位

Runware

AI アプリ

Runwareは、画像、動画、音声、3D、LLM、ビジョンモデルのための統一されたAPIを提供する生成AI推論プラットフォームです。400K以上のモデル、管理されたインフラストラクチャ、カスタム推論エンジンに基づいた使用量ベースの価格設定を提供します。

MLOps・モデルデプロイ
ツールを見る

AI アプリ

画像、動画、音声、3D、LLM、ビジョンモデルのための統一されたAPIを提供する生成AI推論プラットフォームです。400K以上のモデル、管理されたインフラストラクチャ、カスタム推論エンジンに基づいた使用量ベースの価格設定を提供します。Runwareは、画像、動画、音声、3D、LLM、ビジョンモデルのための統一されたAPIを提供する生成AI推論プラットフォームです。400K以上のモデル、管理されたインフラストラクチャ、カスタム推論エンジンに基づいた使用量ベースの価格設定を提供します。

MLOps・モデルデプロイ
AI アプリ トップ250を見る

一般計算

AI アプリ

特別に設計されたASICインフラストラクチャ上でモデルを提供する高速AI推論プロバイダーで、OpenAI互換のAPIを通じて、コーディングエージェントやリアルタイム音声などのレイテンシに敏感なワークロードに対して低いファーストトークン時間と高いスループットを提供します。

MLOps・モデルデプロイ
ツールを見る

AI アプリ

特別に設計されたASICインフラストラクチャ上でモデルを提供する高速AI推論プロバイダーで、OpenAI互換のAPIを通じて、コーディングエージェントやリアルタイム音声などのレイテンシに敏感なワークロードに対して低いファーストトークン時間と高いスループットを提供します。

MLOps・モデルデプロイ
AI アプリ トップ250を見る

SiliconFlow

AI プラットフォーム

開発者が200以上の最適化されたLLMおよびマルチモーダルモデルをデプロイ、ファインチューニング、実行できるAIインフラストラクチャプラットフォームで、OpenAI互換のAPIを通じて従量課金制で提供されます。

MLOps・モデルデプロイ
ツールを見る

AI プラットフォーム

開発者が200以上の最適化されたLLMおよびマルチモーダルモデルをデプロイ、ファインチューニング、実行できるAIインフラストラクチャプラットフォームで、OpenAI互換のAPIを通じて従量課金制で提供されます。

注目MLOps・モデルデプロイ
AI プラットフォーム トップ150を見る

ZETIC Melange

AI アプリ

ZETIC Melangeは、あらゆるデバイス上のあらゆるモデルに対して、オンデバイスAIのデプロイを自動化します。元Qualcommエンジニアが開発し、NPUアクセラレーションを最適化し、200以上のデバイスでベンチマークを行い、わずか3行のコードで数時間でのデプロイを可能にし、コストとレイテンシを削減します。

MLOps・モデルデプロイ

MLOps・モデルデプロイで第139位

ツールを見る

AI アプリ

あらゆるデバイス上のあらゆるモデルに対して、オンデバイスAIのデプロイを自動化します。元Qualcommエンジニアが開発し、NPUアクセラレーションを最適化し、200以上のデバイスでベンチマークを行い、わずか3行のコードで数時間でのデプロイを可能にし、コストとレイテンシを削減します。ZETIC Melangeは、あらゆるデバイス上のあらゆるモデルに対して、オンデバイスAIのデプロイを自動化します。元Qualcommエンジニアが開発し、NPUアクセラレーションを最適化し、200以上のデバイスでベンチマークを行い、わずか3行のコードで数時間でのデプロイを可能にし、コストとレイテンシを削減します。

MLOps・モデルデプロイ
MLOps・モデルデプロイで第139位

BigDL LLM

AI フレームワーク

BigDL-LLMは、ラップトップからクラウドGPUまで、Intel XPUハードウェア上で大規模言語モデル(LLM)を実行するためのオープンソースライブラリです。低遅延推論のためのINT4/FP4/INT8/FP8量子化をサポートし、PyTorchモデル向けの包括的なファインチューニング機能を提供します。

MLOps・モデルデプロイ
ツールを見る

AI フレームワーク

BigDL-LLMは、ラップトップからクラウドGPUまで、Intel XPUハードウェア上で大規模言語モデル(LLM)を実行するためのオープンソースライブラリです。低遅延推論のためのINT4/FP4/INT8/FP8量子化をサポートし、PyTorchモデル向けの包括的なファインチューニング機能を提供します。

MLOps・モデルデプロイ
AI フレームワーク トップ50を見る

deAPI

AI アプリ

deAPIは、画像生成、テキスト読み上げ、転写などをカバーするオープンソースの生成AIモデルのための統一APIです。リクエストは分散型GPUクラウドで実行され、ハードウェアを管理することなく低コストの推論を提供します。

MLOps・モデルデプロイ
ツールを見る

AI アプリ

画像生成、テキスト読み上げ、転写などをカバーするオープンソースの生成AIモデルのための統一APIです。リクエストは分散型GPUクラウドで実行され、ハードウェアを管理することなく低コストの推論を提供します。deAPIは、画像生成、テキスト読み上げ、転写などをカバーするオープンソースの生成AIモデルのための統一APIです。リクエストは分散型GPUクラウドで実行され、ハードウェアを管理することなく低コストの推論を提供します。

MLOps・モデルデプロイ
AI アプリ トップ250を見る

Bento

AI プラットフォーム

Bentoは、速度と制御のために設計された推論プラットフォームであり、あらゆるAIモデルをあらゆる場所にデプロイできます。テーラードされた最適化、効率的なスケーリング、およびAIチーム向けの合理化された運用を提供します。デプロイメントに対する完全な制御を維持しながら、推論インフラストラクチャを簡素化します。

MLOps・モデルデプロイ
ツールを見る

AI プラットフォーム

速度と制御のために設計された推論プラットフォームであり、あらゆるAIモデルをあらゆる場所にデプロイできます。テーラードされた最適化、効率的なスケーリング、およびAIチーム向けの合理化された運用を提供します。デプロイメントに対する完全な制御を維持しながら、推論インフラストラクチャを簡素化します。Bentoは、速度と制御のために設計された推論プラットフォームであり、あらゆるAIモデルをあらゆる場所にデプロイできます。テーラードされた最適化、効率的なスケーリング、およびAIチーム向けの合理化された運用を提供します。デプロイメントに対する完全な制御を維持しながら、推論インフラストラクチャを簡素化します。

注目MLOps・モデルデプロイ
AI プラットフォーム トップ150を見る
1 / 8




