

أصبحت النماذج مفتوحة الأوزان قريبة بما يكفي من أفضل النماذج المغلقة، حتى إن السؤال الحقيقي في كثير من الأعمال لم يعد الجودة. بل من الذي يشغّل النموذج، وإلى أين تذهب بياناتك، وماذا يسمح لك الترخيص أن تفعل. تقدّر Bloomberg Intelligence الفجوة بين أفضل نموذج صيني والنموذج الأمريكي الرائد بنحو 3% في أحد المقاييس الكبرى، بعد أن كانت نحو 15% في وقت سابق من هذا العام (AI Weekly نقلًا عن Bloomberg).
هذا التحول مهم أكثر ما يكون للمطوّرين والشركات الناشئة والفرق الخاضعة لقواعد خصوصية. صار بإمكانك تنزيل نموذج من Hugging Face وتشغيله على عتاد تتحكم فيه، والحصول على نتائج في البرمجة والوكلاء كانت قبل عام حكرًا على واجهة API مدفوعة. أو يمكنك الاستغناء عن العتاد واستدعاء الأوزان نفسها عبر مزوّد استضافة رخيص.
لكن الصورة ليست كلها إيجابية. فكلمة "مفتوح" تغطي تراخيص تتراوح بين "افعل ما شئت" و"اقرأ البنود الصغيرة جيدًا"، وبعض أكبر النماذج يحتاج إلى رفّ كامل من وحدات GPU، وبعضها يحمل مخاطر أمنية ورقابية حقيقية. يرتّب هذا الدليل القادة الحاليين، ويعرض تكلفتهم، ويقدّم قواعد للاختيار. وإن كنت تريد نظرة أوسع على النماذج المغلقة والمفتوحة، فإن لوحة أفضل 25 نموذجًا لغويًا لدينا تتابعها.
تقلّصت الفجوة، وتغيّرت التشكيلة
فجوة المقاييس هي العنوان الأبرز، فلنرَ ما وراءها. سجّلت قراءات Bloomberg تأخر أفضل نموذج صيني بنحو 15% في بداية العام، ثم نحو 9% في منتصفه، ثم نحو 6% بعد شهر، وكان ذلك أدنى مستوى مسجّل حينها (The Next Web). أما أحدث قراءة فنحو 3%. وأحدث نقطة بيانات هي DeepSeek V4.1 Flash، الذي حصل على 81.1 في LiveBench مقابل 83.4 لنموذج رائد من Anthropic، ويتصدر الاختبار الفرعي للبرمجة الوكيلية في ذلك المقياس بنتيجة 77.3 مقابل 66.1.
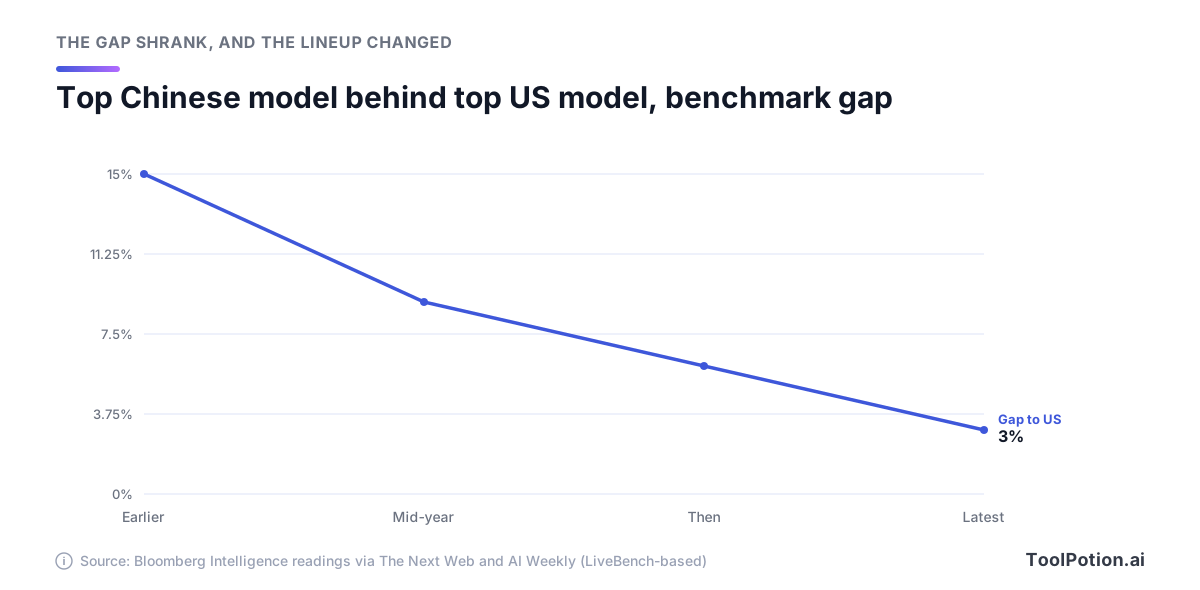
ضع التحفظات نصب عينيك. ثلاثة فقط من أفضل 15 إدخالًا في LiveBench صينية، فالقصة هنا عن حافة الصدارة وليست اكتساحًا. كما أن الفجوة تمثّل رؤية مقياس واحد لأفضل نموذج في كل جانب، ولا يذكر أي من المصدرين أنها تقتصر على النماذج المفتوحة. ومع ذلك فالاتجاه واضح، والنموذج الذي أغلقها، DeepSeek V4.1 Flash، مفتوح الأوزان.
تغيّر أمران آخران هذا العام. أولًا، أصدرت Qwen نموذجًا من فئة Max بأوزان مفتوحة لأول مرة، بحسب بطاقة النموذج الخاصة بـ Qwen3.8-2.4T-A95B. ثانيًا، تحوّلت إصدارات Meta المفتوحة. فأحدث نماذج Llama في صفحة Meta على Hugging Face ما زالت عائلة Llama 4 من 2025، مثل Llama 4 Scout. أما موقع Meta للمطوّرين فيتصدره الآن نموذجا Muse Spark المستضافان، ويدرج Muse Glimmer، وهو نموذج مفتوح الأوزان بحجم 30B للوكلاء المحليين، بوصفه النموذج المفتوح.
والخبر الآخر من Mistral. فقد أعلنت للتو عن Mistral Large 4، وهو نموذج بحجم تريليون معامل، منها 52 مليارًا نشطة، وأتاحت نسخة معاينة عبر واجهة API الخاصة بها. وتقول إن الأوزان ستتبعها بنهاية الشهر (Mistral). وعند كتابة هذا المقال لم تكن قابلة للتنزيل، ولم تنشر Mistral ترخيصًا، فتعامل مع Large 4 على أنه وعد لا إصدار. لا تبنِ خططك عليه حتى تتوفر الأوزان والترخيص على Hugging Face.
النماذج مفتوحة الأوزان التي تستحق أن تعرفها
إليك القادة الحاليين في نظرة سريعة. الأحجام والتراخيص مأخوذة من بطاقة كل نموذج على Hugging Face، والأسعار من صفحة التسعير الخاصة بكل شركة. "النشطة" هي عدد المعاملات التي تعمل لكل token في نموذج مزيج الخبراء، وهو ما يحدد السرعة.
| النموذج | الترخيص | الحجم (النشط) | السياق | API الشركة، بالدولار لكل مليون token دخلًا / خرجًا |
|---|---|---|---|---|
| DeepSeek V4.1 Flash | MIT | 763B (من 8B إلى 16B) | 1M | 0.30 / 1.20 وقت الذروة |
| DeepSeek V4-Pro | MIT | 1.7T | 1M | 1.32 / 3.96 وقت الذروة |
| Kimi K3 | Kimi K3 License | 2.8T (104B) | 1M | 3.00 / 15.00 |
| GLM-5.3 | GLM-5.3 License | 753B | 1M | 1.40 / 4.40 |
| Qwen3.8-27B | Apache 2.0 | 27B كثيف | 262K | نسخة مستضافة قريبًا |
| gpt-oss-120b | Apache 2.0 | 117B (5.1B) | غير متاح | لا توجد API من الشركة |
| Gemma 4 31B | Apache 2.0 | 31B كثيف | 256K | لا توجد API من الشركة |
| Muse Glimmer | Apache 2.0 | 30B كثيف | +131K | لا توجد API من الشركة |
| Mistral Large 4 | غير منشور | 1T (52B) | غير متاح | 1.36 / 4.18 معاينة |
DeepSeek هو الخيار الافتراضي الآمن من حيث التكلفة. أوزان V4.1 Flash بترخيص MIT، وسعر API هو الأدنى بين النماذج الكبيرة، وتخفيض بنصف السعر في ساعات خارج الذروة يخفضه أكثر (وثائق DeepSeek). ولا يخدعنّك الاسم. فـ"Flash" هنا نموذج بحجم 763B، وتنزيله 510 GB (بطاقة النموذج). أما V4-Pro-0813 فأكبر منه بنحو 1.7T.
Kimi K3 هو الأكثر لفتًا للأنظار. بحجم 2.8 تريليون معامل منها 104 مليارات نشطة، يسجّل 93.5 في GPQA Diamond و91.2 في BrowseComp بحسب بطاقته الخاصة. هذه أرقام Moonshot، فاقرأها على أنها ادعاءات. كما أن API الخاصة بـ Moonshot هي الأغلى بين المجموعة المفتوحة، وهذا يفاجئ كثيرين (المزيد عن ذلك أدناه).
GLM-5.3 من Z.ai هو متخصص البرمجة. يشترك في النموذج الأساسي مع GLM-5.2، وتقول Z.ai إن كل التحسن جاء من مرحلة ما بعد التدريب، بما في ذلك قفزة بنسبة 50% في اختبار البرمجة الداخلي لديها (بطاقة النموذج). وهذا قياس من الشركة نفسها. أما شقيقه الرخيص GLM-5.3-Flash فسعره 0.15 دولار للدخل و0.50 للخرج.
Qwen هي الأوسع نطاقًا. Qwen3.8-27B نموذج كثيف بحجم 27B بترخيص Apache 2.0، يدعم الرؤية وسياقًا أصليًا بطول 262K، ويُنقل أنه حقق 61.7 في SWE-bench Pro (بطاقة النموذج). وهو لمحطة عمل واحدة أفضل تجربة أولى في البرمجة وأعمال الوكلاء، ولمعظم الفرق الصغيرة هو النموذج الذي تبدأ به. أما Qwen3.8-2.4T الكبير فيخضع لترخيص منفصل نتناوله لاحقًا. ويمكنك أيضًا تجربة Qwen عبر تطبيقها.
نموذج gpt-oss-120b من OpenAI صار قديمًا لكنه ما زال مفيدًا. بترخيص Apache 2.0، وبـ5.1B معاملات نشطة، ويعمل بحسب OpenAI على وحدة GPU واحدة بذاكرة 80 GB (بطاقة النموذج). نُشر في 2025، ولم يظهر أي إصدار أحدث من gpt-oss في صفحة OpenAI على Hugging Face. وGemma 4 هي عائلة Google الحالية؛ نموذج 31B بترخيص Apache 2.0، ونافذة سياق 256K، ويأتي بنسخ مكمَّمة لـOllama وllama.cpp (بطاقة النموذج). أما Muse Glimmer فهو الصغير: تقول Meta إن نسخة بتكميم 4 بت تقريبًا تقل عن 20 GB وتعمل ضمن 24 GB أو 32 GB، مع فقدان في الجودة بنحو 1% عند الإعداد الأضيق (بطاقة النموذج).
لدى أوروبا خياران اليوم. Mistral Medium 3.5 نموذج كثيف بحجم 128B ونافذة 256K بترخيص MIT معدَّل، تصفه Mistral بأنه مفتوح للاستخدام التجاري باستثناء الشركات ذات الإيرادات الكبيرة. أما Mistral Small 4 بحجم 119B وMistral Large 3 الأقدم فبترخيص Apache 2.0 على Hugging Face.
"المفتوح" قد يأتي بقيود
نماذج Apache 2.0 وMIT وحدها مفتوحة بالمعنى الذي يقصده معظم المطوّرين. وعدد من أقوى النماذج ليس كذلك. اقرأ ملف الترخيص لا العنوان.
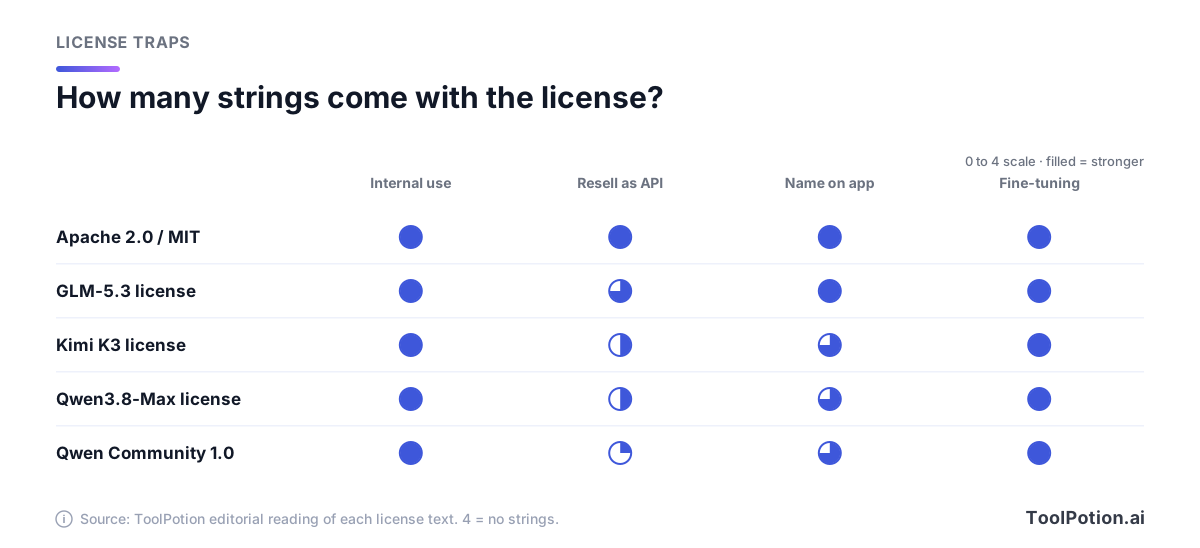
النمط نفسه يتكرر في التراخيص المخصصة. يمكنك الاستخدام والتعديل والضبط الدقيق بحرية. أما القيود فتتعلق ببيع النموذج للآخرين، عادةً في صورة API، بعد تجاوز حد معين من الإيرادات. فترخيص Moonshot مثلًا ينص على أن مشغّل "Model as a Service" الذي تتجاوز إيراداته 20 مليون دولار خلال 12 شهرًا يحتاج إلى اتفاق منفصل قبل الاستخدام التجاري. وعلى المنتجات التي يبلغ عدد مستخدميها الشهري 100 مليون أو إيراداتها الشهرية 20 مليون دولار أن تُظهر "Kimi K3" في الواجهة (نص الترخيص). والاستخدام الداخلي مستثنى.
ترخيص Z.ai أخف. فالشرط الوحيد مراجعة أمنية لمشغّلي Model-as-a-Service الذين تتجاوز إيراداتهم 10 مليارات دولار. وتراخيص Qwen هي الأشد في المجموعة. فترخيص Qwen Community على Qwen3.8-Flash-Next ينص على أن أي شركة تدير عملًا من نوع Model-as-a-Service أو "AI Work Assistant" يجب أن تحصل أولًا على ترخيص منفصل من Qwen، مع استثناء للاستخدام الداخلي (نص الترخيص). ويرفع ترخيص Max على نموذج 2.4T هذا الحد إلى 50 مليون دولار من الإيرادات.
إن كنت تبني تطبيقًا فوق أحد هذه النماذج فأنت على الأرجح بخير. وإن كان منتجك "API تقدّم هذا النموذج" فاقرأ الترخيص مع محامٍ قبل الإطلاق. وإن أردت ألا يبقى أي شك فالتزم بـApache 2.0 أو MIT. أي DeepSeek وQwen3.8-27B وgpt-oss وGemma 4 وMuse Glimmer.
كم تكلّف واجهات API المستضافة
الأوزان المفتوحة لا تعني API رخيصة. فالصورة تتغير بحسب من يستضيف النموذج.
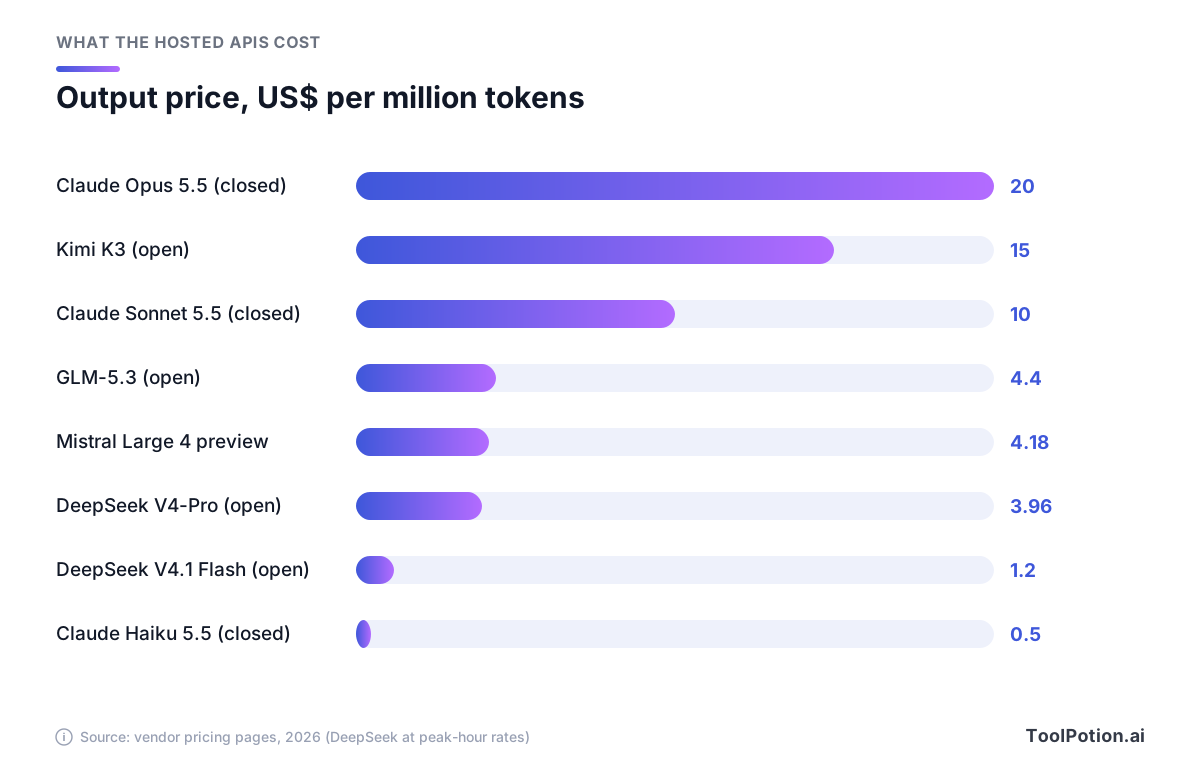
تتقاضى Moonshot على Kimi K3 مبلغ 3 دولارات للدخل و15 للخرج لكل مليون token بحسب صفحة التسعير لديها. وهذا أكثر من Claude Sonnet 5.5 من Anthropic بسعر 2 و10، وSonnet نموذج مغلق. أما DeepSeek فعلى النقيض: خرج V4-Pro يكلّف 3.96 دولار وقت الذروة و1.98 خارجها. وGLM-5.3 من Z.ai بسعر 1.40 للدخل و4.40 للخرج.
النماذج المغلقة الصغيرة تنافس بأسعارها معظم النماذج المفتوحة الرائدة. فـClaude Haiku 5.5 مدرج بسعر 0.10 للدخل و0.50 للخرج، مثل GPT-6 Luna من OpenAI، بحسب صفحة التسعير لدى كل شركة. فمقولة "اختر المفتوح لتوفّر" لا تصدق إلا أمام الفئات المغلقة الغالية، وفقط إن اخترت مزوّد استضافة مفتوحًا رخيصًا.
الطريق الأرخص غالبًا طرف ثالث يقدّم الأوزان نفسها. فقائمة النماذج العامة في OpenRouter تعرض gpt-oss-120b بنحو 0.04 دولار للدخل و0.17 للخرج لكل مليون token، وتختلف الأسعار هناك بحسب المزوّد وتتغير كثيرًا. وOpenRouter وTogether AI وFireworks AI وGroq كلها تعيد بيع نماذج مفتوحة خلف صيغة API واحدة، فتغيير المزوّد لا يتطلب سوى تعديل base URL.
شغّله بنفسك أم استخدم مزوّد استضافة
هناك أربع طرق لتشغيل نموذج مفتوح، وكل واحدة تمنحك قدرًا أكبر من التحكم وقدرًا أكبر من العمل.
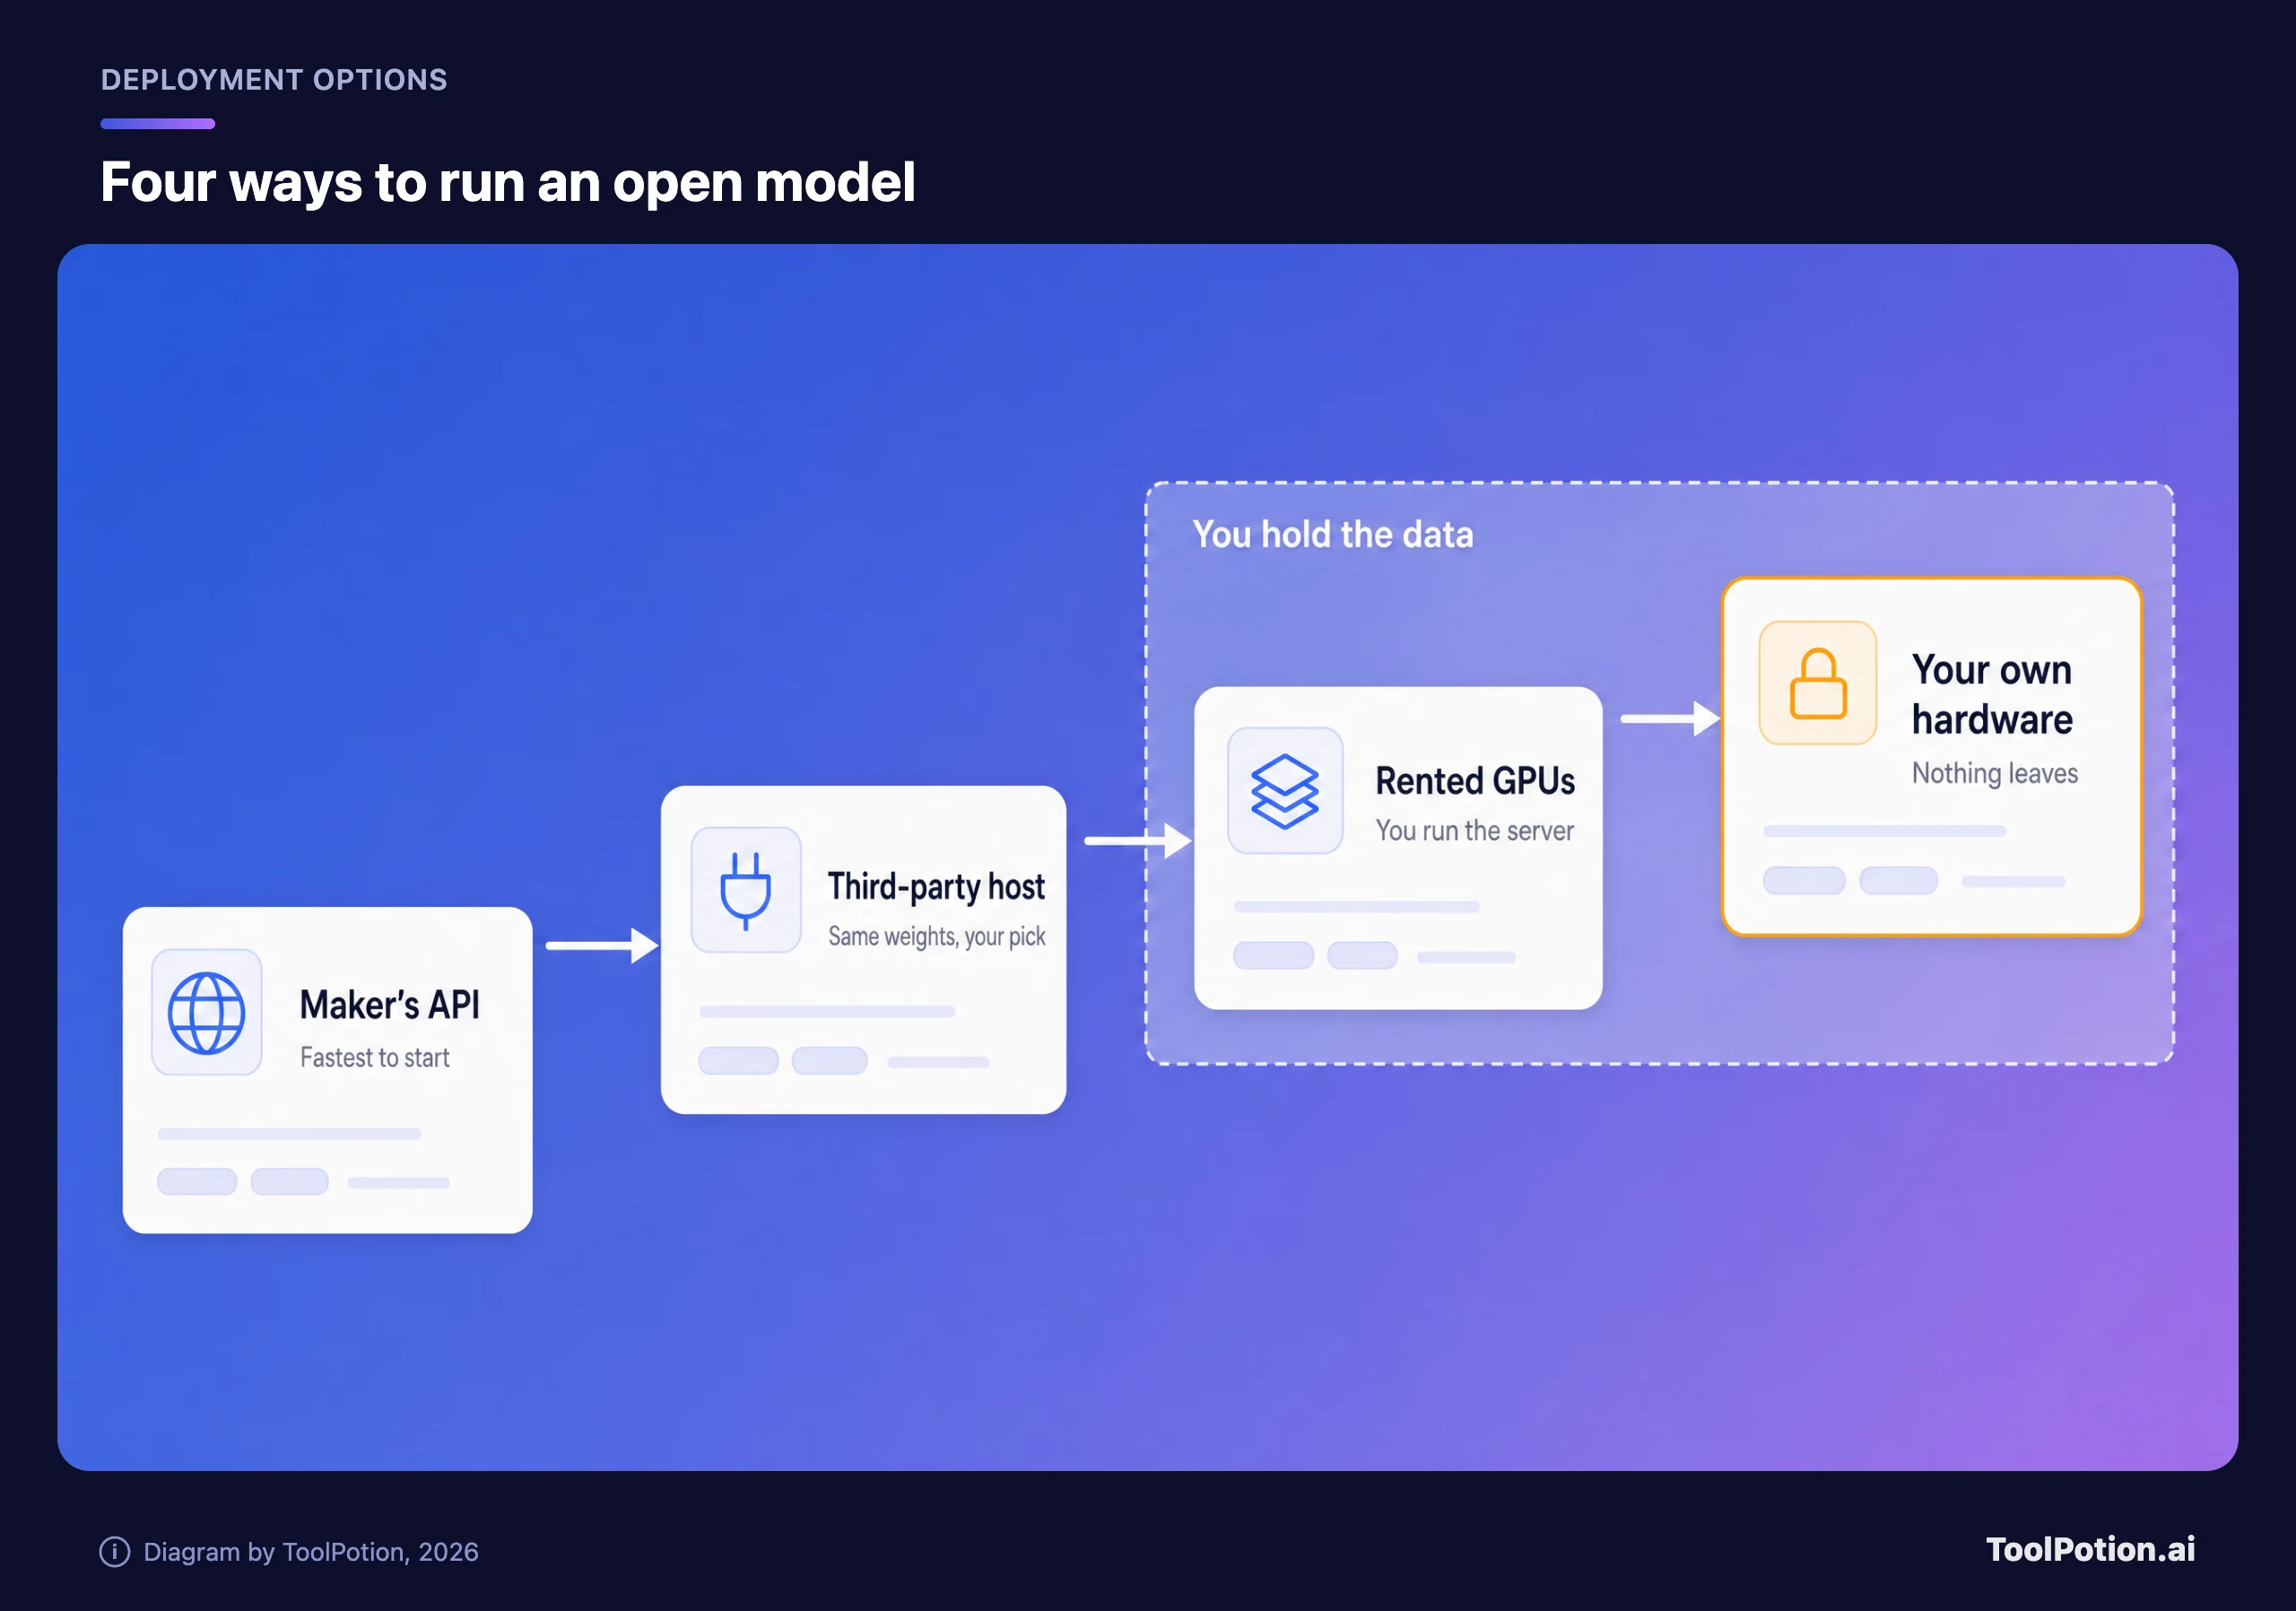
الأوليان مُدارتان. ترسل token إلى الشركة أو إلى مزوّد الاستضافة، وتعبر بياناتك شبكة غيرك. أما الأخيرتان فتضعان النموذج على أجهزة تتحكم فيها، وهذا هو المطلوب إذا نص عقد أو جهة تنظيمية على ألا تغادر البيانات. وتبقى الأوزان التي لا تتسع لها أجهزتك العائق المعتاد، فابدأ بالحجم.
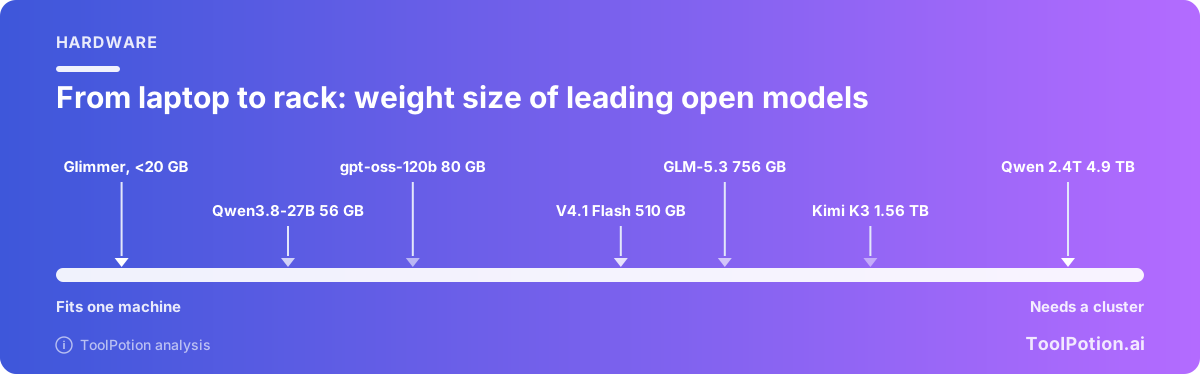
معظم النماذج الكبرى أكبر بكثير من أن تتسع لجهاز واحد. فأوزان Kimi K3 وحدها 1.56 TB، أكثر من 1.44 TB التي تحصل عليها في عقدة من ثماني وحدات GPU من طراز B200 بسعة 180 GB. وDeepSeek V4-Pro وGLM-5.3 يحتاج كل منهما إلى مئات الغيغابايتات. أما النماذج التي تناسب جهازًا واحدًا فهي من فئة 20B إلى 120B. استخدم أداة التقدير للتحقق من نموذج ودقة معينين مقابل عتادك.
جرّب القيم الافتراضية. gpt-oss-120b بتكميم 4 بت يحتاج نحو 70 GB مع الحمل الإضافي، فيناسب وحدة GPU واحدة بسعة 80 GB. بدّل إلى Kimi K3 وستطلب الأداة نفسها عشر وحدات GPU بسعة 180 GB. وعشر وحدات تعني عقدتين من ثماني وحدات. وبسعر Lambda عند الطلب البالغ 6.69 دولار لكل ساعة B200 من صفحة التسعير لدى Lambda، تبلغ كلفة هذه الوحدات الست عشرة وهي تعمل طوال الشهر نحو 78,000 دولار. هذه تكلفة استضافة نموذج مفتوح رائد بنفسك، قبل أن يتولى أحد تشغيله.
الطرف الصغير أرحم بكثير. تدرج Lambda وحدة GPU بسعة 80 GB من 3.99 دولار للساعة، أي نحو 2,900 دولار شهريًا إن عملت على مدار الساعة. وهل هذا أفضل من API؟ يتوقف الأمر كليًا على الحجم.
عند 300 مليون token خرج شهريًا وسعر API قدره 10 دولارات، تتساوى الفاتورتان تقريبًا. وتحت هذا الحجم تفوز API. وفوقه يفوز الاستئجار، بشرط أن تكون وحدة GPU مشغولة وأن يكون النموذج جيدًا بما يكفي للمهمة. لكن المقارنة الصادقة تكون مع مزوّد استضافة رخيص. فبسعر استضافة gpt-oss-120b المدرج، نحو 0.17 دولار لكل مليون token خرج، تشتري 2,900 دولار نحو 17 مليار token خرج، فوحدة GPU مستأجرة واحدة نادرًا ما تتفوق على مزوّد الاستضافة من حيث التكلفة وحدها. استأجر من أجل الخصوصية والتحكم وزمن استجابة متوقع. ولا تستأجر لتوفّر على نموذج صغير.
إليك مثالًا تطبيقيًا بحجم مفترض لكنه معقول. لنقل إن فريق دعم يلخّص 20,000 تذكرة يوميًا، في كل منها 1,500 token دخلًا و300 خرجًا. هذا نحو 900 مليون token دخل و180 مليون خرج شهريًا. على Claude Sonnet 5.5 بسعر 2 و10 دولارات لكل مليون، الفاتورة 3,600 دولار. وعلى DeepSeek V4.1 Flash بأسعار الذروة تبلغ 486 دولارًا على الأكثر، ونصفها خارج الذروة. وعلى gpt-oss-120b بأسعار الاستضافة المدرجة تبلغ نحو 64 دولارًا. أما وحدة GPU مستأجرة بسعة 80 GB فتكلّف 2,913 دولارًا مهما أرسلت إليها. فيفوز مزوّد الاستضافة الرخيص بفارق كبير، ويكلّف النموذج المغلق نحو سبعة أضعاف المفتوح بسعر الشركة نفسها.
اختصاران يفيدان قبل أن تنفق أي شيء. للحاسوب المحمول أو محطة العمل، يشغّل Ollama وllama.cpp نسخًا مكمَّمة من Gemma 4 وQwen3.8-27B وMuse Glimmer بأمر واحد. وللخادم الإنتاجي، فإن vLLM هو محرك التقديم الذي تدرجه بطاقتا Kimi K3 وQwen3.8 ضمن المدعومين.
كيف تختار
ابدأ بقيدك لا بلوحة المتصدرين. ثلاثة أسئلة تفرز معظم الحالات.
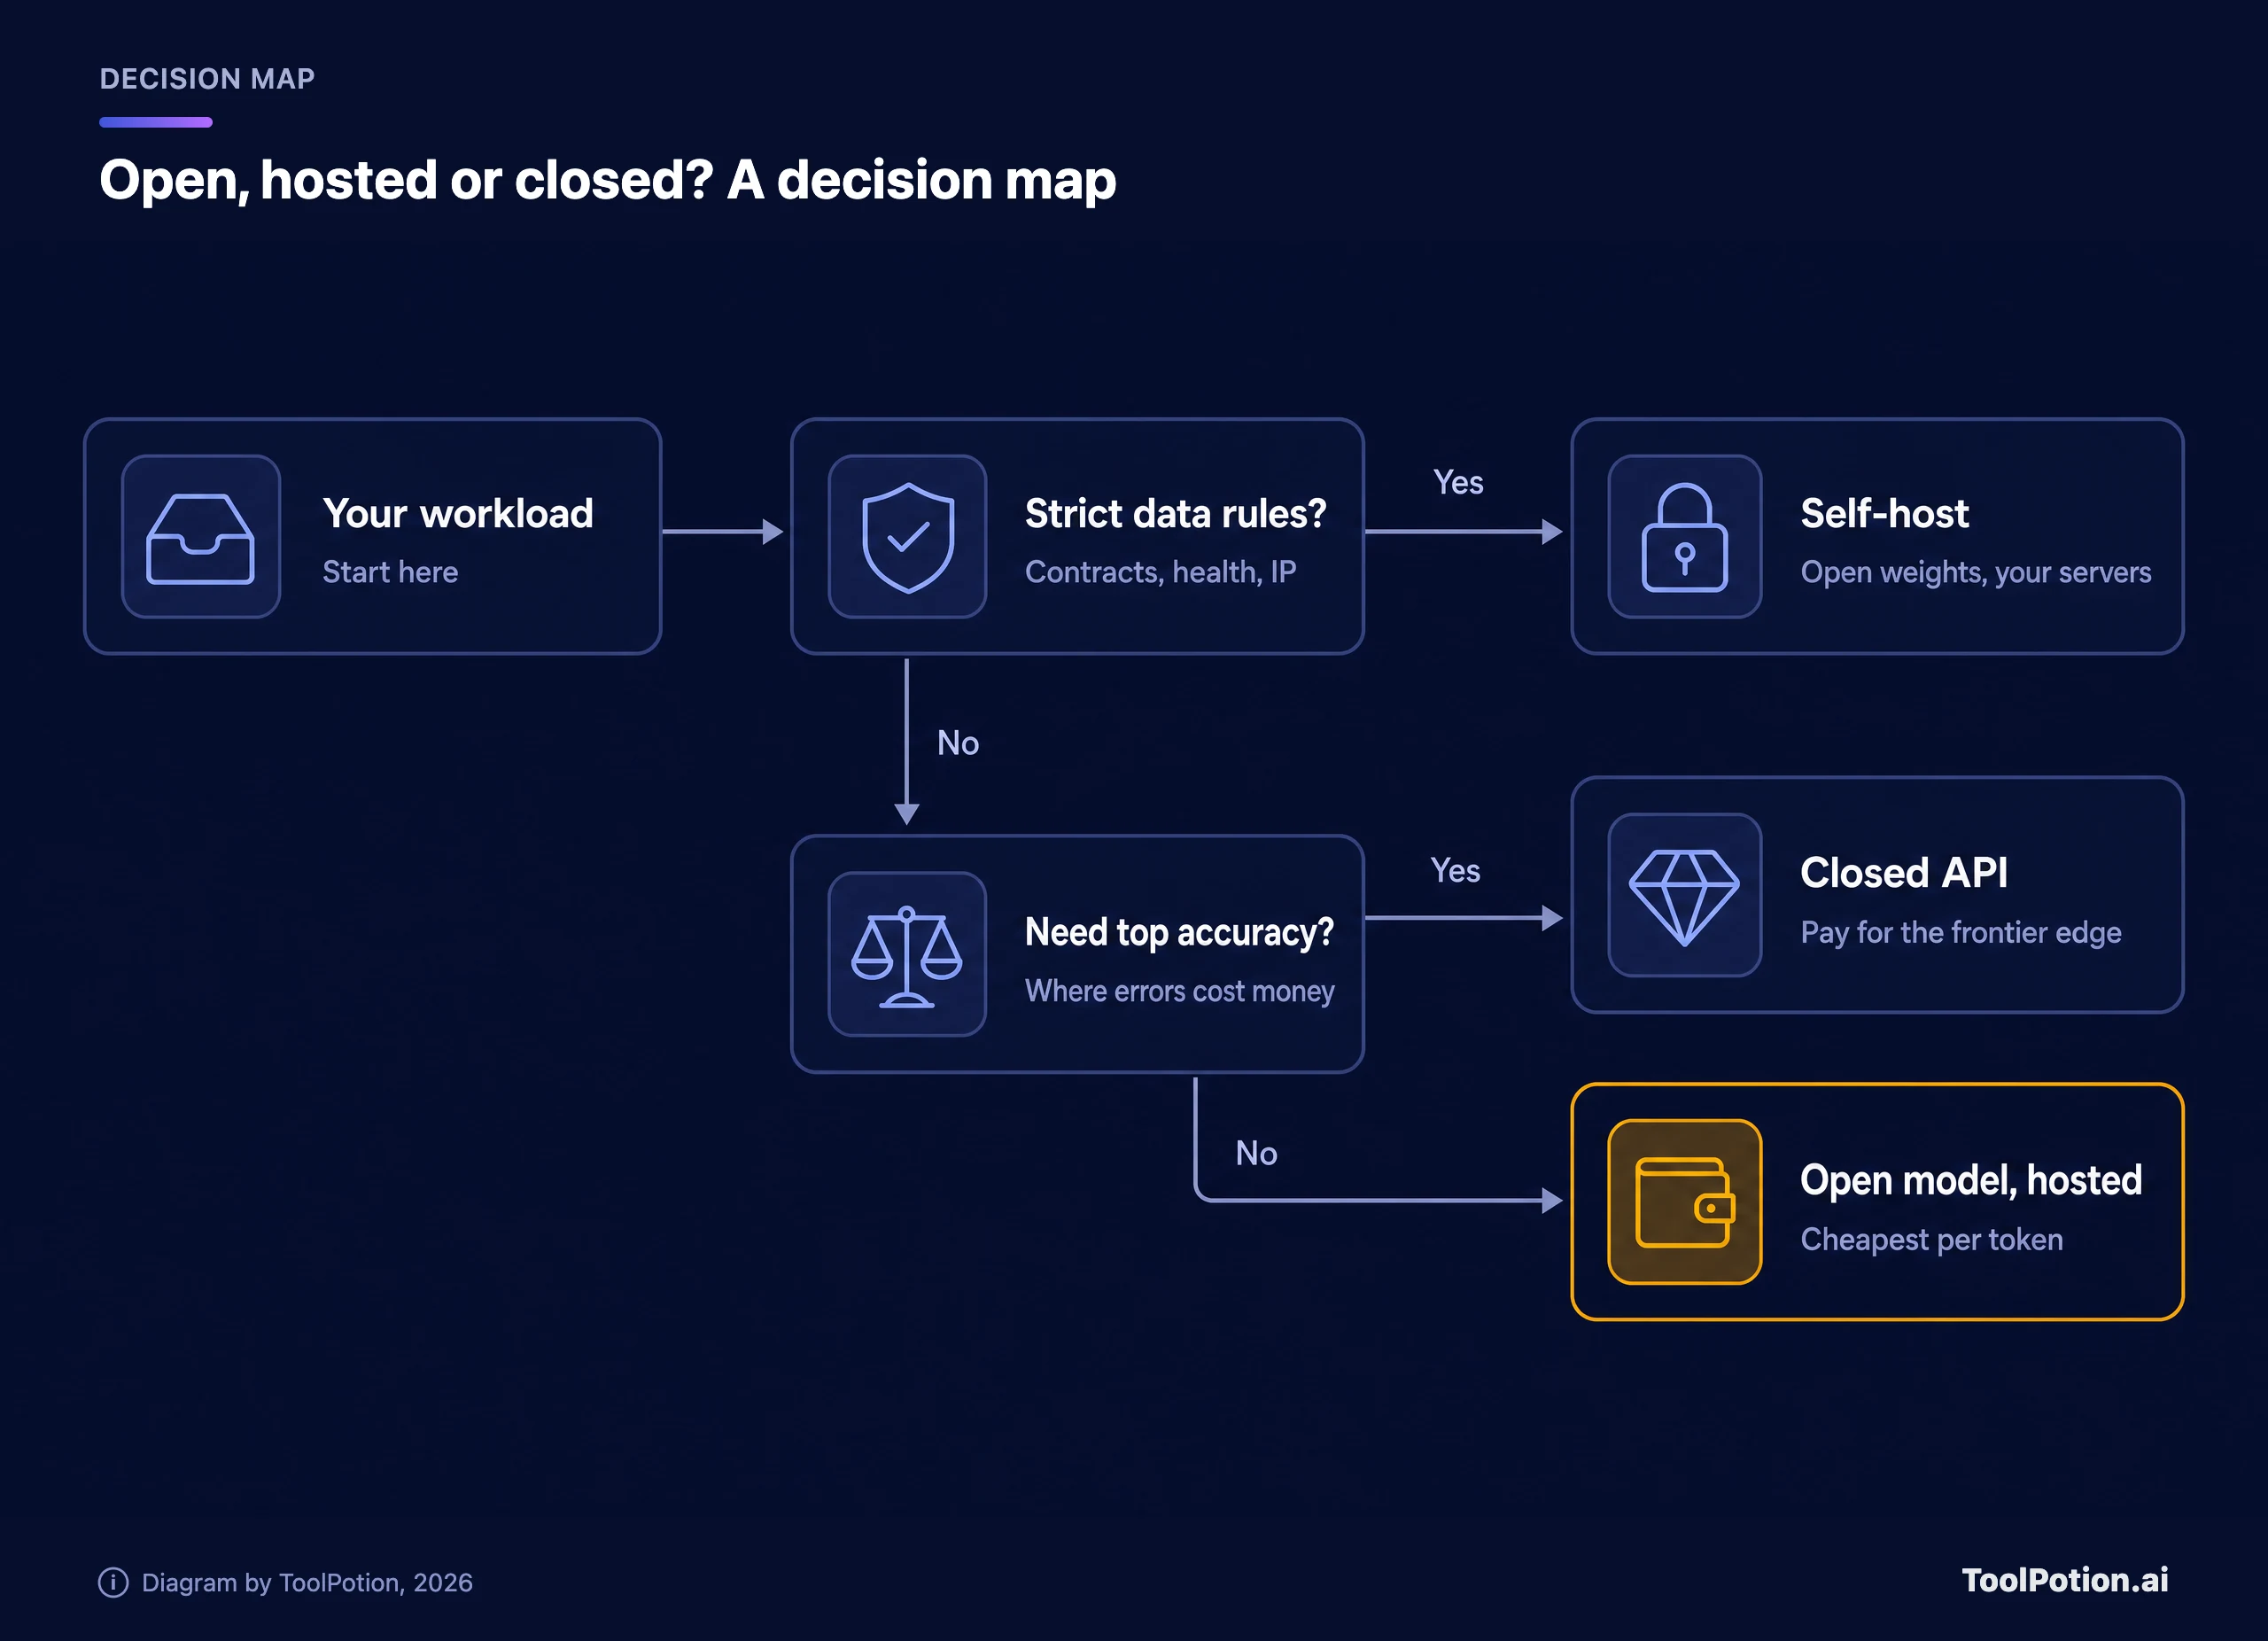
إن كانت بياناتك لا يجوز أن تغادر سيطرتك فأنت ستستضيف بنفسك، ويجب أن يناسب النموذج عتادك. ضمن هذا القيد:
- وحدة GPU واحدة أو محطة عمل: Qwen3.8-27B للبرمجة والوكلاء، وgpt-oss-120b إن أردت نموذجًا غربي الصنع، وMuse Glimmer أو Gemma 4 للحاسوب المحمول.
- خادم متعدد وحدات GPU: DeepSeek V4.1 Flash أو GLM-5.3 إن كنت تستطيع تحمّل ثماني بطاقات كبيرة ومئات الغيغابايتات من الأوزان.
- عنقود: Kimi K3 أو Qwen3.8-2.4T، لكن فقط إن كان لديك فريق يعمل في تشغيل الاستدلال كمهنة.
وإن كان يجوز لبياناتك أن تغادر، فاسأل إن كانت الأخطاء مكلفة. حيث تكون كذلك (مسودات قانونية، وتحليل مالي، وكود يُطلق دون مراجعة)، ادفع لنموذج مغلق رائد واختبره على أمثلتك. وحيث لا تكون (التلخيص، والوسم، والاستخلاص، والبحث الداخلي، ومسودات الكود الأولى)، فنموذج مفتوح عبر مزوّد استضافة رخيص هو أفضل سعر ستجده.
مرّ على هذه القائمة بالترتيب قبل أن تختار:
1. دوّن القيد الذي لا يتحرك: موقع البيانات، أو الميزانية الشهرية، أو حد أدنى للجودة.
2. افحص الترخيص لاستخدامك. المنتج المبني على النموذج مقبول تقريبًا في كل مكان. أما إعادة بيع النموذج فهي موضع القيود.
3. افحص الذاكرة: الأوزان بالغيغابايت مقابل العتاد الذي ستشتريه أو تستأجره فعلًا.
4. سعّر حمل العمل نفسه على API الشركة وعلى مزوّد استضافة خارجي وعلى GPU مستأجرة.
5. مرّر 50 مهمة من مهامك على مرشحين أو ثلاثة، واحتفظ بالفائز.
اختبر قبل أن تلتزم. المقاييس هنا من الشركات نفسها وتُجرى على مجموعات اختبار مختلفة، فالدرجة 90 في لوحة متصدرين تقول القليل عن الدرجة 88 في أخرى. خذ 50 مهمة حقيقية من عملك، ومرّرها على مرشحين أو ثلاثة، وقيّم النتائج. عصر يوم واحد من هذا أفضل من أسبوع في قراءة بطاقات النماذج.
المخاطر التي لا يضعها أحد على بطاقة النموذج
الأمان. الأوزان المفتوحة لا تجعل النموذج آمنًا. ففي تقييمه لعام 2025 لنماذج DeepSeek الأقدم، وجد NIST التابع للحكومة الأمريكية أن أفضلها، R1-0528، امتثل لـ94% من الطلبات الخبيثة الصريحة تحت أساليب كسر الحماية الشائعة، مقابل 8% للنماذج المرجعية الأمريكية. وكان وكلاء DeepSeek أيضًا أكثر عرضة بـ12 مرة لاتباع تعليمات خبيثة مخبأة في المحتوى الذي يعالجونه (NIST CAISI). هذه نماذج أقدم من خط V4 الحالي، ولم يظهر في المصادر التي بُني عليها هذا المقال تقييم عام مماثل للإصدارات الحالية. اعتبر ذلك سببًا للاختبار، خصوصًا قبل أن تمنح النموذج أدوات وصلاحية كتابة.
الرقابة. وجد NIST أيضًا أن نماذج DeepSeek ردّدت روايات غير دقيقة للحزب الشيوعي الصيني بأربعة أضعاف ما فعلته النماذج المرجعية الأمريكية. وفي تقرير منفصل لـNIST عن Kimi K2 Thinking وُجدت رقابة شديدة بالصينية، لكن النموذج كان غير خاضع للرقابة نسبيًا بالإنجليزية والإسبانية والعربية. فإن كان مستخدموك يسألون عن السياسة أو التاريخ بالصينية، فاختبر ذلك مباشرة. وإن كان عملك كودًا وجداول بيانات فنادرًا ما يظهر الأمر.
موقع البيانات. من يستضيف النموذج يحدد إلى أين تذهب بياناتك. تقول سياسة الخصوصية في DeepSeek إنها تجمع البيانات الشخصية وتعالجها وتخزّنها في جمهورية الصين الشعبية (سياسة خصوصية DeepSeek). وهذا ينطبق على تطبيقها وAPI الخاصة بها، لا على الأوزان بترخيص MIT التي تشغّلها في مكان آخر. وتطرح Mistral الطرح المعاكس: تقول إنها درّبت Large 4 في مراكز بياناتها داخل أوروبا، وتشغّل المعاينة بوصفها نشرًا أوروبيًا خاضعًا للقانون الأوروبي. ومع أي مزوّد استضافة، اسأل أين يجري الاستدلال وما الذي يُسجَّل قبل أن ترسل بيانات العملاء.
التقادم. النماذج المفتوحة تتقادم في أشهر. أوزان gpt-oss عمرها عام، وأحدث Llama من Meta يعود إلى 2025، وأصدرت Qwen وDeepSeek كلتاهما عدة إصدارات في 2026 وحده. ثبّت إصدار النموذج الذي اختبرته بالضبط، وأعد الاختبار عند الترقية.
من يجدر به أن يظل يدفع مقابل API مغلقة
الفجوة البالغة 3% هي قراءة مقياس واحد. ما زالت النماذج المغلقة تحتفظ بالصدارة في القمة، والمختبرات التي تبيعها تواصل إضافة أدوات وميزات مُدارة لا تأتي مع الأوزان المفتوحة.
ادفع مقابل Claude أو ChatGPT إن احتجت أفضل دقة في عمل صعب عالي المخاطر، أو لم يكن لديك من يدير البنية التحتية، أو كان الحجم أصغر من أن يهم معه أي ترتيب استضافة. فالفريق الذي يجري بضعة آلاف من الاستدعاءات يوميًا سينفق على وقت المهندسين أقل مما يوفّره من token. وادفع أيضًا إن أردت جهة واحدة تتحمل مسؤولية التشغيل والأمان والدعم.
اخلط ولا تبدّل. الإعداد الشائع يرسل الجزء الروتيني الأكبر إلى نموذج مفتوح عبر مزوّد استضافة، ويصعّد الحالات الصعبة إلى نموذج مغلق. وقواعد التوجيه في دليلنا عن مطابقة فئات النماذج مع المهام تنطبق هنا مباشرة: ابدأ بالرخيص، وصعّد عند الفشل.
الأسئلة الشائعة
ما الفرق بين مفتوح الأوزان ومفتوح المصدر؟
مفتوح الأوزان يعني أن بإمكانك تنزيل النموذج المدرَّب. أما مفتوح المصدر بالمعنى الصارم فيشمل أيضًا بيانات التدريب والكود بترخيص معتمد. وتكاد لا تبلغ أي من نماذج هذه القائمة هذا الحد. نماذج Apache 2.0 وMIT هي الأقرب عمليًا. وتضيف التراخيص المخصصة مثل ترخيصي Kimi وQwen شروطًا.
هل يمكنني استخدام هذه النماذج تجاريًا؟
نعم لبناء منتجات عليها، مع كل التراخيص المذكورة هنا. وتظهر الشروط حين تبيع النموذج نفسه بوصفه خدمة، وفي بعض الحالات حين يكون منتجك ضخمًا. أما نماذج Apache 2.0 وMIT فلا تحمل أي شروط تتعلق بالإيرادات.
أي نموذج مفتوح هو الأفضل للبرمجة؟
بحسب الأرقام التي تعلنها الشركات، يتصدر GLM-5.3 وKimi K3 وDeepSeek V4.1 Flash، وكلها تحتاج إلى عتاد بمستوى الخوادم. أما لجهاز واحد فالخيار العملي Qwen3.8-27B. أجرِ اختباراتك على قاعدة الكود الخاصة بك، فمجموعات الاختبار تختلف.
هل DeepSeek آمن لبيانات الشركة؟
يتوقف الأمر على طريقة التشغيل. تطبيق DeepSeek وAPI الخاصة بها يخزنان البيانات في الصين بموجب السياسة المذكورة أعلاه. أما أوزان MIT التي تشغّلها على خوادمك أو عند مزوّد تثق به فلا ترسل شيئًا إلى DeepSeek. وتبقى مخاطر سلوك النموذج المنفصلة من تقييم NIST الأقدم قائمة.
كم أحتاج من ذاكرة GPU؟
تقريبًا عدد المعاملات مضروبًا في عدد البتات مقسومًا على ثمانية، زائد نحو 20% للذاكرة المؤقتة ووقت التشغيل. نموذج 27B بتكميم 8 بت نحو 33 GB مع الحمل الإضافي. ونموذج 117B بتكميم 4 بت نحو 70 GB. وتجري الأداة أعلاه الحسابات نيابة عنك.
متى سيصبح Mistral Large 4 مفتوحًا؟
وعدت Mistral بنشر الأوزان بعد الإعلان بوقت قصير، ولم تنشر شروط الترخيص. تحقق من صفحتها على Hugging Face قبل أن تبني خططك عليه.