跳转到主要内容
ToolPotion
AI 顾问
提交(免费)

WeMM-Video-35B-A3B

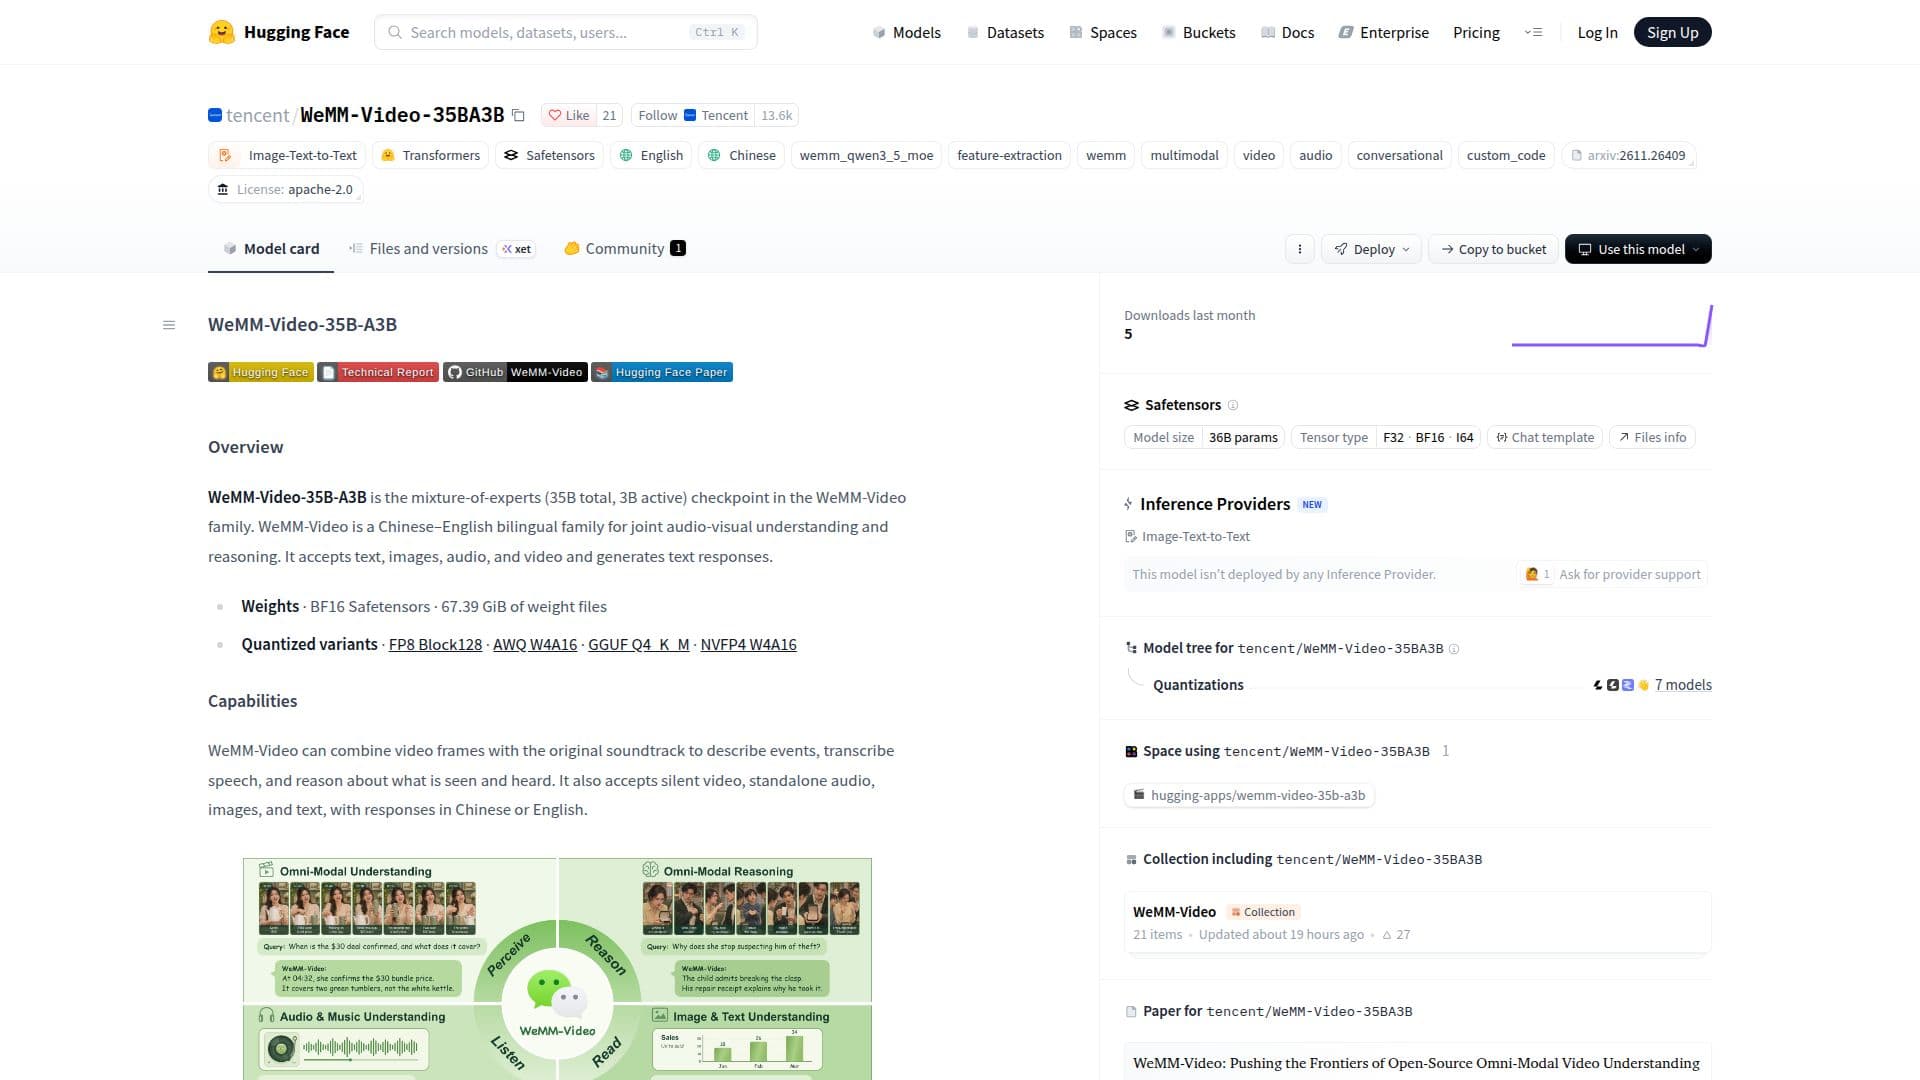
WeMM-Video-35B-A3B 是 WeMM-Video 系列中的一种专家混合模型,旨在实现音视频的联合理解和推理。该中英双语模型接受文本、图像、音频和视频输入,以生成文本响应。它能够描述事件、转录语音,并对所见和所闻进行推理,提供直接和推理响应模式。

访问URL
分享
WeMM-Video-35B-A3B 截图

WeMM-Video-35B-A3B 是一种复杂的专家混合模型,属于更广泛的 WeMM-Video 系列,旨在实现全面的音视频理解和推理。该模型具有 350 亿个参数和 30 亿个活跃参数,专门设计用于处理和解释多模态输入,包括文本、图像、音频和视频,能够生成中文或英文的连贯文本响应。

阅读更多

该模型的核心能力包括将视频帧与其原始音轨结合,以描述事件,准确转录语音,并基于视觉和听觉信息执行推理任务。它还足够灵活,可以独立处理无声视频、独立音频、图像和文本输入。这使得它适用于需要深度上下文理解的各种应用,涵盖不同媒体类型。

在架构上,WeMM-Video-35B-A3B 使用视觉和音频编码器将媒体输入转换为标记,然后与文本一起由语言模型处理。视频帧附加时间戳以保持时间上下文。该模型系列在大约 1.2 万亿个多模态标记上进行了广泛的预训练,随后采用了多教师 OPD、反重复 MrDPO 和专业强化学习等先进的后训练技术,以增强其性能和稳健性。

通过各种服务选项,部署和集成变得更加便捷。用户可以设置 Transformers 环境,并直接从 WeMM-Video 仓库运行示例。该模型支持量化变体,如 FP8 Block128、AWQ W4A16、GGUF Q4_K_M 和 NVFP4 W4A16。在服务方面,它与 vLLM(0.18.0 和 0.31.0)和 SGLang(0.5.16 或 0.5.19)的修补版本兼容,允许高效推理,包括跨多个 GPU 的张量并行。该模型还提供不同的聊天模式,包括默认的指令模式和用于推理响应的“思考模式”。

WeMM-Video-35B-A3B 展现了强大的性能,确立了新的开源最先进水平。它已被证明在性能上超越了 Qwen3.5-Omni-Flash 和 Seed2.0-Mini-0428 等专有模型,显著缩小了与 Gemini-3.0-Flash 等先进模型的性能差距。该模型在 Apache License 2.0 下发布,促进了 AI 社区的开放访问和合作。

  • 类别AI 模型与大语言模型
  • 定价模式开源
  • 部署云端
  • 平台网页版

  • 中英双语处理

  • 联合音视频理解和推理

  • 接受文本、图像、音频和视频输入

  • 生成文本响应

  • 从视频帧和音轨描述事件

  • 从音频转录语音

  • 对视觉和听觉信息进行推理

  • 支持无声视频和独立音频处理

  • 专家混合架构(总计 35B,活跃参数 3B)

  • 在 1.2 万亿多模态标记上进行预训练

  • 使用多教师 OPD 和 MrDPO 进行后训练

  • 专业强化学习以增强性能

  • 支持各种量化变体(FP8、AWQ、GGUF、NVFP4)

  • 与修补的 vLLM 和 SGLang 兼容以进行服务

  • 提供指令和思考聊天模式

  1. 设置环境:安装 Transformers 环境及必要的依赖项。

  2. 加载模型:从 Hugging Face Hub 加载 WeMM-Video-35B-A3B 模型和处理器。

  3. 准备输入:提供媒体输入,如 MP4 视频文件、独立音频、图像或文本。

  4. 处理媒体:使用脚本单独处理视频帧或与原始音轨一起处理。

  5. 生成响应:向模型发送请求,指定聊天模式(指令或思考)以生成文本。

  6. 服务模型(可选):安装 WeMM 运行时补丁,并使用修补的 vLLM 或 SGLang 进行 API 服务。

  7. 发送 API 请求:使用捆绑的请求客户端将媒体内联发送到与 OpenAI 兼容的聊天端点。

  • 视频内容分析
  • 语音转录
  • 多模态推理
  • 双语内容处理
  • 音视频事件描述
  • AI 模型开发
  • 研究与实验

与 WeMM-Video-35B-A3B 类似的热门AI工具

Llama-3.2-11B-Vision-Instruct 是一个多模态 AI 模型,旨在进行视觉识别、图像推理和图像描述。由 Meta 开发,它整合了文本和图像输入,以提供先进的图像理解能力。

AI 模型与大语言模型
查看工具

多模态 AI 模型,旨在进行视觉识别、图像推理和图像描述。由 Meta 开发,它整合了文本和图像输入,以提供先进的图像理解能力。Llama-3.2-11B-Vision-Instruct 是一个多模态 AI 模型,旨在进行视觉识别、图像推理和图像描述。由 Meta 开发,它整合了文本和图像输入,以提供先进的图像理解能力。

AI 模型与大语言模型
查看 AI 模型 Top 5

第3.7步闪电

大语言模型

第3.7步闪电是一个稀疏的专家混合视觉语言模型,旨在处理高频生产工作负载。它结合了语言主干和视觉编码器,以支持解析财务报告和运行多步骤搜索循环等密集任务。

AI 模型与大语言模型

大语言模型 排名第 81 位

查看工具

大语言模型

稀疏的专家混合视觉语言模型,旨在处理高频生产工作负载。它结合了语言主干和视觉编码器,以支持解析财务报告和运行多步骤搜索循环等密集任务。第3.7步闪电是一个稀疏的专家混合视觉语言模型,旨在处理高频生产工作负载。它结合了语言主干和视觉编码器,以支持解析财务报告和运行多步骤搜索循环等密集任务。

AI 模型与大语言模型
大语言模型 排名第 81 位

Apertus 1.5

大语言模型

Apertus 1.5 是一系列多语言、多模态的语言模型,旨在支持广泛的语言和上下文。它提供开源访问和改进的推理能力,使其适用于多种人工智能应用。

AI 模型与大语言模型

大语言模型 排名第 72 位

查看工具

大语言模型

一系列多语言、多模态的语言模型,旨在支持广泛的语言和上下文。它提供开源访问和改进的推理能力,使其适用于多种人工智能应用。Apertus 1.5 是一系列多语言、多模态的语言模型,旨在支持广泛的语言和上下文。它提供开源访问和改进的推理能力,使其适用于多种人工智能应用。

AI 模型与大语言模型
大语言模型 排名第 72 位

Llama-4 Maverick 17B-128E Instruct 是由 Meta 开发的多模态 AI 模型,旨在实现先进的文本和图像理解。它利用专家混合架构在各种应用中提供高性能。

AI 模型与大语言模型
查看工具

由 Meta 开发的多模态 AI 模型,旨在实现先进的文本和图像理解。它利用专家混合架构在各种应用中提供高性能。Llama-4 Maverick 17B-128E Instruct 是由 Meta 开发的多模态 AI 模型,旨在实现先进的文本和图像理解。它利用专家混合架构在各种应用中提供高性能。

AI 模型与大语言模型
查看 AI 模型 Top 5

Nemotron-Labs-Audex-2B

大语言模型

Nemotron-Labs-Audex-2B 是一个统一的音频-文本大型语言模型,旨在处理音频任务,如理解、识别和翻译。它支持思考和指令模式,为多种音频和文本应用提供紧凑高效的解决方案。

AI 模型与大语言模型

大语言模型 排名第 33 位

查看工具

大语言模型

统一的音频-文本大型语言模型,旨在处理音频任务,如理解、识别和翻译。它支持思考和指令模式,为多种音频和文本应用提供紧凑高效的解决方案。Nemotron-Labs-Audex-2B 是一个统一的音频-文本大型语言模型,旨在处理音频任务,如理解、识别和翻译。它支持思考和指令模式,为多种音频和文本应用提供紧凑高效的解决方案。

AI 模型与大语言模型
大语言模型 排名第 33 位

Gemini 3.1 Pro 是一款先进的人工智能模型,旨在处理复杂任务和深度推理。它在多模态理解方面表现出色,提供智能且简洁的响应,非常适合学习、规划和构建创新应用。

AI 模型与大语言模型
查看工具

先进的人工智能模型,旨在处理复杂任务和深度推理。它在多模态理解方面表现出色,提供智能且简洁的响应,非常适合学习、规划和构建创新应用。Gemini 3.1 Pro 是一款先进的人工智能模型,旨在处理复杂任务和深度推理。它在多模态理解方面表现出色,提供智能且简洁的响应,非常适合学习、规划和构建创新应用。

精选AI 模型与大语言模型
查看 AI 模型 Top 5

Llama-4-Scout-17B-16E-Instruct 是 Meta 设计的多模态 AI 模型。它利用专家混合架构提供先进的文本和图像理解能力,支持多语言输出和针对多种应用的微调。

AI 模型与大语言模型
查看工具

Meta 设计的多模态 AI 模型。它利用专家混合架构提供先进的文本和图像理解能力,支持多语言输出和针对多种应用的微调。Llama-4-Scout-17B-16E-Instruct 是 Meta 设计的多模态 AI 模型。它利用专家混合架构提供先进的文本和图像理解能力,支持多语言输出和针对多种应用的微调。

AI 模型与大语言模型
查看 AI 模型 Top 5

Qwen3-VL

AI GitHub 仓库

Qwen3-VL 是阿里云 Qwen 团队推出的一系列视觉语言模型,提供密集型和专家混合型两种规模,包含指令版和推理版("思考")。它能够同时读取图像、视频和文本,具有原生 256K 上下文窗口,可扩展至 1M,并具备用于 GUI 自动化、OCR 和空间推理的功能。

AI 模型与大语言模型
查看工具

AI GitHub 仓库

阿里云 Qwen 团队推出的一系列视觉语言模型,提供密集型和专家混合型两种规模,包含指令版和推理版("思考")。它能够同时读取图像、视频和文本,具有原生 256K 上下文窗口,可扩展至 1M,并具备用于 GUI 自动化、OCR 和空间推理的功能。Qwen3-VL 是阿里云 Qwen 团队推出的一系列视觉语言模型,提供密集型和专家混合型两种规模,包含指令版和推理版("思考")。它能够同时读取图像、视频和文本,具有原生 256K 上下文窗口,可扩展至 1M,并具备用于 GUI 自动化、OCR 和空间推理的功能。

AI 模型与大语言模型
查看 AI GitHub 仓库 Top 250
1/8