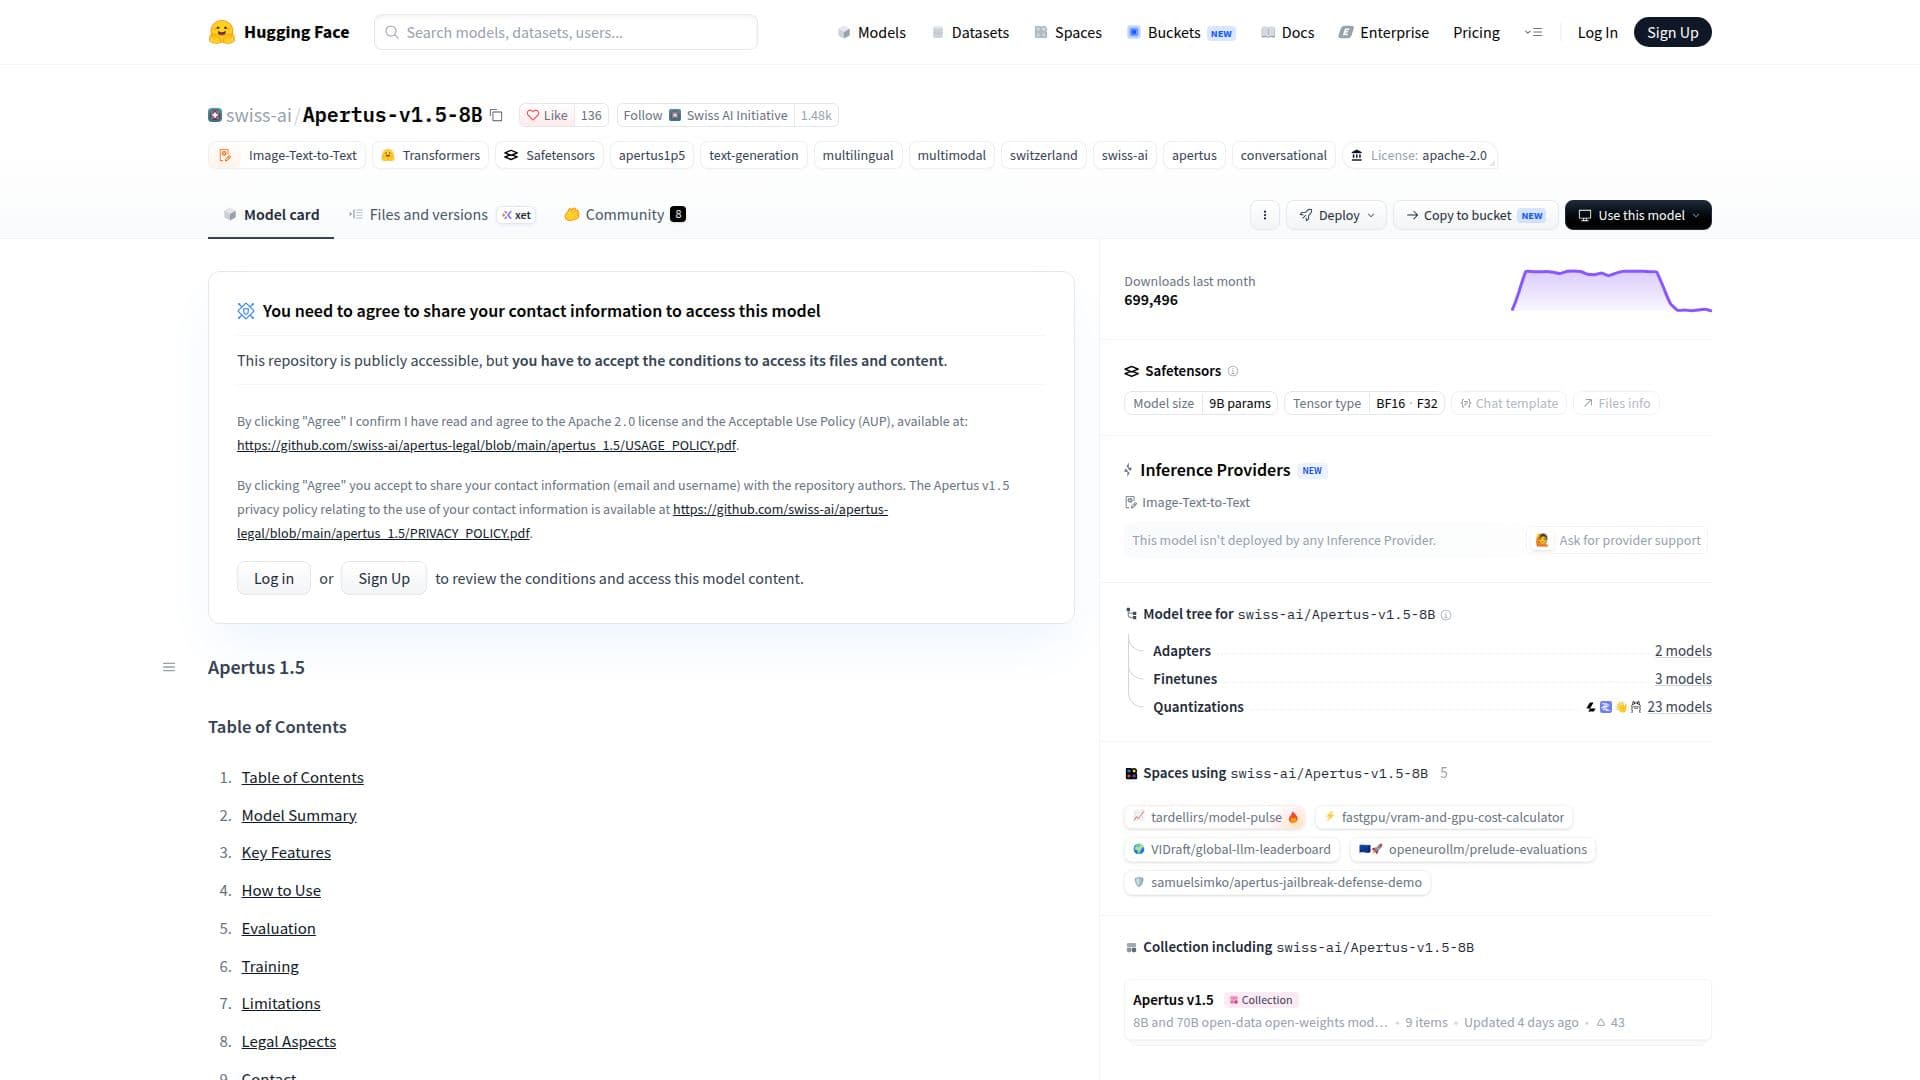
描述
Apertus 1.5 是一系列先进的语言模型,旨在增强多语言和多模态的人工智能能力。该模型具有 80 亿和 700 亿参数,支持多种语言,并能够处理多达 262,144 个标记的上下文。这使其在各种应用中具有高度的灵活性,从文本生成到复杂的推理任务。
阅读更多
这些模型基于仅解码器的变换器架构构建,并使用大量数据进行预训练,包括 80 亿模型的 4 万亿标记和 700 亿模型的 2 万亿标记的多模态混合数据。这种广泛的训练使 Apertus 1.5 能够处理和生成来自图像、音频和文本输入的文本,为开发人员创造创新应用提供了新的可能性。
Apertus 1.5 在设计时考虑了负责任的开发,尊重数据所有者的选择退出同意,并采用方法防止训练数据的记忆。模型完全开放,公开权重、数据和训练细节,确保透明性和可访问性。
这些模型还引入了“思考模式”,增强了它们的推理能力,使其能够提供更准确和上下文相关的响应。此功能结合改进的指令遵循和工具使用能力,使 Apertus 1.5 成为开发人员希望将先进的人工智能功能集成到其项目中的强大工具。
Apertus 1.5 的部署支持在开源框架中,如 Transformers 和 vLLM,并提供详细的入门说明。该模型可在桌面和云环境中使用,为各种部署场景提供灵活性。
- 类别AI 模型与大语言模型
- 定价模式开源
- 部署云端, 自托管
- 平台网页版
Apertus 1.5亮点
多语言支持
多模态输入处理
开源访问
长上下文处理
改进的推理能力
增强的指令遵循
工具使用集成
负责任的数据处理
Apertus 1.5入门
访问模型页面:访问 Hugging Face 上的 Apertus 1.5 页面
身份验证:登录或注册以访问模型
配置:设置模型参数和环境
发送提示:输入文本、图像或音频进行处理
微调:调整模型设置以适应特定任务
Apertus 1.5的使用案例
- 多语言文本生成
- 多模态内容创建
- 高级推理任务
- 指令遵循
- 工具集成