描述
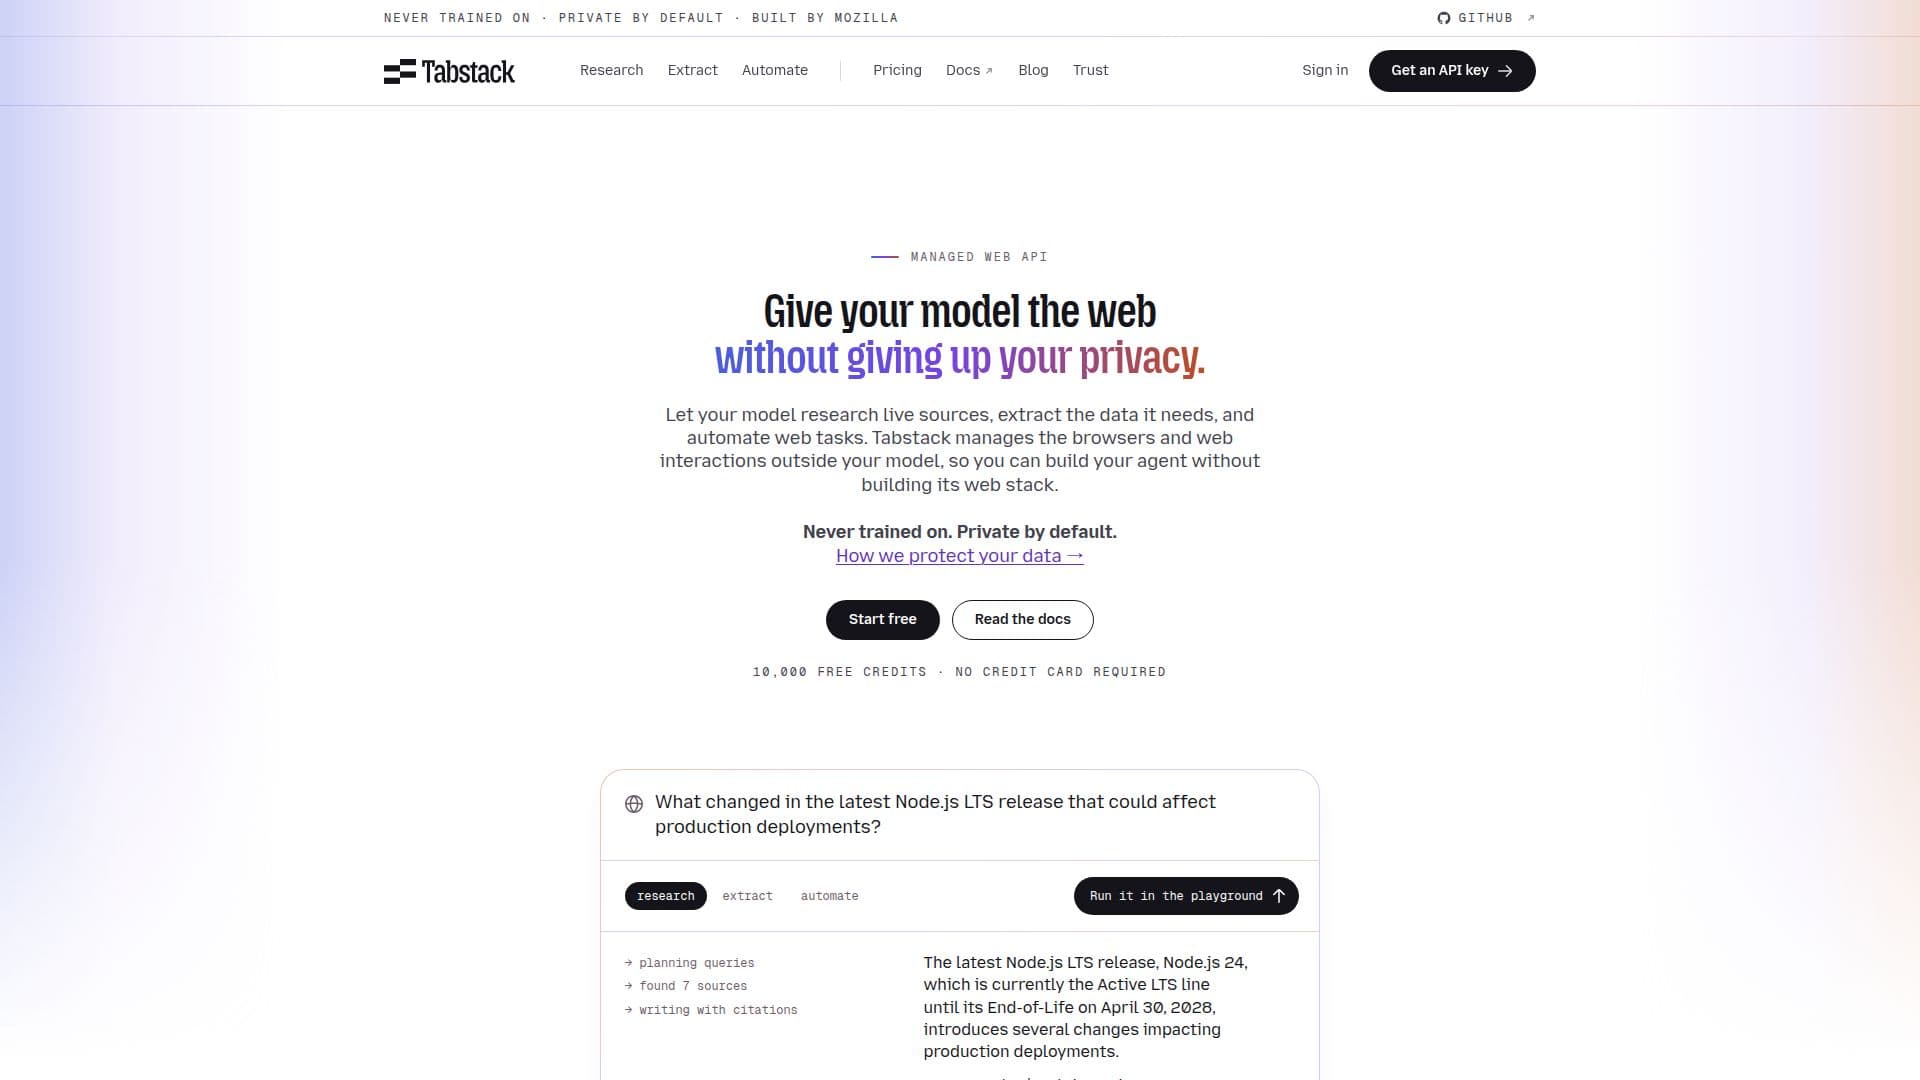
Tabstack 提供一个全面的托管网络 API,旨在为 AI 模型提供互联网访问,同时优先考虑隐私。它允许模型进行网络研究、提取结构化数据并自动化浏览器任务,而无需管理复杂的网络基础设施。这意味着开发人员可以构建复杂的 AI 代理,而无需开发和维护自己的网络堆栈来获取、渲染和与网页交互。
阅读更多
该平台通过其 API 提供几个关键功能。研究端点使模型能够提出问题并从实时网络来源获取引用答案,消除了模型需要自己运行每个搜索和阅读每个页面的必要性。对于数据提取,用户可以传递一个 URL 和一个可选的 JSON 架构,Tabstack 将获取、渲染并清理页面内容,以纯文本或与指定架构匹配的结构化 JSON 返回。此外,自动化端点允许模型描述一个网络任务和一个起始 URL,Tabstack 处理导航和交互,返回结果和任务事件。
Tabstack 强调数据隐私和安全性。它由 Mozilla 构建,并承诺绝不在客户负载上训练模型。数据默认是私密的,组织管理员可以控制请求历史记录的收集。详细的数据收集在控制台中可以关闭,保留请求内容 90 天以进行故障排除。然而,操作和安全日志仍然适用。对于需要身份验证或完全控制浏览器环境的工作流程,Tabstack 提供 Pilo,一个用于自托管的开源自动化引擎。
该服务与现有的 AI 代理框架和 SDK 无缝集成,包括 Python、TypeScript、CLI、Hermes、LangChain、LlamaIndex、Mastra、Vercel AI SDK、OpenAI Agents 和 Claude Agent。这使开发人员能够使用熟悉的工具将网络访问纳入当前工作流程。Tabstack 采用基于信用的系统,在创建账户时提供 10,000 个免费信用额度,无需信用卡。付费计划 — Starter、Team 和 Pro — 根据包含的信用额度、研究模式(快速和平衡)、速率限制和超额定价进行扩展,确保个别工作流程到生产级工作负载的灵活性。企业选项可用于自定义配额和支持。
- 类别浏览器与网页自动化
- 定价模式免费增值
- 部署云端
- 平台网页版
Tabstack的核心功能
托管的 AI 模型网络 API
默认私密的数据处理
绝不在客户负载上训练
带引用的网络研究
从 URL 提取结构化数据
用于网络任务的浏览器自动化
支持多种研究模式(快速、平衡)
用于自托管的开源自动化引擎(Pilo)
与流行的 AI 框架和 SDK 集成
提供 Python SDK
提供 TypeScript SDK
用于 Shell 和代理工作流程的 CLI
可定制的请求历史记录收集
90 天的请求历史保留(启用时)
用于评估的免费信用额度
如何使用 Tabstack?
创建账户:在 Tabstack.ai 上注册一个免费账户以获得 10,000 个免费信用额度。
安装 SDK/CLI:安装 Tabstack 的 Python 或 TypeScript SDK,或用于 Shell 工作流程的 CLI。
身份验证:获取您的 API 密钥并使用它来验证您的调用。
进行研究调用:使用 `/research` 端点和查询从实时网络来源获取引用答案。
提取数据:将 URL 和可选的 JSON 架构传递给 `/extract/json` 或 `/extract/markdown` 端点以获取干净的结构化数据。
自动化任务:描述一个公共网络任务和一个起始 URL 到 `/automate` 端点以进行浏览器交互。
监控使用情况:在控制台中跟踪您的信用使用情况并管理详细的数据收集设置。
升级计划:根据您的使用需求选择付费计划(Starter、Team、Pro),以获得更多信用和更高的速率限制。
Tabstack的使用案例
- AI 代理的网络研究
- 结构化数据提取
- 自动化网络任务
- 知识库更新
- 带引用的内容生成
- 竞争分析
- 市场情报收集
- 记录实时来源