描述
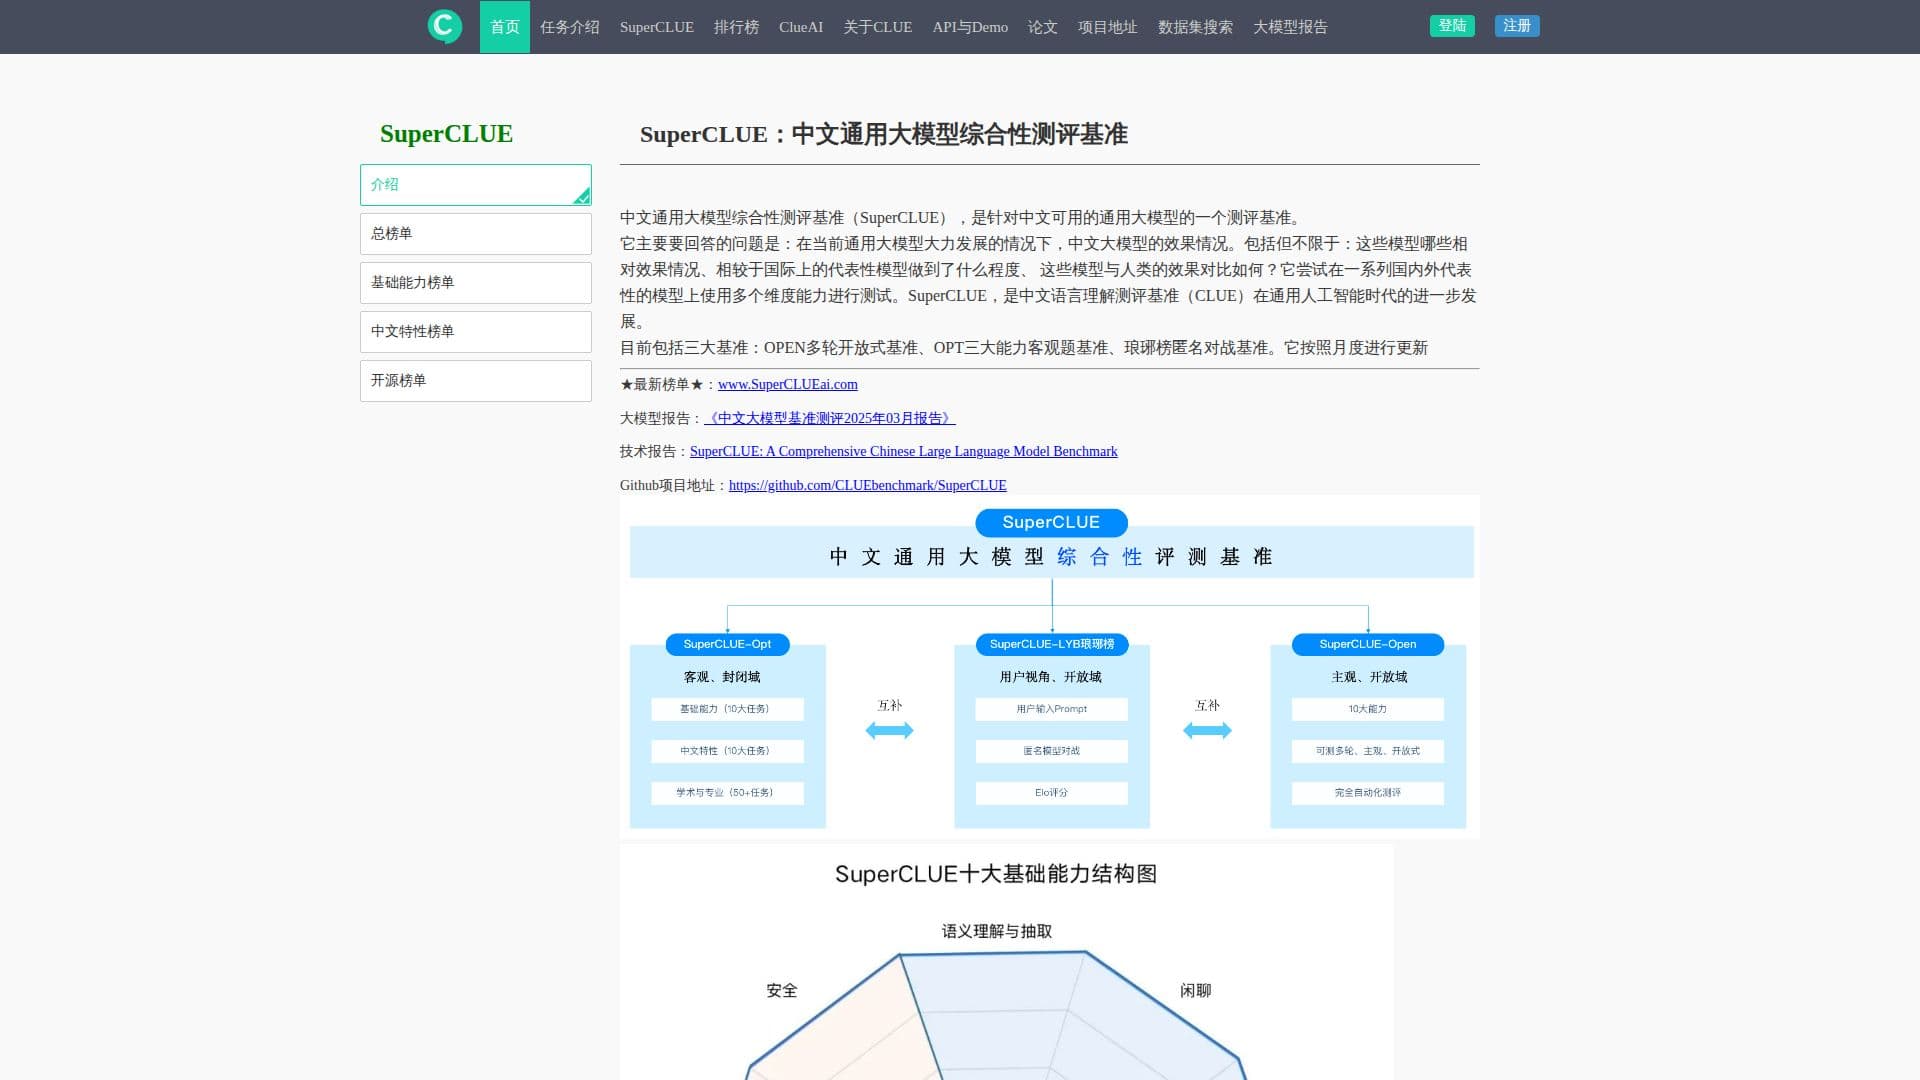
SuperCLUE 是一个旨在评估中文通用大模型的基准。它旨在回答关于这些模型在快速发展的通用人工智能领域中的有效性的重要问题。SuperCLUE 从多个维度评估模型,包括相对有效性、与国际代表模型的比较以及与人类基准的表现。
阅读更多
该基准是中文语言理解评估(CLUE)基准的演变,专为通用人工智能时代量身定制。它包括三个主要基准:OPEN 多轮开放基准、OPT 三能力客观题基准和 Langya List 匿名对抗基准。SuperCLUE 每月更新,以反映人工智能模型的最新进展。
该基准根据模型的整体得分、基础能力、中文语言特征和学术能力对模型进行排名。例如,在 2023 年 7 月,人类模型得分最高,其次是 OpenAI 的 GPT-4 和百度的文心一言等模型。该基准还提供了各种能力的详细得分,如语义理解、对话、角色扮演、知识和百科、生成与创作、逻辑与推理、编码、计算和安全。
SuperCLUE 是中国人工智能社区的重要工具,提供了一种标准化的方法来衡量和比较人工智能模型的表现。通过提供全面的评估框架,它有助于识别不同模型的优缺点,从而指导未来的人工智能技术发展。
- 类别机器学习平台
- 定价模式免费
- 部署云端
- 平台网页版
SuperCLUE的核心功能
中文人工智能模型的全面基准
每月更新
多维度评估
与国际模型比较
与人类表现比较
详细的能力得分
包含三个主要基准
标准化评估框架
如何使用 SuperCLUE?
访问:访问 SuperCLUE 网站
选择:选择感兴趣的基准
评估:查看模型排名和得分
比较:分析与其他模型的表现
SuperCLUE的使用案例
- 模型评估
- 研究比较
- 能力分析
- 性能基准测试
- 开发指导