跳转到主要内容
ToolPotion
AI 顾问
提交(免费)

Scrapfly - 网络爬虫 API

AI 应用网页抓取与数据提取按用量计费 · 网页

Scrapfly 提供全面的网络爬虫 API,使用户能够高效地从公共网站提取数据。凭借托管代理、JavaScript 渲染和用户友好的界面等功能,它简化了开发人员和企业的数据收集过程。

访问URL
分享
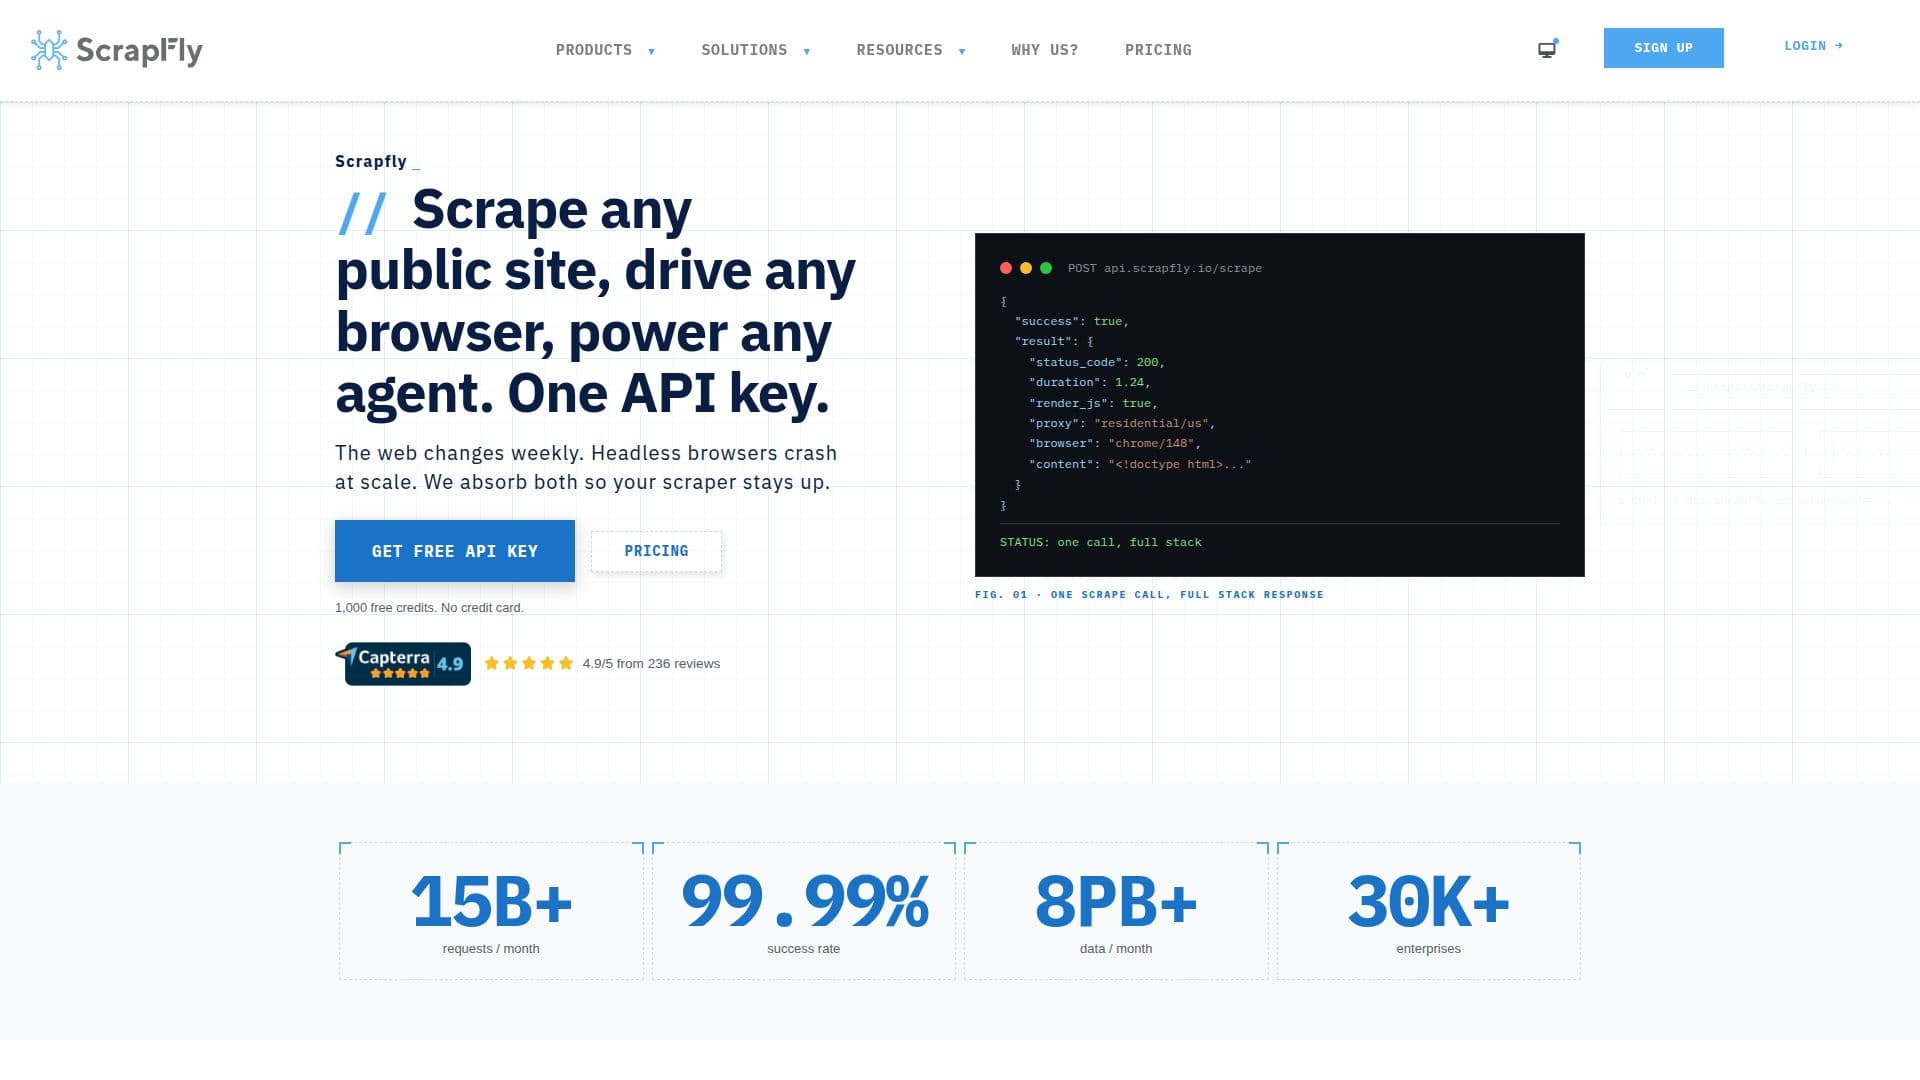
Scrapfly - 网络爬虫 API 截图

Scrapfly 是一个强大的网络爬虫 API,旨在促进从公共网站提取数据。它提供一个 API 密钥,可靠地访问网络数据,包括通过 CDP 管理的 Chromium、住宅代理、屏幕截图和结构化提取。该平台特别适合希望自动化数据收集的开发人员和企业,无需管理代理或无头浏览器的复杂性。

阅读更多

Scrapfly 的一个突出特点是其简单性。与其他需要为每个目标进行广泛配置的平台不同,Scrapfly 在单个端点上运行。通过使用参数 <code>asp=true</code>,用户可以无缝处理会话管理、代理轮换和 JavaScript 渲染。这意味着用户只需为成功的请求付费,使其成为一种具有成本效益的网络爬虫解决方案。

Scrapfly 还符合各种安全标准,持有 SOC 2 Type I、Type II 和 Type III 认证,以及 ISO 27001、HIPAA 和 GDPR 认证。这种合规性确保用户可以信任 Scrapfly 处理他们的数据和操作,尤其是在企业环境中。

该平台提供多种定价计划,从包含 1,000 个积分的免费层开始,允许用户在没有任何财务承诺的情况下测试服务。付费计划的费用高达每月 500 美元,提供 550 万个积分,满足不同的使用需求。定价模型基于使用量,这意味着用户根据消耗的 API 积分数量收费,失败的请求不产生任何费用。

Scrapfly 的功能超越了简单的爬虫。它支持多种输出格式,包括 HTML、Markdown、纯文本和 JSON,使其在不同应用中具有多样性。此外,它与 AI 代理和其他工具良好集成,增强了其对高级用户的功能。总体而言,Scrapfly 是希望简化网络爬虫工作,同时确保可靠性和合规性的理想选择。

  • 类别网页抓取与数据提取
  • 定价模式按用量计费
  • 部署云端
  • 平台网页

  • 单一 API 端点

  • 托管代理

  • JavaScript 渲染

  • 结构化输出格式

  • 基于使用的定价

  • 提供免费层

  • 符合 SOC 2 标准

  • 支持多种编程语言

  • 失败请求的自动重试

  • 最多支持 100 个并发请求

  1. 配置:设置您的 API 密钥并选择所需参数。

  2. 请求:使用 API 从目标网站抓取数据。

  3. 检索:访问 API 返回的结构化数据。

  4. 监控:检查是否有错误,并在需要时利用重试机制。

  • 数据提取
  • 市场研究
  • 内容聚合
  • 价格监控
  • SEO 分析

Scrapfly 评价

加载中...

与 Scrapfly 类似的热门AI工具

ScrapingBee

AI 应用

ScrapingBee 是一个网络爬虫 API,通过管理代理和无头浏览器简化数据提取,使用户能够高效地专注于收集所需数据。

网页抓取与数据提取
查看工具

AI 应用

网络爬虫 API,通过管理代理和无头浏览器简化数据提取,使用户能够高效地专注于收集所需数据。ScrapingBee 是一个网络爬虫 API,通过管理代理和无头浏览器简化数据提取,使用户能够高效地专注于收集所需数据。

网页抓取与数据提取
查看 AI 应用 Top 250

ScraperAPI

AI 应用

ScraperAPI 是一个网络爬虫 API,允许用户从任何公共网站收集数据,而无需管理代理、浏览器或验证码的麻烦。它提供 5,000 次免费的 API 调用以供入门。

网页抓取与数据提取
查看工具

AI 应用

网络爬虫 API,允许用户从任何公共网站收集数据,而无需管理代理、浏览器或验证码的麻烦。它提供 5,000 次免费的 API 调用以供入门。ScraperAPI 是一个网络爬虫 API,允许用户从任何公共网站收集数据,而无需管理代理、浏览器或验证码的麻烦。它提供 5,000 次免费的 API 调用以供入门。

网页抓取与数据提取
查看 AI 应用 Top 250

WebScraping.AI 提供一个由AI驱动的API,用于从任何网站提取数据。它处理代理、浏览器和验证码,提供干净的HTML、文本或结构化的AI提取数据。非常适合需要可扩展网页抓取而无需管理基础设施的开发者。

网页抓取与数据提取
查看工具

提供一个由AI驱动的API,用于从任何网站提取数据。它处理代理、浏览器和验证码,提供干净的HTML、文本或结构化的AI提取数据。非常适合需要可扩展网页抓取而无需管理基础设施的开发者。WebScraping.AI 提供一个由AI驱动的API,用于从任何网站提取数据。它处理代理、浏览器和验证码,提供干净的HTML、文本或结构化的AI提取数据。非常适合需要可扩展网页抓取而无需管理基础设施的开发者。

网页抓取与数据提取
查看 AI 应用 Top 250

Scrapingdog

AI 应用

Scrapingdog 是一个全方位的网页抓取 API,能够为您管理代理和无头浏览器。它提供 40 多个专用端点,用于一般抓取、谷歌、社交媒体和电子商务数据,按信用系统计费。

网页抓取与数据提取
查看工具

AI 应用

全方位的网页抓取 API,能够为您管理代理和无头浏览器。它提供 40 多个专用端点,用于一般抓取、谷歌、社交媒体和电子商务数据,按信用系统计费。Scrapingdog 是一个全方位的网页抓取 API,能够为您管理代理和无头浏览器。它提供 40 多个专用端点,用于一般抓取、谷歌、社交媒体和电子商务数据,按信用系统计费。

网页抓取与数据提取
查看 AI 应用 Top 250

Octoparse

AI 应用

Octoparse 是一款强大的网络抓取工具,旨在高效地从网站提取数据。它提供用户友好的界面和可视化工作流,使用户能够收集大量数据用于分析和商业智能。该工具支持各种数据提取需求,使其适用于不同的项目。

网页抓取与数据提取
查看工具

AI 应用

强大的网络抓取工具,旨在高效地从网站提取数据。它提供用户友好的界面和可视化工作流,使用户能够收集大量数据用于分析和商业智能。该工具支持各种数据提取需求,使其适用于不同的项目。Octoparse 是一款强大的网络抓取工具,旨在高效地从网站提取数据。它提供用户友好的界面和可视化工作流,使用户能够收集大量数据用于分析和商业智能。该工具支持各种数据提取需求,使其适用于不同的项目。

网页抓取与数据提取
查看 AI 应用 Top 250

XCrawl

AI 应用

XCrawl 是一个 AI 准备好的网页抓取 API,可以将任何网站转换为结构化的 JSON、Markdown、HTML 或截图,内置代理、爬虫和 SERP 数据,适用于开发者和 AI 代理。

网页抓取与数据提取

网页抓取与数据提取 排名第 49 位

查看工具

AI 应用

AI 准备好的网页抓取 API,可以将任何网站转换为结构化的 JSON、Markdown、HTML 或截图,内置代理、爬虫和 SERP 数据,适用于开发者和 AI 代理。XCrawl 是一个 AI 准备好的网页抓取 API,可以将任何网站转换为结构化的 JSON、Markdown、HTML 或截图,内置代理、爬虫和 SERP 数据,适用于开发者和 AI 代理。

网页抓取与数据提取
网页抓取与数据提取 排名第 49 位

ScrapeGraphAI

AI 应用

ScrapeGraphAI 是一个基于 AI 的网页抓取 API,使用自然语言提示从网站提取结构化数据。它消除了对代理、选择器和维护的需求,提供与 AI 代理的无缝集成。

网页抓取与数据提取

数据分析师 排名第 113 位

查看工具

AI 应用

基于 AI 的网页抓取 API,使用自然语言提示从网站提取结构化数据。它消除了对代理、选择器和维护的需求,提供与 AI 代理的无缝集成。ScrapeGraphAI 是一个基于 AI 的网页抓取 API,使用自然语言提示从网站提取结构化数据。它消除了对代理、选择器和维护的需求,提供与 AI 代理的无缝集成。

网页抓取与数据提取
数据分析师 排名第 113 位

Scrapy

AI 应用

Scrapy 是一个开源的 Python 网络爬虫框架,旨在快速高效地提取数据。它为开发者提供了强大的工具,以无缝地爬取网站、提取结构化数据并管理大规模爬虫项目。

网页抓取与数据提取
查看工具

AI 应用

开源的 Python 网络爬虫框架,旨在快速高效地提取数据。它为开发者提供了强大的工具,以无缝地爬取网站、提取结构化数据并管理大规模爬虫项目。Scrapy 是一个开源的 Python 网络爬虫框架,旨在快速高效地提取数据。它为开发者提供了强大的工具,以无缝地爬取网站、提取结构化数据并管理大规模爬虫项目。

网页抓取与数据提取
查看 AI 应用 Top 250
1/8