描述
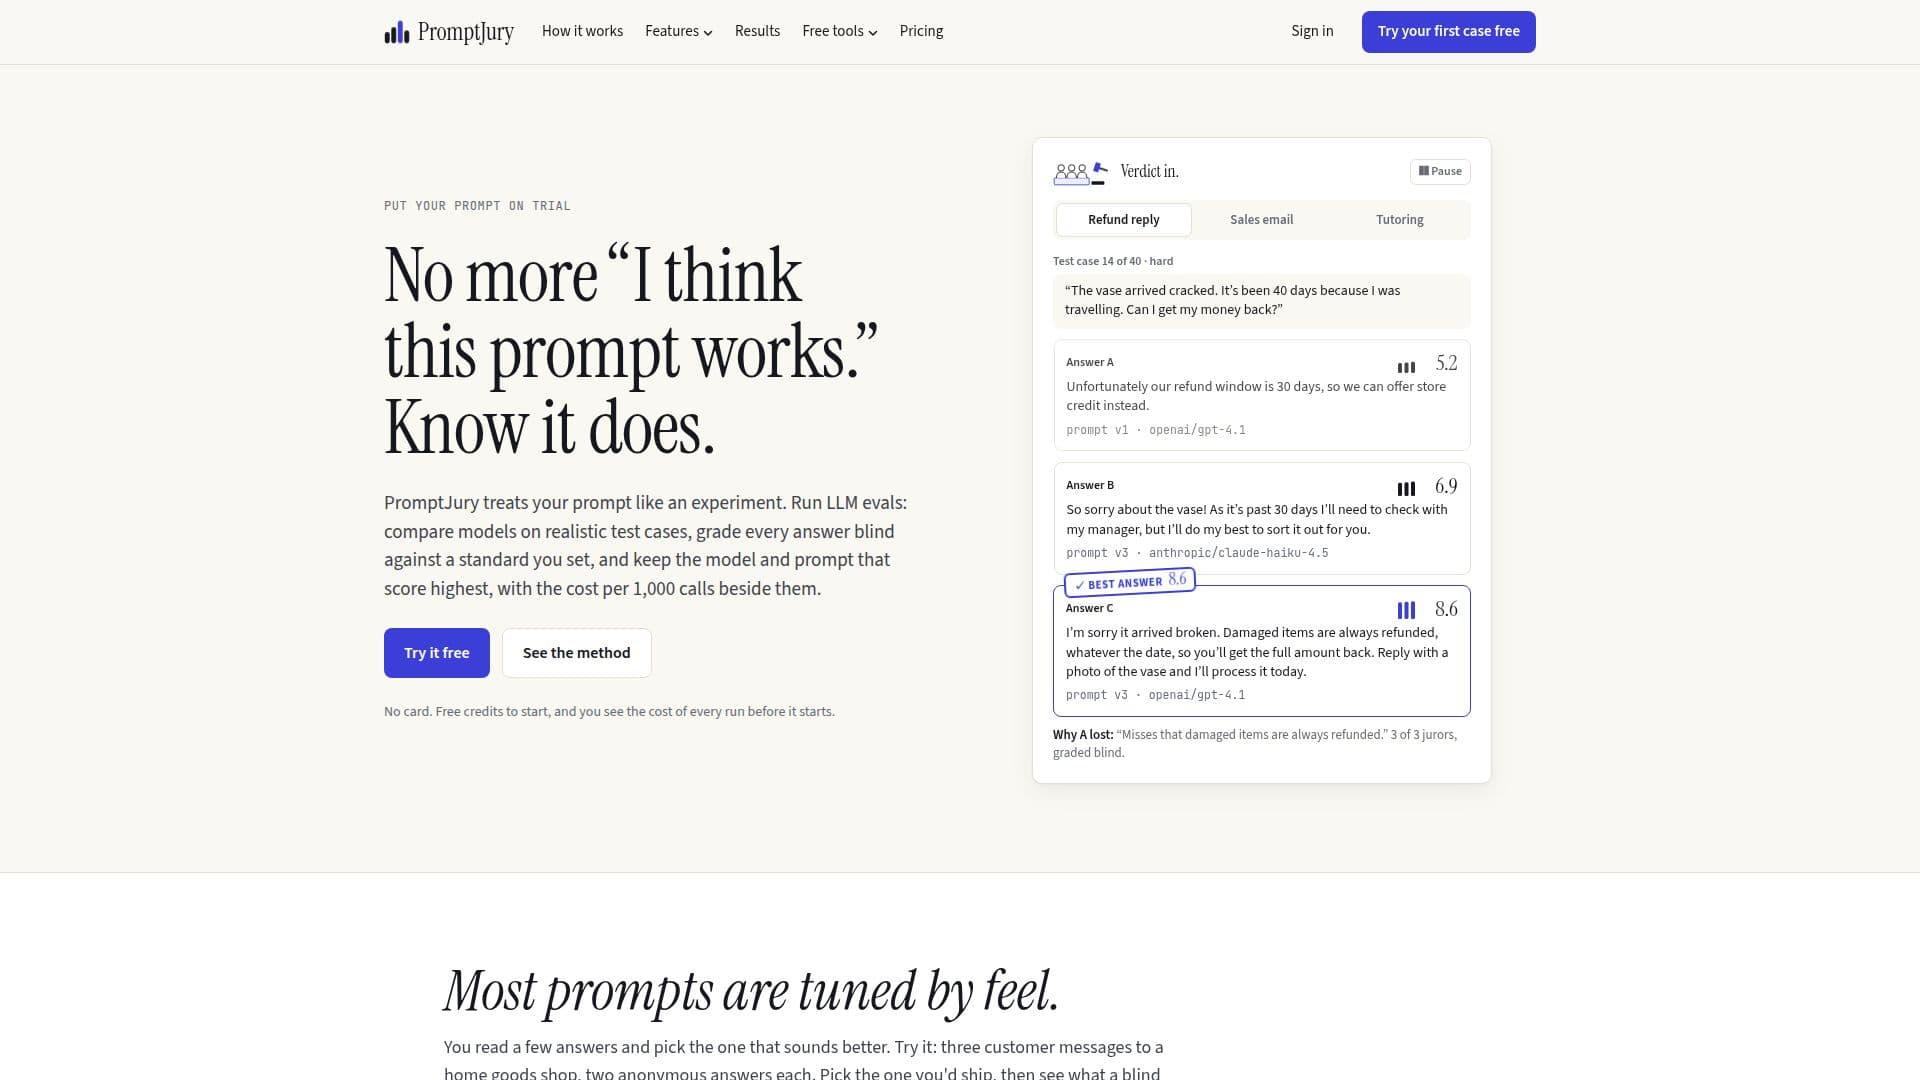
PromptJury 提供一个全面的平台,用于评估大型语言模型(LLM)和提示,旨在帮助用户根据数据做出关于其 AI 应用的决策。该服务允许个人和团队在自定义提示上运行 LLM 评估,比较像 GPT、Claude 和 Gemini 这样的模型,使用盲评测试用例。这一过程揭示了哪些模型和提示组合获得了最高分,以及每个选项的成本,为提示工程提供了科学的方法。
阅读更多
与需要 SDK、自定义配置和用户提供测试集的开发者中心评估平台不同,PromptJury 简化了整个评估工作流程。它自动生成评分指南和测试用例,起草竞争提示,并使用来自不同制造商的多样化模型进行盲评。该平台随后提供明确的推荐,包括获胜的提示、模型及其相关成本,所有这些都不需要任何编码专业知识。
PromptJury 通过在评分开始之前建立“好答案”的明确定义,确保其评估的科学严谨性。每个提示和模型都接受相同的测试用例,评分是盲进行的。每个分数都以范围的形式呈现,使用户能够准确评估对其提示或模型所做的任何更改的影响。该系统通过确保评分标准由用户批准、来自不同制造商的多个模型在不知道来源的情况下评分答案,以及没有模型对自己的输出进行评分,来解决 AI 评分 AI 的担忧。来自三个或更多评分者的中位数分数防止了单一苛刻或宽容评审者的偏见。
用户可以比较 OpenRouter 实时列表上可用的任何聊天模型,包括来自 OpenAI、Anthropic、Google、xAI、DeepSeek 和 Mistral 的产品。该平台还帮助识别出与顶级竞争者表现相当的更便宜的模型,提供“价值选择”与获胜者并列。这包括每千次调用的成本数据和基于用户定义的调用量的潜在月度节省。新账户可获得 200 个免费积分,以便在不需要信用卡的情况下进行初步评估,付费计划起价为每月 25 美元。该服务不需要 API 密钥、SDK 或 OpenRouter 账户,因为所有模型调用都通过 PromptJury 自己的 OpenRouter 账户管理,并使用用户积分支付。该平台通过允许用户定义评分的质量维度及其书面示例来支持主观输出。用户还可以通过 CSV 或 JSONL 文件上传自己的测试用例,或编辑系统生成的测试用例。PromptJury 明确表示,它不会对用户的提示或数据进行训练,确保用户内容的隐私和控制。
- 类别提示词工程工具
- 定价模式免费增值
- 部署云端
- 平台网页版
PromptJury的核心功能
LLM 评估平台
比较 GPT、Claude、Gemini 和其他模型
盲评测试用例
自动生成测试用例
自动创建评分指南
起草竞争提示
无代码评估过程
显示每千次调用的成本
识别价值选择(最便宜的好模型)
支持主观输出评分
上传自定义测试用例(CSV、JSONL)
不需要 API 密钥或 SDK
不对用户数据进行训练
定期回归测试(重试)
私人裁决报告
如何使用 PromptJury?
描述任务:用两句话定义您的 AI 目标及其受众。
创建评分指南:逐维度批准优秀答案的标准,并为每个维度设定评分标准。
生成竞争提示:允许模型起草竞争提示,并根据您的评分指南相互批评。
收集测试用例:使用系统生成的真实输入或上传您自己的 CSV/JSONL 文件。
进行盲试:每个提示和模型回答每个测试用例,由一个独立小组盲评答案。
审查裁决并改进:获取最佳提示和模型,并提供证据和进一步改进的建议。
PromptJury的使用案例
- 提示优化
- 模型比较
- 质量保证
- 成本效率
- 主观输出评分
- 回归测试
- 客户报告
- AI 功能开发