描述
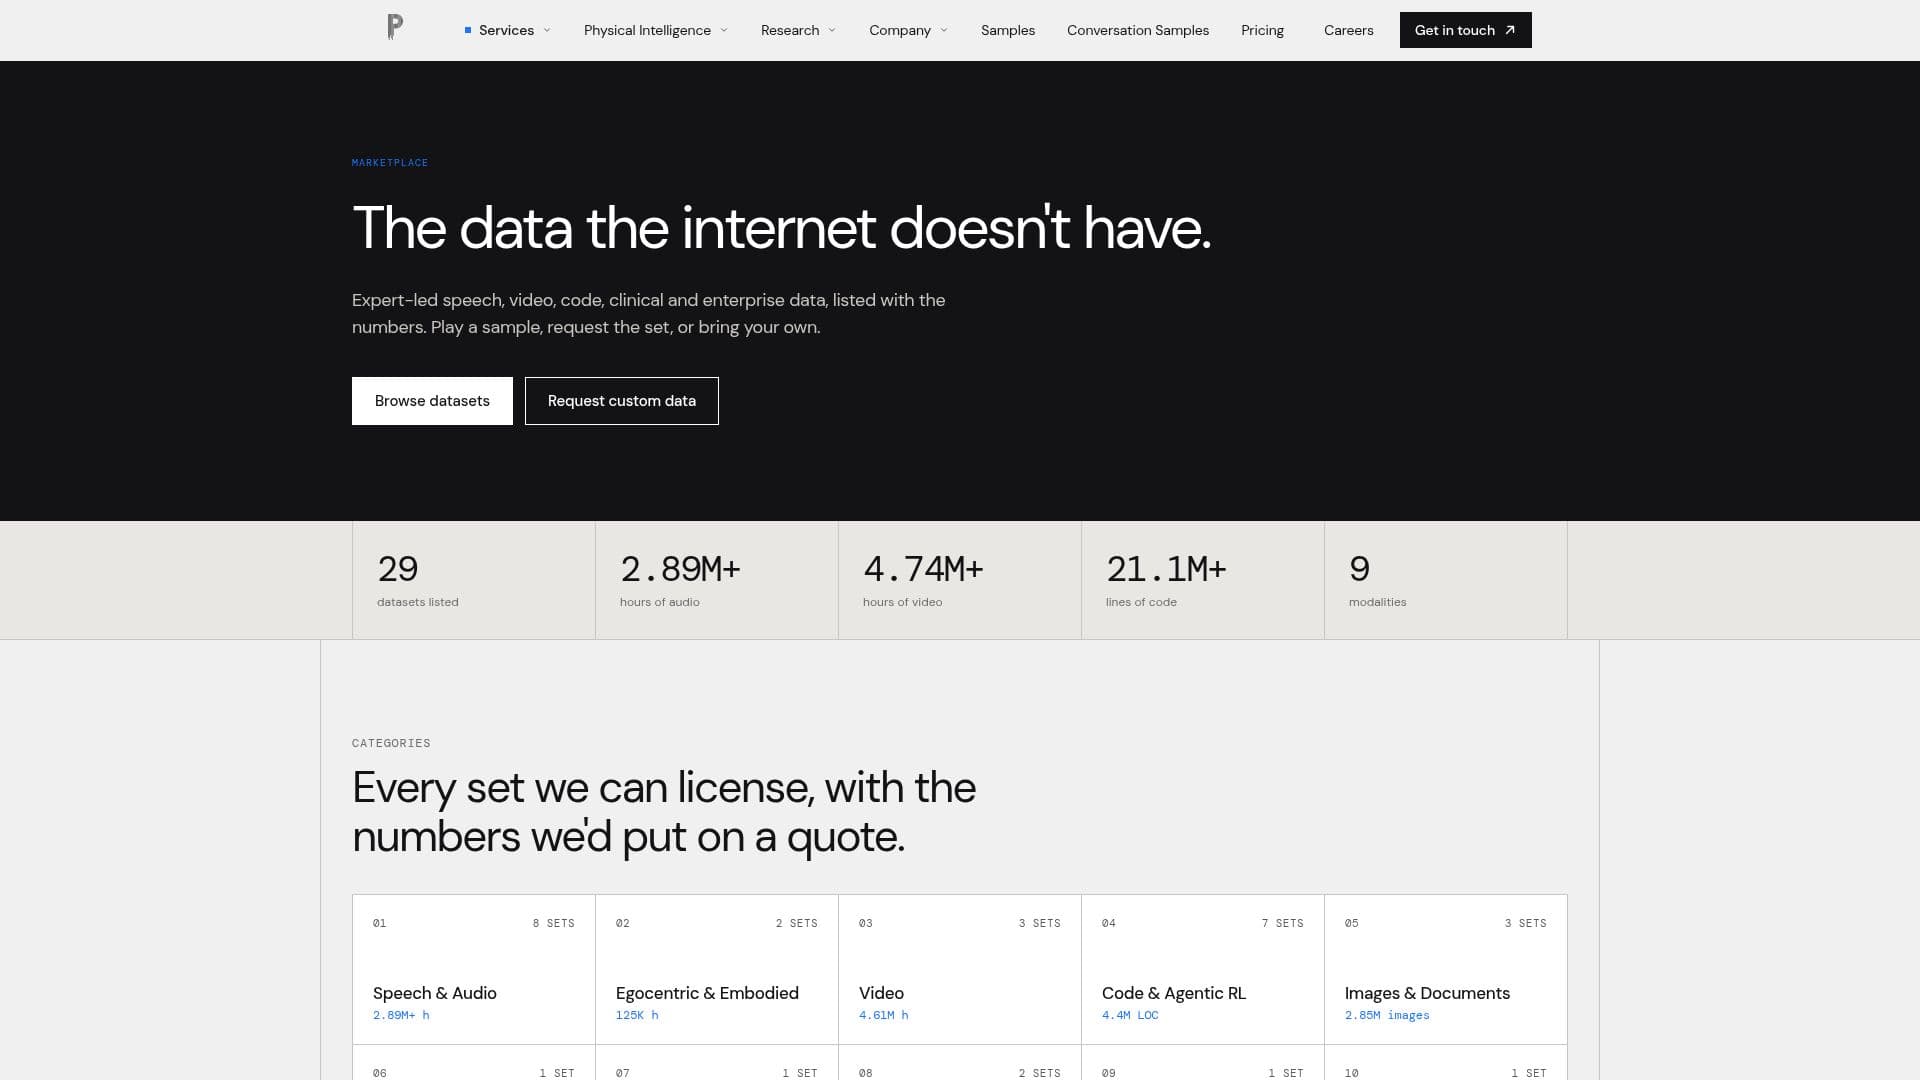
Perit 运营一个专门的数据市场,旨在为人工智能和机器学习应用提供高质量的训练数据。该平台提供 29 个不同的数据集,涵盖 10 个类别,包括 122 种语言的广泛语音集合、自我中心和一般视频、生产代码库、代理强化学习环境、现场文档和临床队列。每个数据集列表提供关键细节,如数量、格式、许可状态和可用性,确保用户的透明度。
阅读更多
该市场通过提供“互联网没有的数据”而脱颖而出,强调专家主导的收集和策划。这包括双人自然对话、入站支持电话、模拟语音、长篇播客对话,以及各种印度语言和英语的对话语音。在视频方面,Perit 提供第一人称家庭任务视频、许可的技能活动视频,以及 75 个内容类别的广泛库。代码和代理 RL 数据集包含长时间跨度的代理任务、来自物流和电子商务的生产代码摘录、在线游戏平台后端,以及完整的社交媒体组织数据。
Perit 还提供图像和文档数据集,包括现场照片、用于 OCR 的扫描个人和财务文档,以及自定义图像注释。可用的专业数据类型包括 CAD 和 3D 项目、消费者推介文档、企业工作流数据(Slack、电子邮件、工单)以及去标识化的临床队列。该平台支持多种模态,包括语音和音频、视频、图像、文本,以及用于机器人团队的具身数据,使用多种硬件捕获,如运动相机、LiDAR、安卓手机和自定义设备。
Perit 的运营模式建立在执行任务的人是记录、转录和评分数据的理想个体这一原则上。由 Zyno AI Inc. 运营,并得到 Y Combinator 的支持,Perit 保持独立,确保客户数据不会与竞争对手的保留数据混合。该公司根据范围、地点稀缺性、注释深度、周转时间和独占性提供透明的定价,报价在 48 小时内送达。它还提供试点批次以测试规格,并遵循严格的质量保证协议,每个批次都附带详细的质量报告。
- 类别机器学习与数据科学
- 定价模式联系销售
- 部署云端
- 平台网页版
Perit的核心功能
29 个许可数据集,涵盖 10 个类别
122 种语言的语音数据
自我中心和一般视频数据集
生产代码库和代理 RL 环境
临床和企业数据集合
自定义数据收集和注释服务
透明定价,48 小时内报价
试点批次选项用于规格测试
每个数据批次附带详细质量报告
默认情况下为永久性、非独占性数据许可
贡献者同意管理和数据安全
获得 SOC 2、ISO 27001、ISO 27701、TPN 金牌认证
符合 GDPR、CCPA 和 HIPAA 的数据处理
数据存储固定在特定地理区域
用于机器人团队的物理智能数据
如何使用 Perit?
提交简要说明:提供一个失败示例(剪辑、照片、段落、任务描述)以启动报价。
接收报价:在 48 小时内获得书面规格和报价,详细说明数量、地点、注释深度和贡献者费率。
审核样本:在五个工作日内收到您所需格式的样本集。
试点批次:在两周内获得试点批次及其质量报告,以验证规格。
数量交付:一旦试点批次通过质量检查,开始每周数据交付节奏。
许可数据:根据商定条款,利用许可数据集进行内部模型开发和评估。
Perit的使用案例
- AI 模型训练
- 语音识别开发
- 计算机视觉研究
- 机器人训练
- 代码库分析
- 文档理解
- 临床 AI 开发
- 企业工作流自动化
- 自定义数据注释
- 代理 RL 环境创建