描述
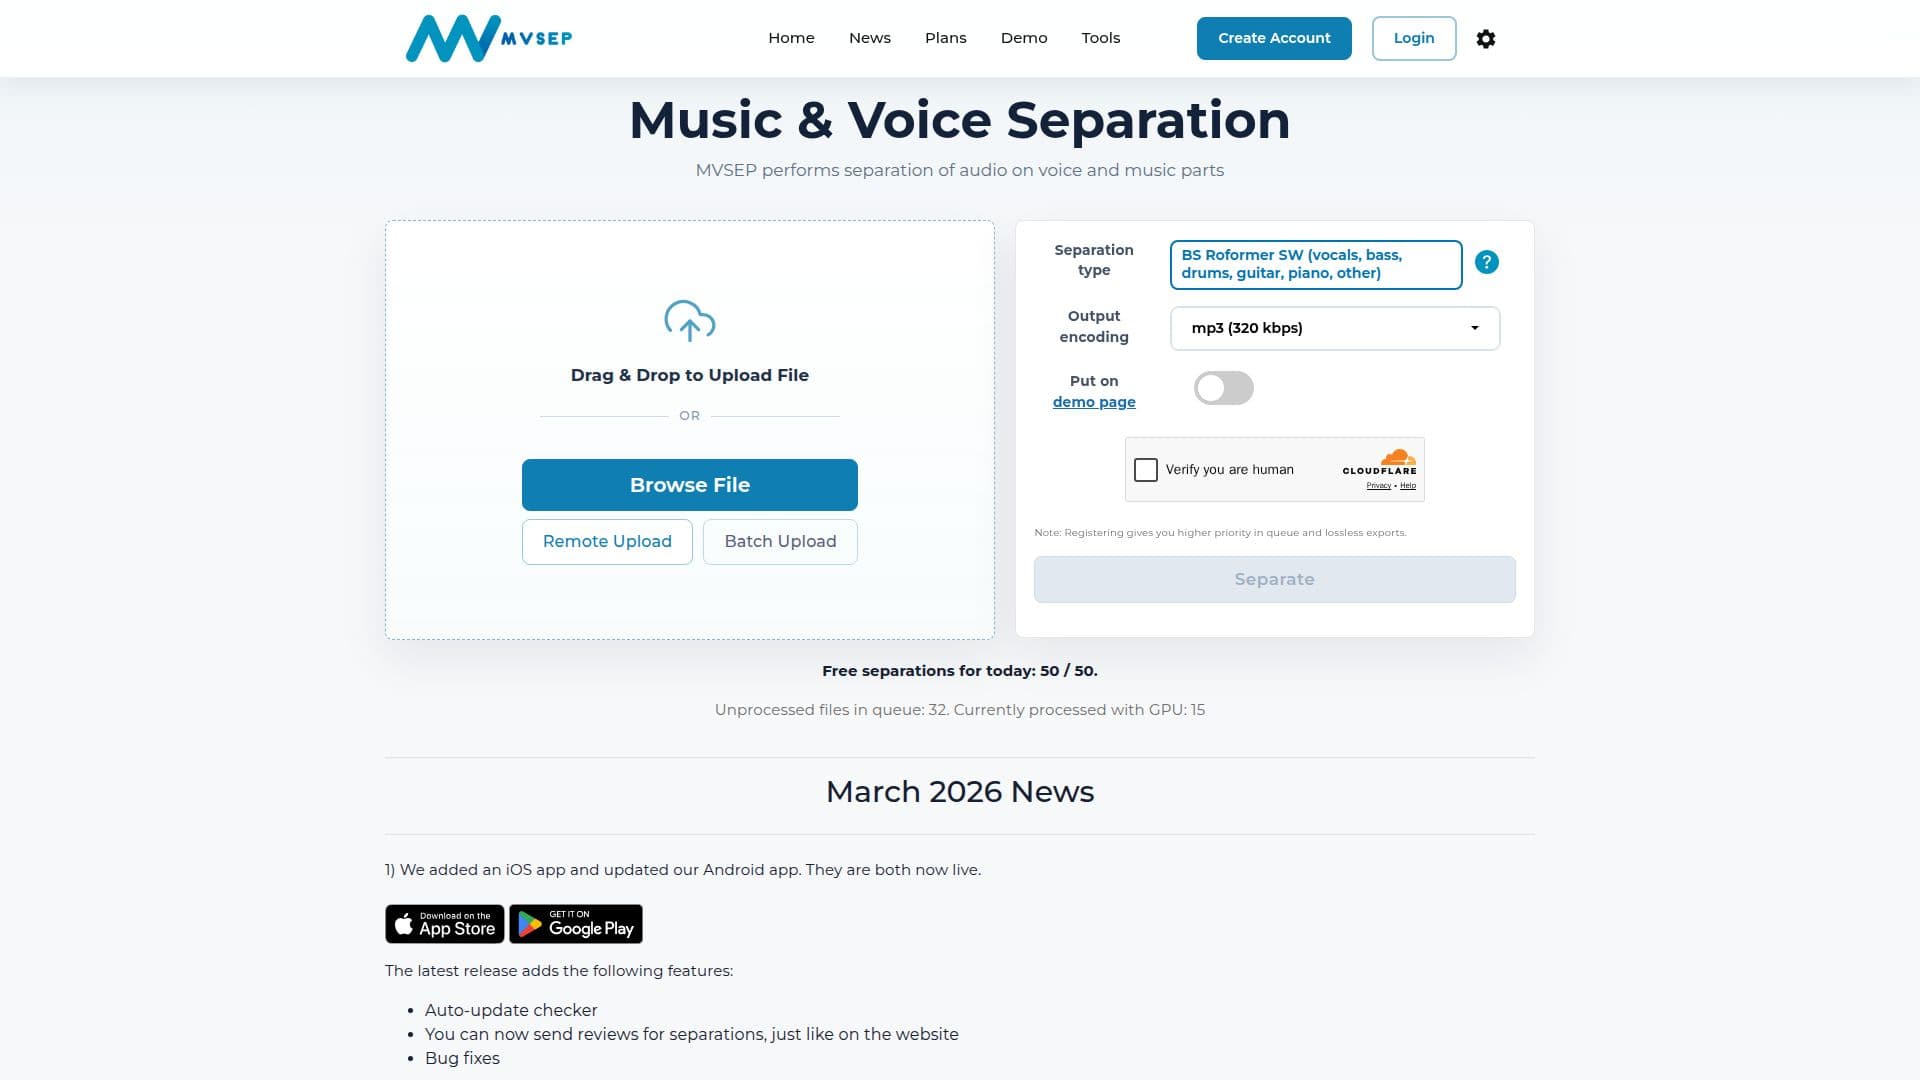
MVSEP 是一款创新工具,旨在促进音频轨道分离为不同的人声和乐器组件。利用先进的人工智能算法,MVSEP 使用户能够从任何音频文件中隔离人声与乐器。这一功能对需要精确控制音频元素以进行混音、母带处理或教育目的的音乐家、音频工程师和制作人尤为有利。
该工具可在线访问,并提供用户友好的界面,简化了音频分离的过程。用户可以上传他们的音频文件,并在几分钟内接收分离的音轨。MVSEP 的 AI 技术确保高质量的分离,保持人声和乐器音轨的完整性。
除了音频分离,MVSEP 还具备从音频中提取文本的功能,允许用户将口语内容转换为文本。此功能对于转录访谈、播客或任何需要文本记录的音频内容非常有用。
MVSEP 是免费的,使其成为个人和专业人士的可访问选项。该平台还提供全面的 API 文档,使开发人员能够将 MVSEP 的功能集成到他们自己的应用程序或工作流程中。
总体而言,MVSEP 在音频处理行业中脱颖而出,提供可靠且高效的音频分离和文本提取解决方案。其免费可用性和易用性使其成为任何处理音频内容的人的宝贵资源。
MVSEP的核心功能
音频分离为人声和乐器部分
从音频中提取文本
免费使用
AI 驱动算法
高质量分离
用户友好的界面
完整的 API 文档
在线可访问性
如何使用 MVSEP?
上传:选择并上传您的音频文件
处理:允许 AI 分离音频
下载:获取分离的音轨
集成:使用 API 进行自定义应用
MVSEP的使用案例
- 音乐制作
- 播客转录
- 音频工程
- 教育目的
- 内容创作