描述
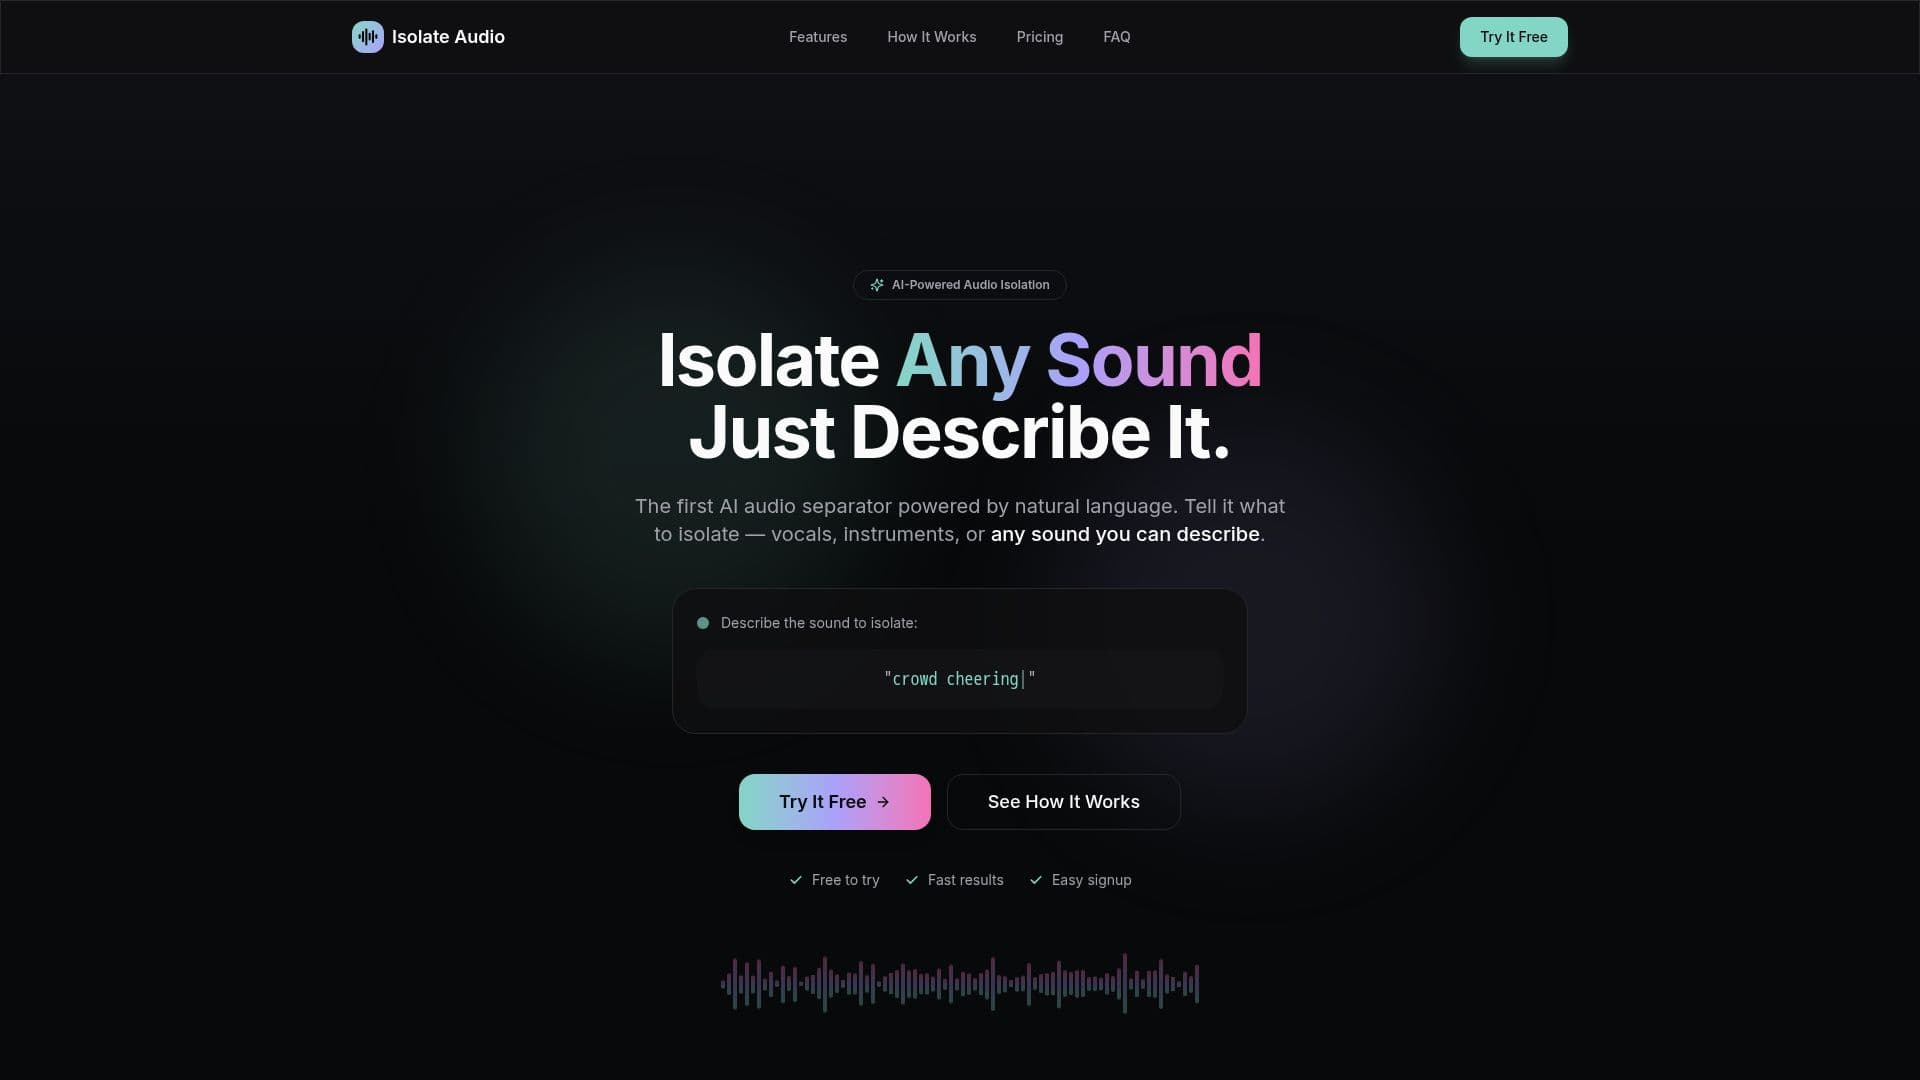
音频隔离是一个创新的基于AI的工具,旨在彻底改变用户与音频文件的互动方式。与传统的音频分离工具不同,后者限制用户使用预设类别,音频隔离允许用户使用自然语言描述他们希望隔离的任何声音。这种灵活性使得音乐家、播客制作人、视频编辑和其他创作者能够轻松提取特定的音频元素。
该过程简单高效。用户可以上传各种格式的音频或视频文件,包括MP3、WAV、FLAC、M4A、OGG,甚至视频格式如MP4。上传后,用户可以用简单的英语描述他们想要隔离的声音,例如“钢琴旋律”或“人群噪音”。然后,AI处理请求并提供两个高质量的音频文件:一个是隔离的声音,另一个是剩余的音频。
音频隔离提供了多种功能以增强用户体验。它包括针对不同需求的质量预设,如录音室质量、日常使用或快速处理。精确模式允许在复杂音频中提高准确性,处理重叠声音。该工具是云驱动的,确保快速处理,无需下载或安装。
定价透明,免费层提供每月五次音频分离,专业层则提供无限分离和额外功能。企业层适用于团队和高容量用户,提供API访问和自定义集成。
音频隔离适用于广泛的用户,从希望为混音隔离乐器的音乐家,到需要清理录音的播客制作人。视频编辑可以将对话与背景音乐分开,而研究人员可以分析特定的音频元素。该工具的多功能性和易用性使其成为任何处理音频的人的宝贵资产。
音频隔离的核心功能
基于AI的音频分离
自然语言处理
支持多种音频和视频格式
针对不同需求的质量预设
复杂音频的精确模式
云驱动的快速处理
两个输出文件:隔离声音和剩余音频
简单透明的定价
如何使用 音频隔离?
上传:拖放音频或视频文件
描述:输入您想要隔离的声音
处理:AI处理请求
下载:接收隔离和剩余音频文件
音频隔离的使用案例
- 音乐家
- 播客制作人
- 视频编辑
- DJ和制作人
- 研究人员