描述
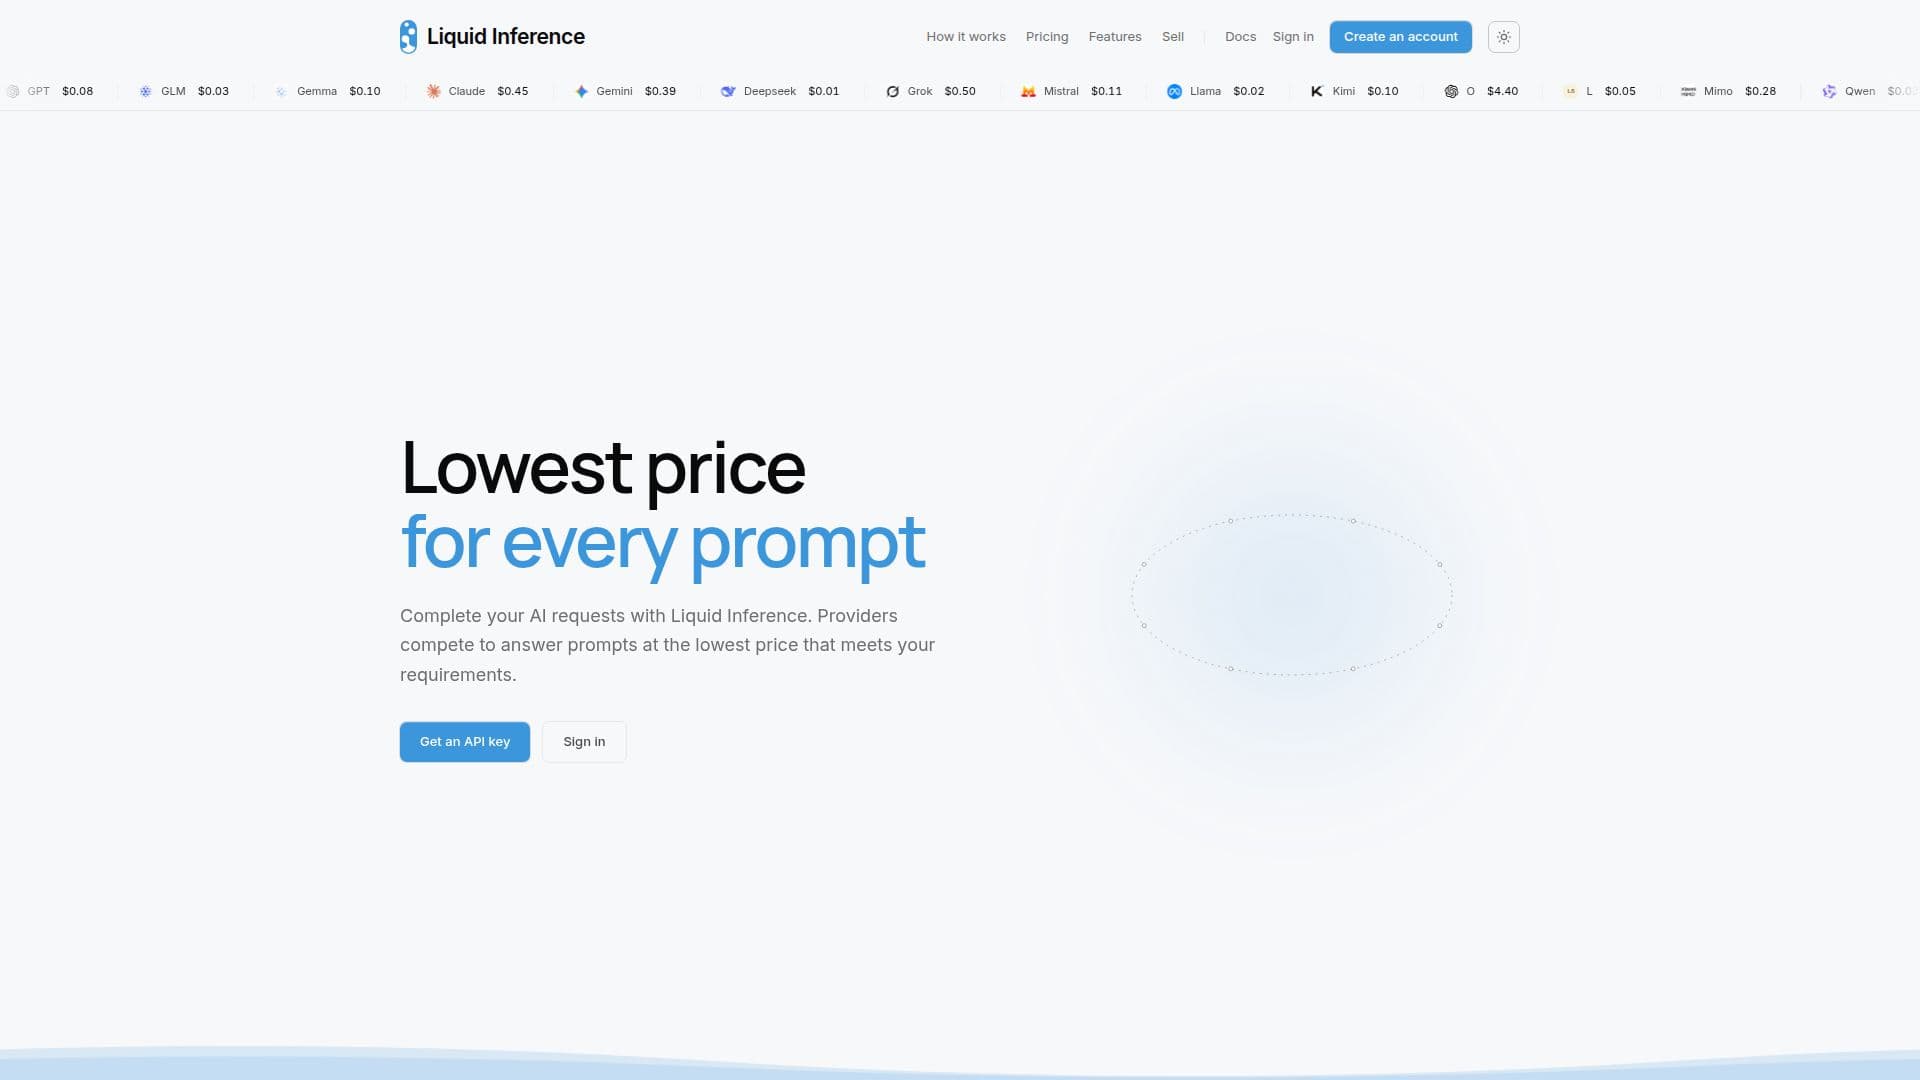
Liquid Inference 是一个旨在通过允许提供者对每个提示的价格进行竞争来优化 AI 请求成本的平台。用户可以设置有关模型、区域、速度和最低质量的具体规则,平台确保满足这些标准的最低报价提供者响应请求。这种方法使用户在请求开始之前就能知道请求的最高成本,并且只为生成的令牌付费。
阅读更多
该平台具有即时拍卖系统,提供者为每个模型设置每个令牌的价格,并可以根据供需情况进行调整。这种动态定价模型确保用户始终获得最具成本效益的解决方案。Liquid Inference 定期使用标准基准测试提供者并发布结果,以确保透明度和信任。
Liquid Inference 支持主要模型,如 OpenAI 和 Anthropic API,允许用户与现有的 AI 编码工具无缝集成。提供者可以注册其部署,设置自己的价格,并通过根据容量调整价格来控制其负载。该平台向客户收取费用,而不是提供者,使其成为希望在已运行模型上销售推理的提供者的一个有吸引力的选择。
通过逐项计费和公共价格历史等功能,用户可以下载每个模型的实时和过去价格,使他们能够在价格低时发送工作。Liquid Inference 非常适合希望优化 AI 成本而不影响质量的企业和开发者。
- 类别机器学习平台
- 定价模式动态
- 部署云端
- 平台网页版
Liquid Inference的核心功能
AI 请求的竞争性定价
动态拍卖系统
提供者基准测试
与 OpenAI 和 Anthropic API 的集成
逐项计费
公共价格历史
对主要 AI 模型的支持
提供者控制定价
如何使用 Liquid Inference?
创建账户:在平台上注册
注册部署:提交您想要服务的模型
运营商审核:让您的部署上架
开始报价:连接您的代理并开始提供价格
Liquid Inference的使用案例
- 成本优化
- 动态定价
- 质量保证
- 无缝集成
- 提供者管理