描述
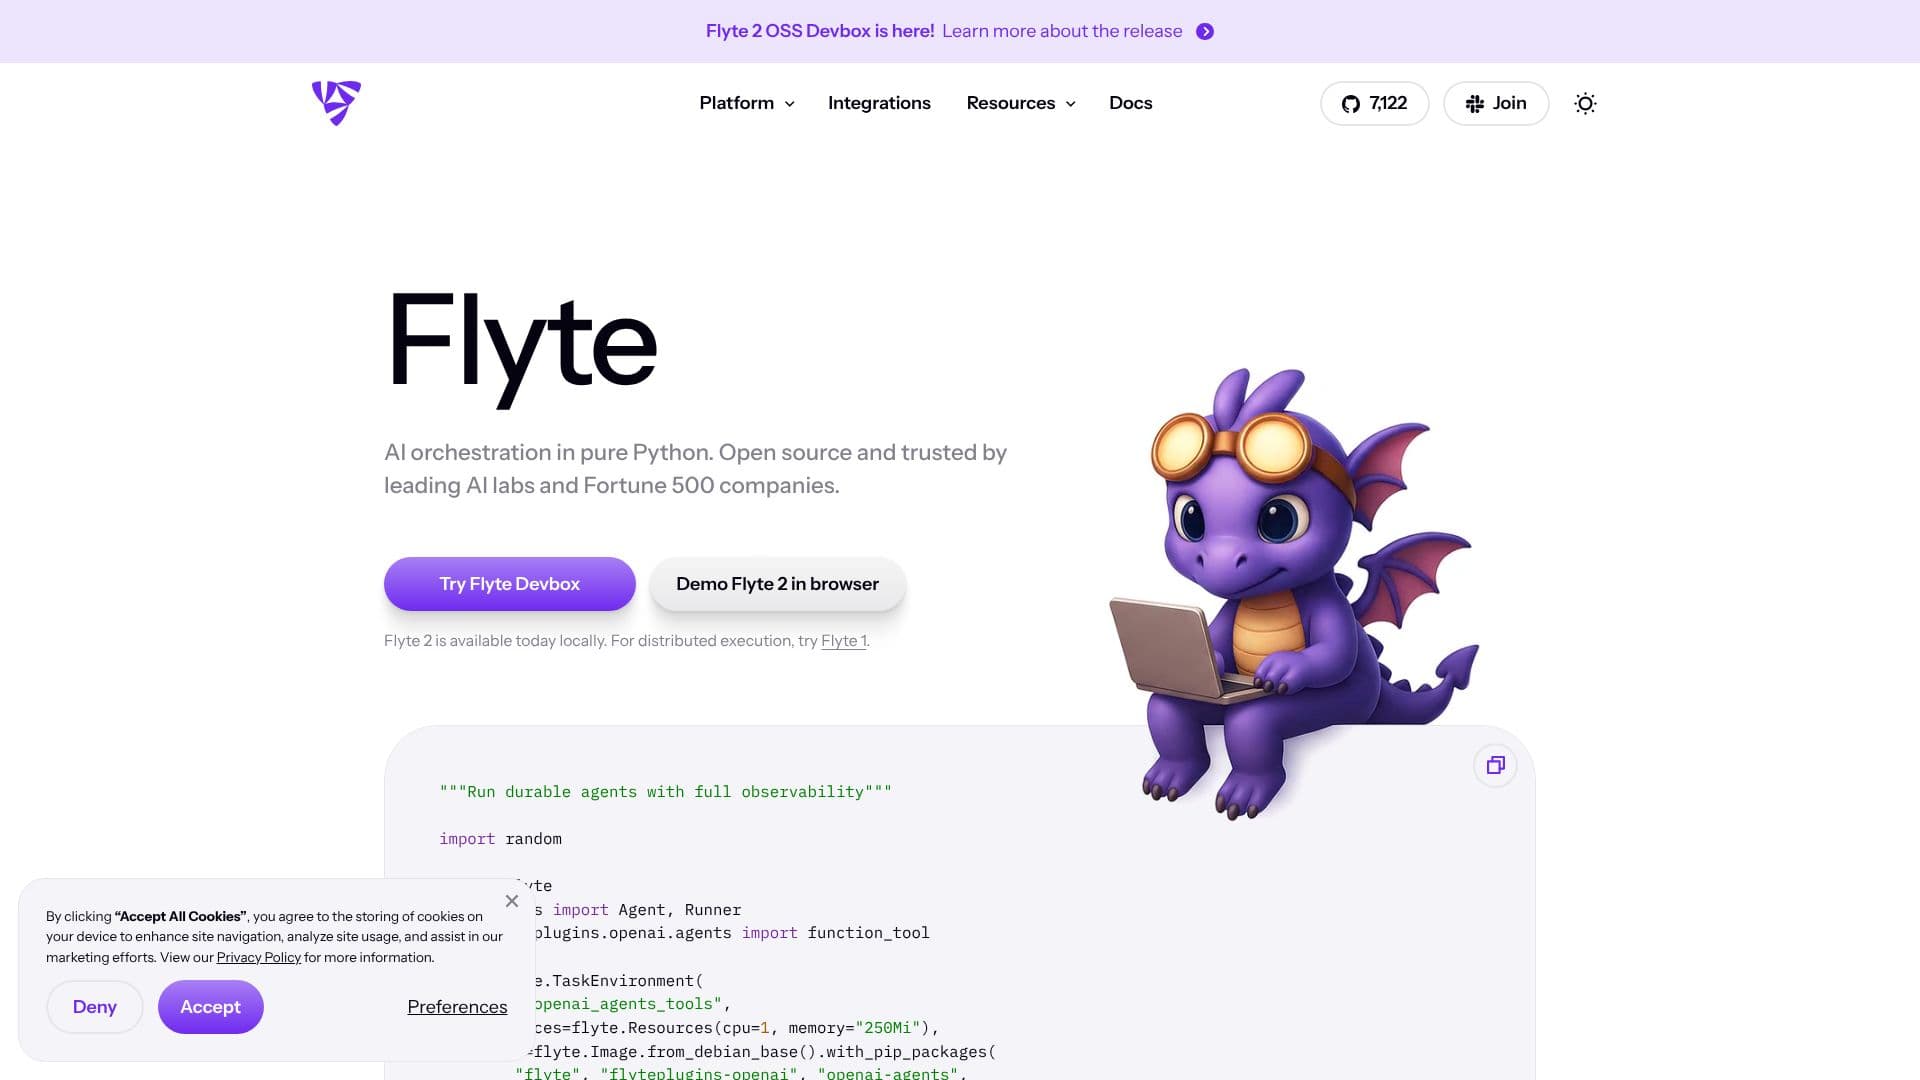
Flyte 提供了一个全面的开源解决方案,用于编排 AI 和机器学习工作流,旨在简化复杂、长期运行和自主式应用程序的开发和部署。该平台使开发人员能够直接使用纯 Python 编写工作流,无需专门的领域特定语言 (DSL),从而提供熟悉的开发体验。
阅读更多
Flyte 设计的核心在于其对持久性和弹性的关注。工作流默认构建为容错的,具有自动重试和从中断处恢复的能力,使故障的影响降至最低。这种自我修复能力可确保持续运行并减少手动干预。
Flyte 的感知基础设施编排允许工作流动态地配置和扩展资源,以适应工作负载需求。这意味着开发人员可以专注于其 AI 模型和管道的逻辑,而 Flyte 则负责处理底层基础设施的复杂性。该平台支持动态工作流执行,能够根据实时逻辑和条件进行即时决策。
对于开发人员而言,Flyte 提供了一个强大的本地开发环境。可以使用与生产环境中 Kubernetes 上运行的相同 Python SDK 在本地测试和调试任务,从而简化了从开发到部署的迭代周期。这种方法确保了在将 AI 项目从实验阶段迁移到生产阶段时,通常会遇到的摩擦得到减少,并提高了整体一致性。
除了开源产品,Union.ai 还提供了一个构建在 Flyte 之上的企业级平台。这个商业解决方案通过大规模处理、超低延迟的实时推理、增强的可观测性以及专门的支持,扩展了 Flyte 的功能,从而加速了组织内 AI 从实验到生产的进程。
Flyte 与各种流行的工具和框架集成,包括 Apache Spark、BigQuery、PyTorch Elastic、Ray、Snowflake 和 Weights & Biases,可以无缝集成到现有的 AI/ML 技术栈中。该平台拥有一个强大的社区,提供资源、活动和论坛供用户交流和分享知识。
- 类别MLOps 与模型部署
- 定价模式开源
- 部署云端、本地部署
- 平台网页版
Flyte AI Orchestration的核心功能
编排复杂的 AI/ML 工作流
使用纯 Python 编写工作流
动态和自主式工作流执行
感知基础设施的编排和自动伸缩
持久且自我修复的工作流
本地开发和调试
内置缓存和版本控制以确保可重复性
支持可重用、预热的容器
对资源使用和数据血缘的可观测性
与数据和 ML 工具的广泛集成
如何使用 Flyte AI Orchestration?
编写工作流:使用纯 Python 编写您的 AI/ML 管道。
本地开发:在本地环境中测试和调试任务。
部署到规模:将工作流推广到云或本地基础设施。
运行时适应:构建具有状态执行和故障恢复能力的自主式工作流。
监控和优化:利用可观测性功能进行洞察和性能调优。
Flyte AI Orchestration的使用案例
- AI/ML 管道编排
- 自主式工作流开发
- 分布式训练
- 数据处理管道
- 模型部署和提供服务
- 本地 AI 开发
- 批量推理