描述
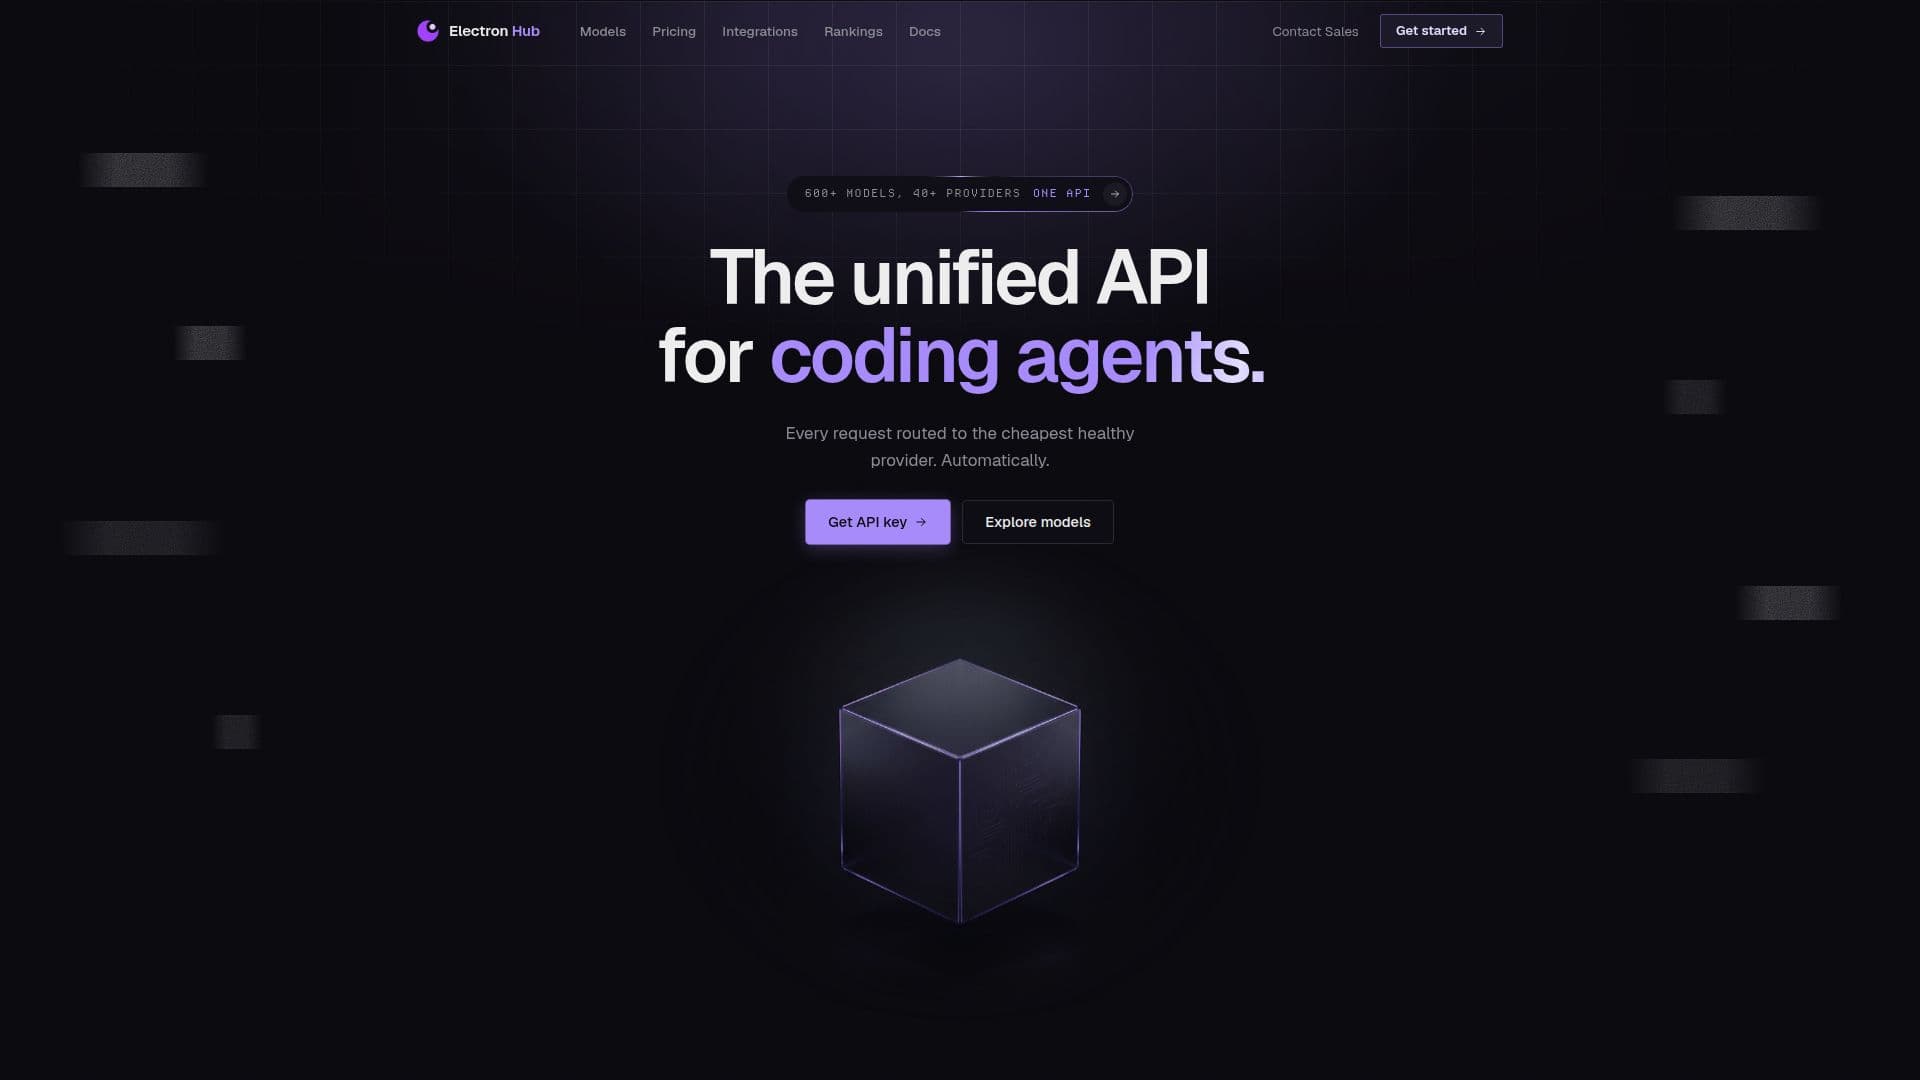
Electron Hub 提供了一个全面的 API 网关,旨在简化开发者和企业的大型语言模型(LLM)推理。它通过一个 OpenAI 兼容的单一端点整合了来自 40 多个不同提供商的 600 多个模型的访问。这种统一的方法消除了提供商锁定,简化了集成过程,使用户只需在代码中更改一个字符串即可切换模型。
阅读更多
该平台的核心功能围绕其智能路由器展开,自动根据实时的价格、延迟和健康评分将每个请求路由到最便宜的健康提供商。这确保了最佳的性能和成本效率,而无需用户管理复杂的故障转移逻辑或 GPU 基础设施。Electron Hub 管理整个推理堆栈,包括 API、批处理和缓存的运行时,以及底层的 GPU 车队,使用户免于运营开销。
除了基本路由外,Electron Hub 还包含先进的生产级功能。它包括内联安全防护措施,如 PII 消除、注入扫描和在请求到达模型之前处理的策略过滤器,确保数据安全。该系统还具有高可用性,每个模型都有多个上游和自动重试机制,将潜在的停机转变为小故障。用户可以受益于详细的每个请求的成本跟踪,显示按关键、模型和日期的令牌、延迟和支出。
Electron Hub 支持多达 100 个范围 API 密钥,每个密钥都有单独的月度支出限制,防止意外收费。它确保快速访问新模型,通常在发布后的几分钟内,无需任何迁移工作。该平台与任何支持 OpenAI 的代理或客户端兼容,只需指向 `api.electronhub.ai` 并从目录中选择模型即可实现无缝集成。中央控制台提供实时使用情况、支出、密钥管理和提供商健康监控,并具备完整的导出功能。
安全和隐私至关重要,推理可以选择在硬件支持的受信执行环境(TEE)中运行。这确保了机密信息保留在加密内存中,并且每次运行都会发送签名的执行证明。该服务在全球范围内分布,GPU 容量遍布美洲、欧洲和亚洲,自动将请求路由到最近的健康区域以实现低延迟。该系统旨在实现高吞吐量,每天在提供商之间持续重新平衡数百万个请求。用户可以快速开始,享受每周免费的积分,无需信用卡。
- 类别MLOps 与模型部署
- 定价模式免费增值
- 部署云端
- 平台网页版
Electron Hub的核心功能
统一的 API 网关,支持 600 多个 LLM 模型
支持 40 多个 LLM 提供商
单一的 OpenAI 兼容端点
自动提供商故障转移和负载均衡
基于实时成本、延迟和健康的路由
所有提供商的统一计费
管理的 GPU 池和扩展
内联 PII 消除和注入扫描
内容审核的策略过滤器
停机的自动重试
按关键、模型和日期的详细成本跟踪
具有月度支出限制的范围 API 密钥
新模型的快速集成
与支持 OpenAI 的代理/客户端兼容
实时使用和支出控制台
用于安全推理的硬件支持 TEE
全球 GPU 容量以实现低延迟
如何使用 Electron Hub?
开始使用免费积分:访问每周积分,无需信用卡即可开始使用该平台。
配置 API 端点:将您的 OpenAI 兼容客户端或代理指向 `api.electronhub.ai` 作为基础 URL。
选择模型:通过更改配置中的一个字符串,从 40 多个提供商的 600 多个模型中进行选择。
与工具集成:通过编辑 OpenCode 配置,将 Electron Hub 嵌入到 Cursor、Cline、Zed 或 Aider 等工具中。
监控使用情况:使用中央控制台实时跟踪使用情况、支出、管理密钥并查看提供商健康状况。
Electron Hub的使用案例
- LLM 推理路由
- 统一 API 访问
- 成本优化
- 增强安全性
- 高可用性
- 开发者生产力
- 代理运行时
- 模型实验
- 使用监控
- API 密钥管理