Описание
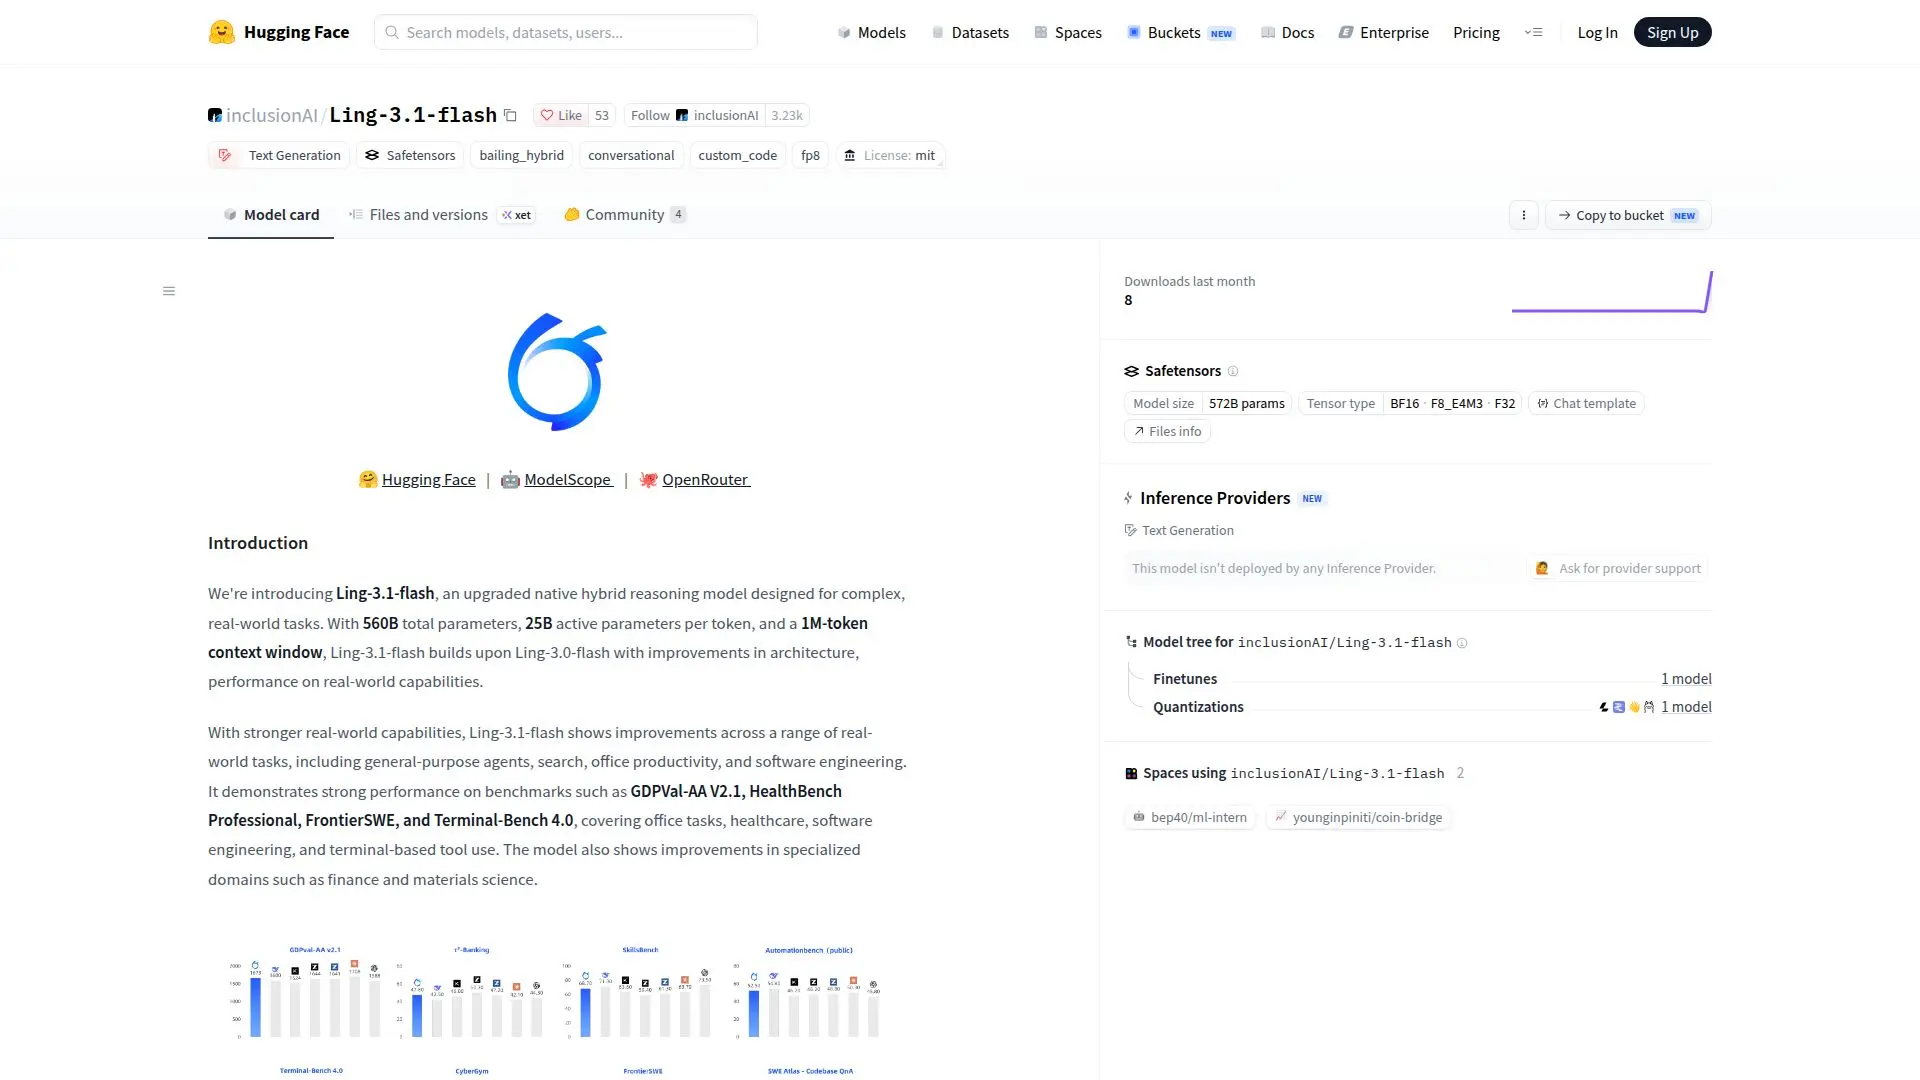
Ling-3.1-flash — это обновленная родная гибридная модель рассуждений, представленная компанией inclusionAI на платформе Hugging Face. Разработанная для решения сложных задач из реальной жизни, эта модель имеет в своем составе 560 миллиардов параметров, из которых 25 миллиардов активных параметров на токен и контекстное окно на 1 миллион токенов. Эти улучшения основаны на ее предшественнике, Ling-3.0-flash, предлагая улучшенную архитектуру и производительность.
Читать далее
Модель превосходно справляется с различными реальными приложениями, такими как агенты общего назначения, поиск, офисная продуктивность и программная инженерия. Она продемонстрировала высокую производительность на таких бенчмарках, как GDPVal-AA V2.1, HealthBench Professional, FrontierSWE и Terminal-Bench 4.0. Эти бенчмарки охватывают широкий спектр задач, включая офисные задачи, здравоохранение, программную инженерию и использование инструментов на терминале. Кроме того, Ling-3.1-flash демонстрирует заметные улучшения в специализированных областях, таких как финансы и материаловедение.
Архитектура Ling-3.1-flash основана на гибридной линейной модели смеси экспертов (MoE), включающей 63 KDA и 9 слоев Gated MLA трансформеров, 4 плотных слоя и 512 маршрутизируемых экспертов. Модель также включает 64 головы внимания и скрытый размер 4096, с размером словаря 157184.
Ling-3.1-flash была оценена по нескольким авторитетным бенчмаркам, демонстрируя высокую производительность в задачах кодирования и агентных задачах. Она поддерживает такие фреймворки, как Claude Code, Kilo Code, Qwen Code, Hermes Agent и OpenClaw. Модель также вводит LingCode, систему, построенную на открытом коде кодирующего агента Pi, что улучшает производительность в сложных задачах кодирования с длительным горизонтом.
Для пользователей, желающих начать работу, рекомендуемое изображение SGLang включает поддержку Ling-3.1-flash, MTP спекулятивное декодирование и оптимизации декодирования Hopper. Модель доступна для вывода на различных конфигурациях серверов, и предоставлены проверенные рецепты для различных аппаратных настроек.
- КатегорияИИ-модели и LLM
- Модель ценообразованияОткрытый код
- РазвёртываниеОблако
- ПлатформыВеб
Главное о Ling-3.1-flash
560B общих параметров
1M-токен контекстное окно
Гибридная линейная архитектура MoE
63 KDA + 9 Gated MLA слоев
512 маршрутизируемых экспертов
64 головы внимания
Поддержка нескольких фреймворков
Сильная производительность на бенчмарках
Начало работы с Ling-3.1-flash
Доступ к странице модели: посетите Hugging Face
Аутентификация: войдите в свою учетную запись
Настройка: настройте сервер или клиентскую среду
Отправка запросов: используйте проверенные рецепты для вывода
Варианты использования Ling-3.1-flash
- Агенты общего назначения
- Офисная продуктивность
- Программная инженерия
- Приложения в здравоохранении
- Финансовый анализ