

Описание
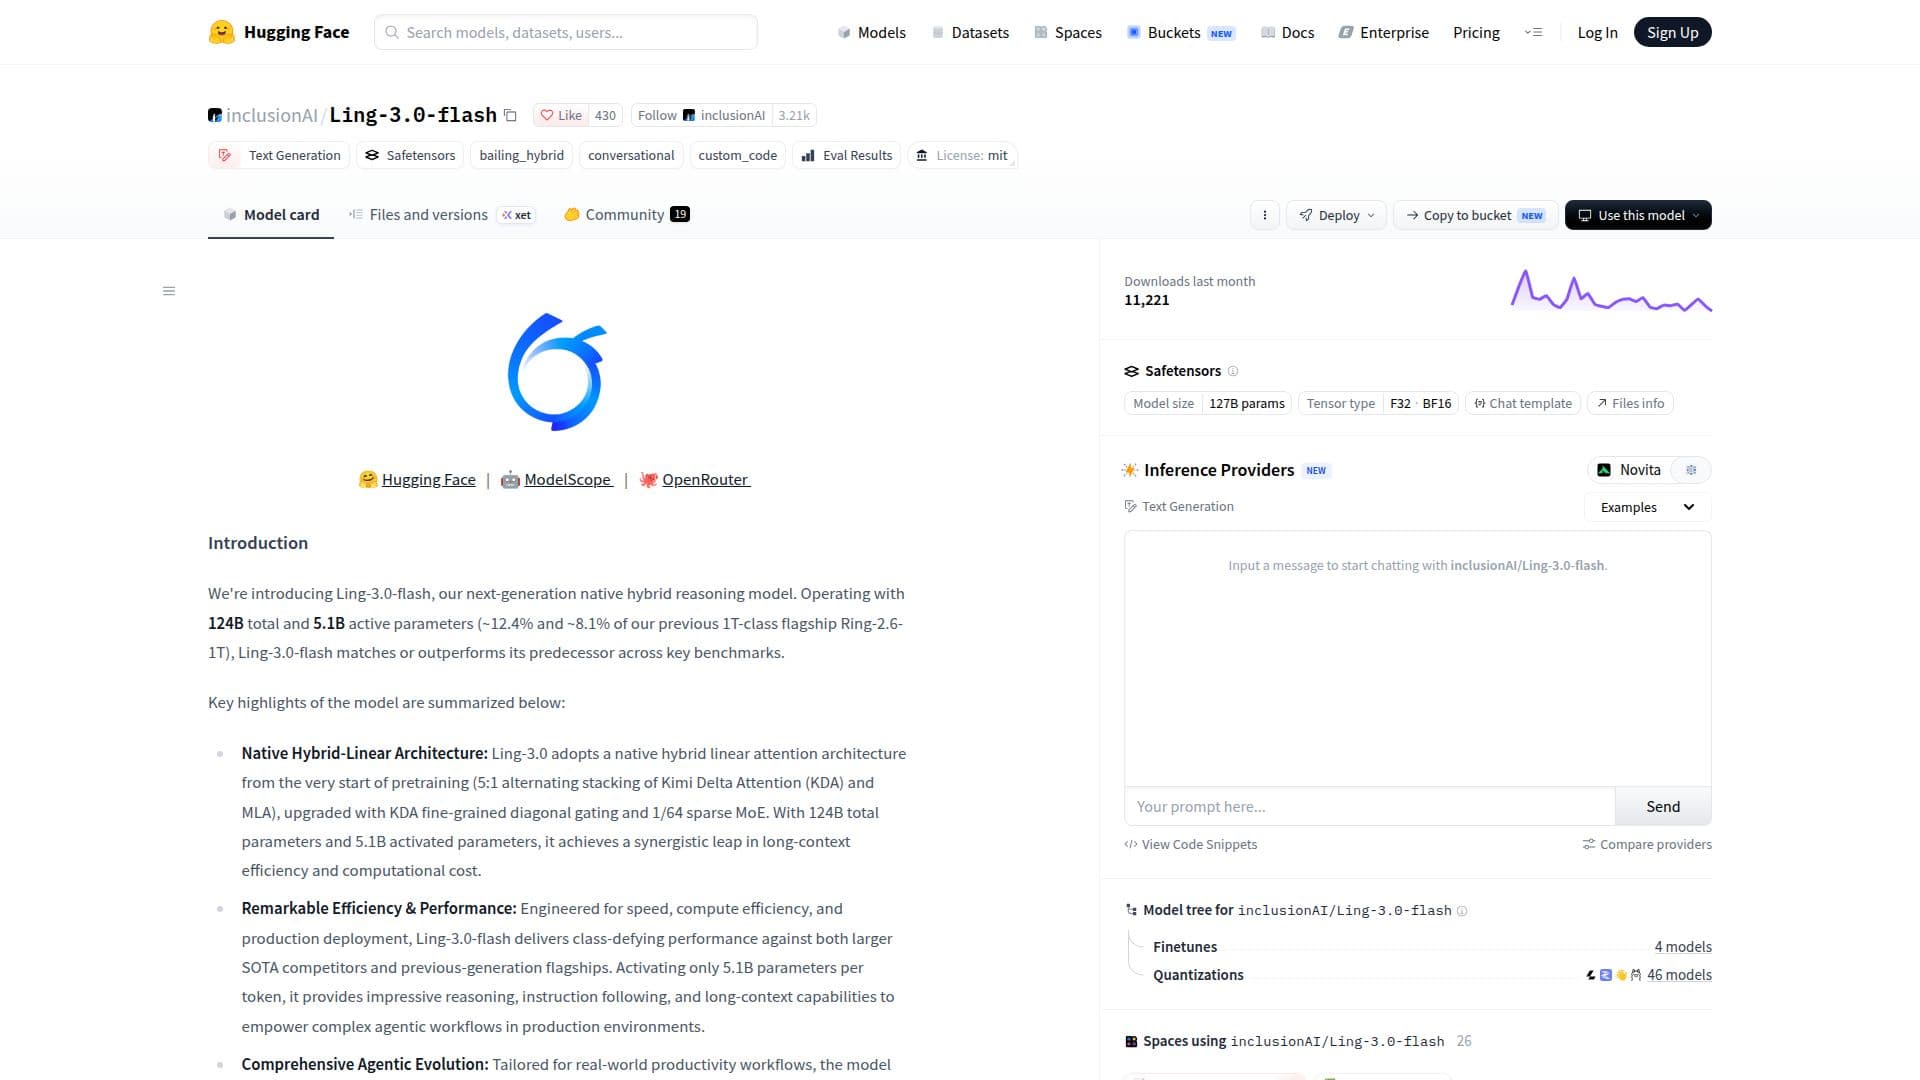
Ling-3.0-flash — это передовая модель гибридного рассуждения, разработанная компанией inclusionAI и размещенная на Hugging Face. Она работает с общим количеством 124 миллиардов параметров, из которых 5,1 миллиарда активируются на токен, обеспечивая выдающуюся эффективность и производительность. Модель использует родную гибридную линейную архитектуру внимания, включающую Kimi Delta Attention (KDA) и MLA, обновленную с помощью тонкой диагональной блокировки и разреженного MoE. Эта архитектура позволяет Ling-3.0-flash достичь синергетического скачка в эффективности длинного контекста и вычислительных затрат.
Читать далее
Созданная для скорости и вычислительной эффективности, Ling-3.0-flash демонстрирует производительность, превосходящую более крупные современные конкуренты и флагманы предыдущего поколения. Она поддерживает сложные агентные рабочие процессы в производственных средах, активируя только 5,1 миллиарда параметров на токен. Модель включает более 10 000 интерактивных учебных сред для достижения замкнутого цикла выполнения от начала до конца в задачах программирования, общего и глубокого исследования.
Ling-3.0-flash интегрирует архитектуру кэширования SGLang HiCache + Mooncake, включающую физические двойные пулы и общий кэш L3 кластера. Эта настройка устраняет избыточные перерасчеты во время долгосрочных взаимодействий, сокращая время до первого токена (TTFT) на 60% до более чем 80% в сценариях с длинным вводом. Модель демонстрирует высокие результаты по нескольким авторитетным бенчмаркам, включая SWE-Bench Pro, SWE-Bench Multilingual, Tau3-banking-AA, MCP-Atlas и SkillsBench.
Модель адаптирована для рабочих процессов реальной продуктивности, обеспечивая высокую производительность в области общего знания, математического рассуждения, выполнения инструкций и понимания длинного контекста. Ling-3.0-flash предназначена для развертывания в производстве, предлагая впечатляющие возможности рассуждения и эффективность длинного контекста, что делает её подходящей для сложных агентных рабочих процессов.
- КатегорияИИ-модели и LLM
- Модель ценообразованияFreemium
- РазвёртываниеОблако
- ПлатформыВеб
Главное о Ling-3.0-flash
Родная гибридно-линейная архитектура
Выдающаяся эффективность и производительность
Комплексная эволюция агентного взаимодействия
Кэширование SGLang HiCache + Mooncake
Замкнутое выполнение от начала до конца
Эффективность длинного контекста
Выполнение инструкций
Математическое рассуждение
Начало работы с Ling-3.0-flash
Доступ к странице модели: посетите Hugging Face
Аутентификация: войдите в свою учетную запись
Настройка: установите параметры и предпочтения
Отправка запросов: введите ваши запросы
Тонкая настройка: отрегулируйте настройки модели
Варианты использования Ling-3.0-flash
- Задачи программирования
- Исследовательские агенты
- Выполнение инструкций
- Понимание длинного контекста
- Математическое рассуждение







