Описание
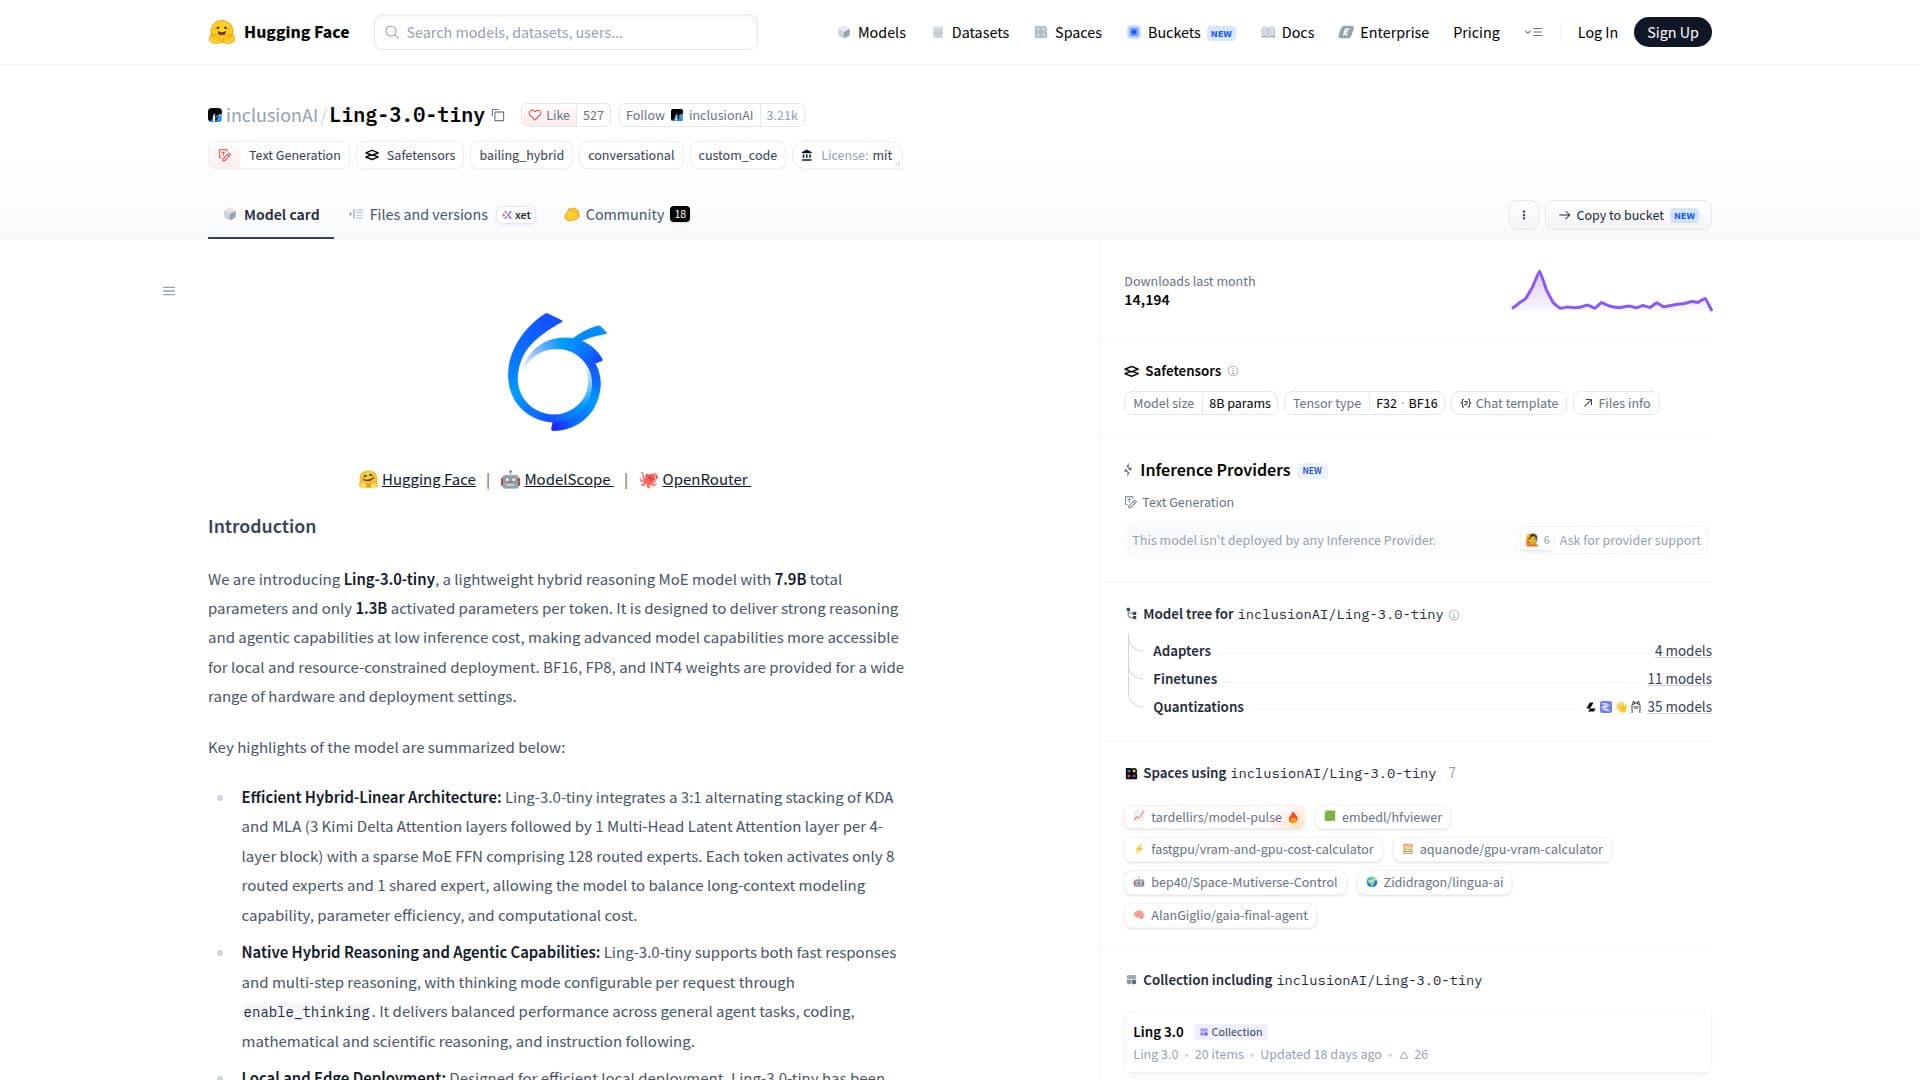
Ling-3.0-tiny — это легковесная гибридная модель рассуждений, разработанная компанией inclusionAI и размещенная на Hugging Face. Она имеет в общей сложности 7,9 миллиарда параметров, из которых активируется только 1,3 миллиарда на токен, что делает её эффективной для локального развертывания и развертывания в условиях ограниченных ресурсов. Модель интегрирует чередование слоев Kimi Delta Attention (KDA) и Multi-Head Latent Attention (MLA) в соотношении 3:1, а также разреженную сеть прямой передачи Mixture of Experts (MoE) с 128 маршрутизированными экспертами. Эта архитектура позволяет модели сбалансировать возможности моделирования длинного контекста, эффективность параметров и вычислительные затраты.
Читать далее
Ling-3.0-tiny разработана для обеспечения сильных возможностей рассуждений и агентных функций при низкой стоимости вывода. Она поддерживает как быстрые ответы, так и многошаговые рассуждения с настраиваемым режимом мышления. Модель протестирована на различных аппаратных средствах, включая NVIDIA DGX Spark и Apple Silicon MacBook, что позволяет выполнять сложные рассуждения и агентные рабочие нагрузки без необходимости в GPU класса дата-центра. С использованием FP8 она достигает скорости около 100-105 токенов в секунду на DGX Spark и 86-90 токенов в секунду на MacBook M4 Pro, с пиковым использованием памяти около 8,34 ГиБ при длине контекста 8K.
Эффективность модели подчеркивается её результатами в Индексе Искусственного Анализа Интеллекта v4.1.1, где она набрала 25 баллов, и в Индексе Искусственного Анализа Агентности, где она набрала 16 баллов. Она достигает скорости вывода более 160 токенов в секунду, с примерно 18 секундами задержки от начала до конца для ответа на 500 токенов. Ling-3.0-tiny подходит для широкого спектра задач, включая агентные задачи, кодирование, понимание длинного контекста, надежность знаний, математические и научные рассуждения, а также выполнение инструкций.
- КатегорияИИ-модели и LLM
- Модель ценообразованияFreemium
- РазвёртываниеРаботает локально
- ПлатформыВеб
Главное о Ling-3.0-tiny
7,9 миллиарда параметров
1,3 миллиарда активированных параметров на токен
Гибридные возможности рассуждений
Эффективное локальное развертывание
Архитектура KDA-MLA 3:1
Разреженная MoE FFN с 128 экспертами
Поддержка быстрых ответов и многошаговых рассуждений
Проверена на NVIDIA DGX Spark и Apple Silicon
Начало работы с Ling-3.0-tiny
Доступ к странице модели: посетите Hugging Face
Аутентификация: войдите в свою учетную запись
Настройка: установите параметры модели
Отправка запросов: используйте модель для вывода
Тонкая настройка: настройте параметры для конкретных задач
Варианты использования Ling-3.0-tiny
- Агентные задачи
- Кодирование
- Научные рассуждения
- Следование инструкциям
- Локальное развертывание