Descrição
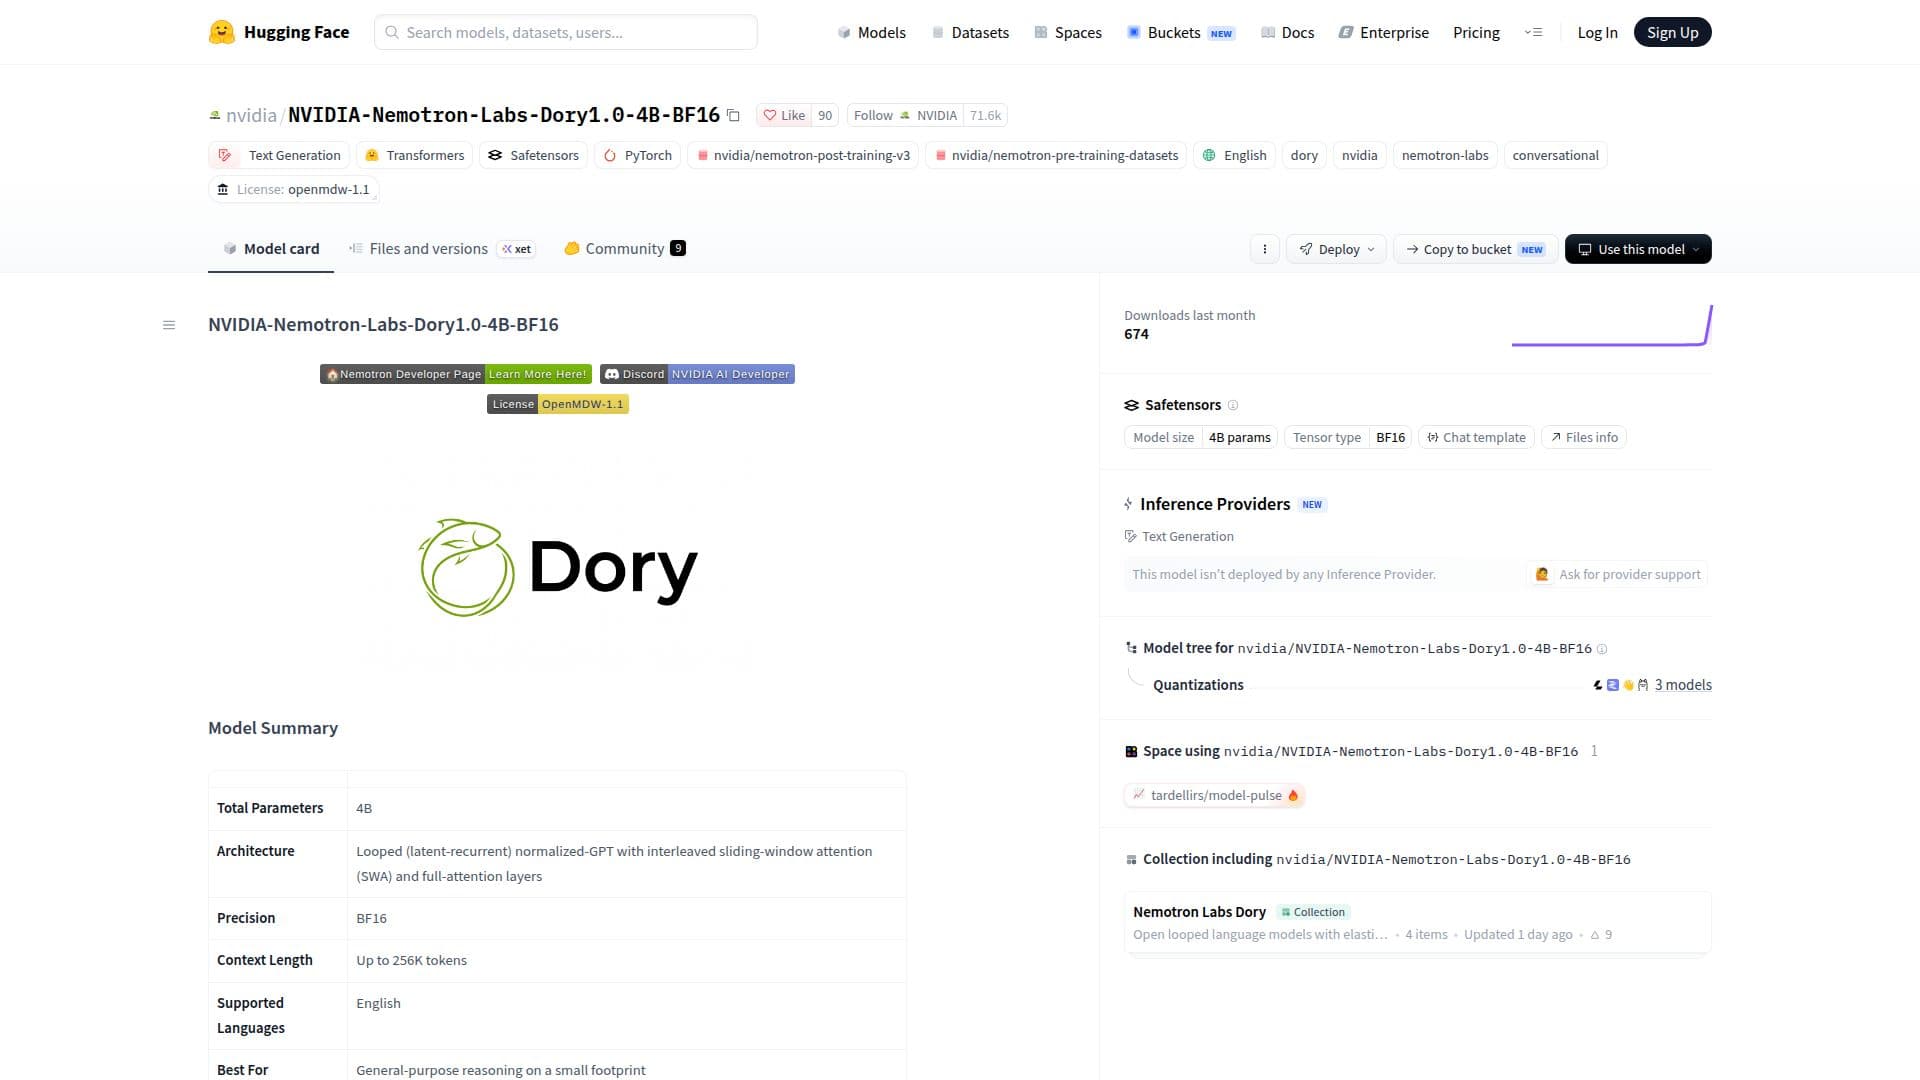
NVIDIA-Nemotron-Labs-Dory1.0-4B-BF16 é um modelo de linguagem grande desenvolvido pela NVIDIA, utilizando uma arquitetura normalizada-GPT em loop (latente-recorrente). Este modelo é projetado para lidar com tarefas de raciocínio de propósito geral, mantendo uma pequena pegada computacional. Ele apresenta atenção em janela deslizante intercalada (SWA) e camadas de atenção total, permitindo processar eficientemente até 256K tokens em comprimento de contexto.
Ler mais
O modelo é construído com 4 bilhões de parâmetros e emprega precisão BF16, tornando-o adequado para aplicações comerciais e não comerciais. Ele suporta processamento na língua inglesa e é mais adequado para tarefas que requerem capacidades gerais de raciocínio. A arquitetura do modelo permite computação de inferência elástica, permitindo que os usuários ajustem o número de loops para equilibrar eficiência computacional e precisão sem a necessidade de re-treinamento.
Dory1.0-4B-BF16 é pré-treinado usando o formato NVFP4 da NVIDIA antes de continuar em BF16, garantindo alto desempenho em sistemas acelerados por GPU da NVIDIA. Está disponível em múltiplos formatos, incluindo BF16, MXFP8, NVFP4 e Q5_K_M, proporcionando flexibilidade na implementação em diferentes configurações de hardware.
O treinamento do modelo envolveu 6 trilhões de tokens, com foco em domínios diversos, como matemática, ciência e conhecimento geral. Ele passou por ajuste fino supervisionado e aprendizado por reforço para melhorar seu desempenho em uso de ferramentas em múltiplas etapas, seguimento de instruções e ambientes de saída estruturada. Os benchmarks do modelo demonstram desempenho competitivo em várias tarefas, incluindo codificação, raciocínio e seguimento de instruções.
NVIDIA-Nemotron-Labs-Dory1.0-4B-BF16 é regido pelo Acordo de Licença OpenMDW, versão 1.1, e foi lançado em 16 de outubro de 2026. Ele é projetado para funcionar de forma otimizada nas arquiteturas Hopper e Blackwell da NVIDIA, com suporte para sistemas operacionais Linux.
- CategoriaModelos de IA e LLMs
- Modelo de preçosCódigo aberto
- ImplantaçãoNuvem
- PlataformasLinux
Destaques de NVIDIA-Nemotron-Labs-Dory1.0-4B-BF16
Arquitetura latente-recorrente em loop
Atenção em janela deslizante intercalada
Comprimento de contexto de 256K tokens
Precisão BF16
Computação de inferência elástica
Pré-treinamento nativo NVFP4
Looping eficiente em memória
Acordo de Licença OpenMDW
Primeiros passos com NVIDIA-Nemotron-Labs-Dory1.0-4B-BF16
Acesse a página do modelo: Visite a página do modelo Hugging Face para NVIDIA-Nemotron-Labs-Dory1.0-4B-BF16.
Autentique-se: Certifique-se de ter as credenciais necessárias para acessar o modelo.
Configure: Configure os parâmetros do modelo, incluindo contagem de loops e configurações de cache KV.
Envie prompts: Insira sequências de texto no modelo para processamento.
Ajuste fino: Ajuste as configurações do modelo para tarefas específicas, se necessário.
Casos de uso de NVIDIA-Nemotron-Labs-Dory1.0-4B-BF16
- Raciocínio Geral
- Tarefas de Codificação
- Seguimento de Instruções
- Processamento de Longo Contexto
- Pesquisa Científica