Descrição
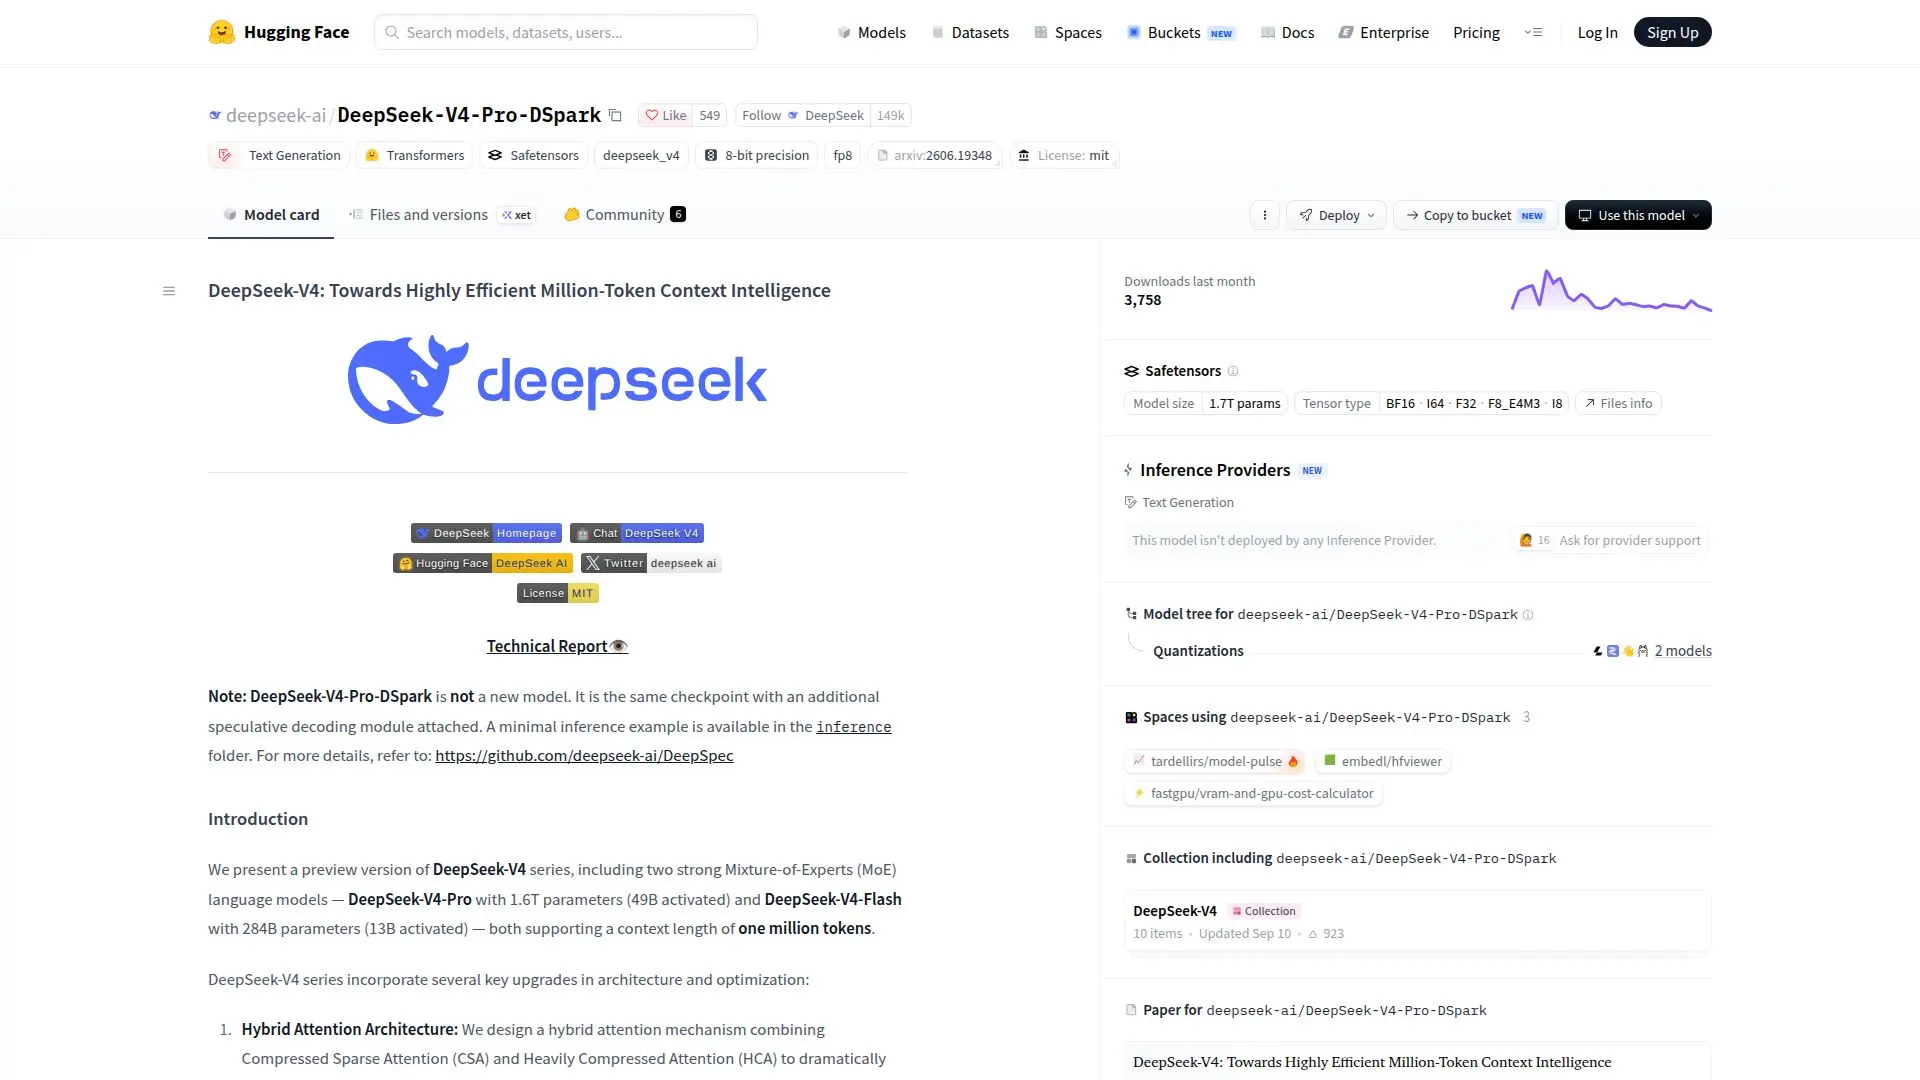
DeepSeek-V4-Pro-DSpark faz parte da série DeepSeek-V4, que inclui modelos de linguagem Mixture-of-Experts (MoE) altamente eficientes. Este modelo é projetado para lidar com extensos comprimentos de contexto de até um milhão de tokens, tornando-o adequado para tarefas complexas de linguagem. A arquitetura de atenção híbrida combina Atenção Esparsa Comprimida (CSA) e Atenção Comprimida Pesada (HCA) para melhorar a eficiência em longos contextos. Além disso, o modelo incorpora hiper-conexões com restrição de variedade (mHC) para melhorar a estabilidade da propagação de sinais entre as camadas.
Ler mais
O modelo DeepSeek-V4-Pro-DSpark é pré-treinado em mais de 32 trilhões de tokens diversos e de alta qualidade, seguido por um pipeline abrangente de pós-treinamento. Este pipeline inclui o cultivo independente de especialistas específicos de domínio através de ajuste fino supervisionado (SFT) e aprendizado por reforço com otimização de política guiada (GRPO), seguido pela consolidação unificada do modelo via destilação em política.
DeepSeek-V4-Pro-DSpark se destaca em vários benchmarks, alcançando desempenho de alto nível em tarefas de codificação e raciocínio. Ele reduz significativamente a lacuna com os principais modelos de código fechado em tarefas de raciocínio e agentes. O modelo suporta três modos de esforço de raciocínio: Não pensar, Pensar Alto e Pensar Máximo, atendendo a diferentes casos de uso, desde tarefas rotineiras até resolução de problemas complexos.
O modelo está disponível para download em plataformas como Hugging Face e ModelScope, e é licenciado sob a Licença MIT. Os usuários podem executar o modelo localmente com instruções detalhadas fornecidas na pasta de inferência, que inclui conversão de pesos do modelo e demonstrações de chat interativas.
- CategoriaModelos de IA e LLMs
- Modelo de preçosGrátis
- ImplantaçãoNuvem, Auto-hospedado
- PlataformasWeb
Destaques de DeepSeek-V4-Pro-DSpark
Arquitetura de Atenção Híbrida
Hiper-Conexões com Restrição de Variedade
Otimizador Muon
Comprimento de Contexto de Um Milhão de Tokens
Modelo Mixture-of-Experts
Código Aberto
Três Modos de Esforço de Raciocínio
Pipeline Abrangente de Pós-Treinamento
Primeiros passos com DeepSeek-V4-Pro-DSpark
Acesse a página do modelo: Visite a página do modelo Hugging Face
Autentique-se: Faça login na sua conta Hugging Face
Configure: Configure o modelo com os parâmetros desejados
Envie prompts: Insira seus prompts de texto para processamento
Ajuste fino: Ajuste as configurações do modelo para tarefas específicas
Casos de uso de DeepSeek-V4-Pro-DSpark
- Processamento de Longos Contextos
- Resolução de Problemas Complexos
- Tarefas Rotineiras
- Benchmarks de Codificação
- Tarefas de Raciocínio