Descrição
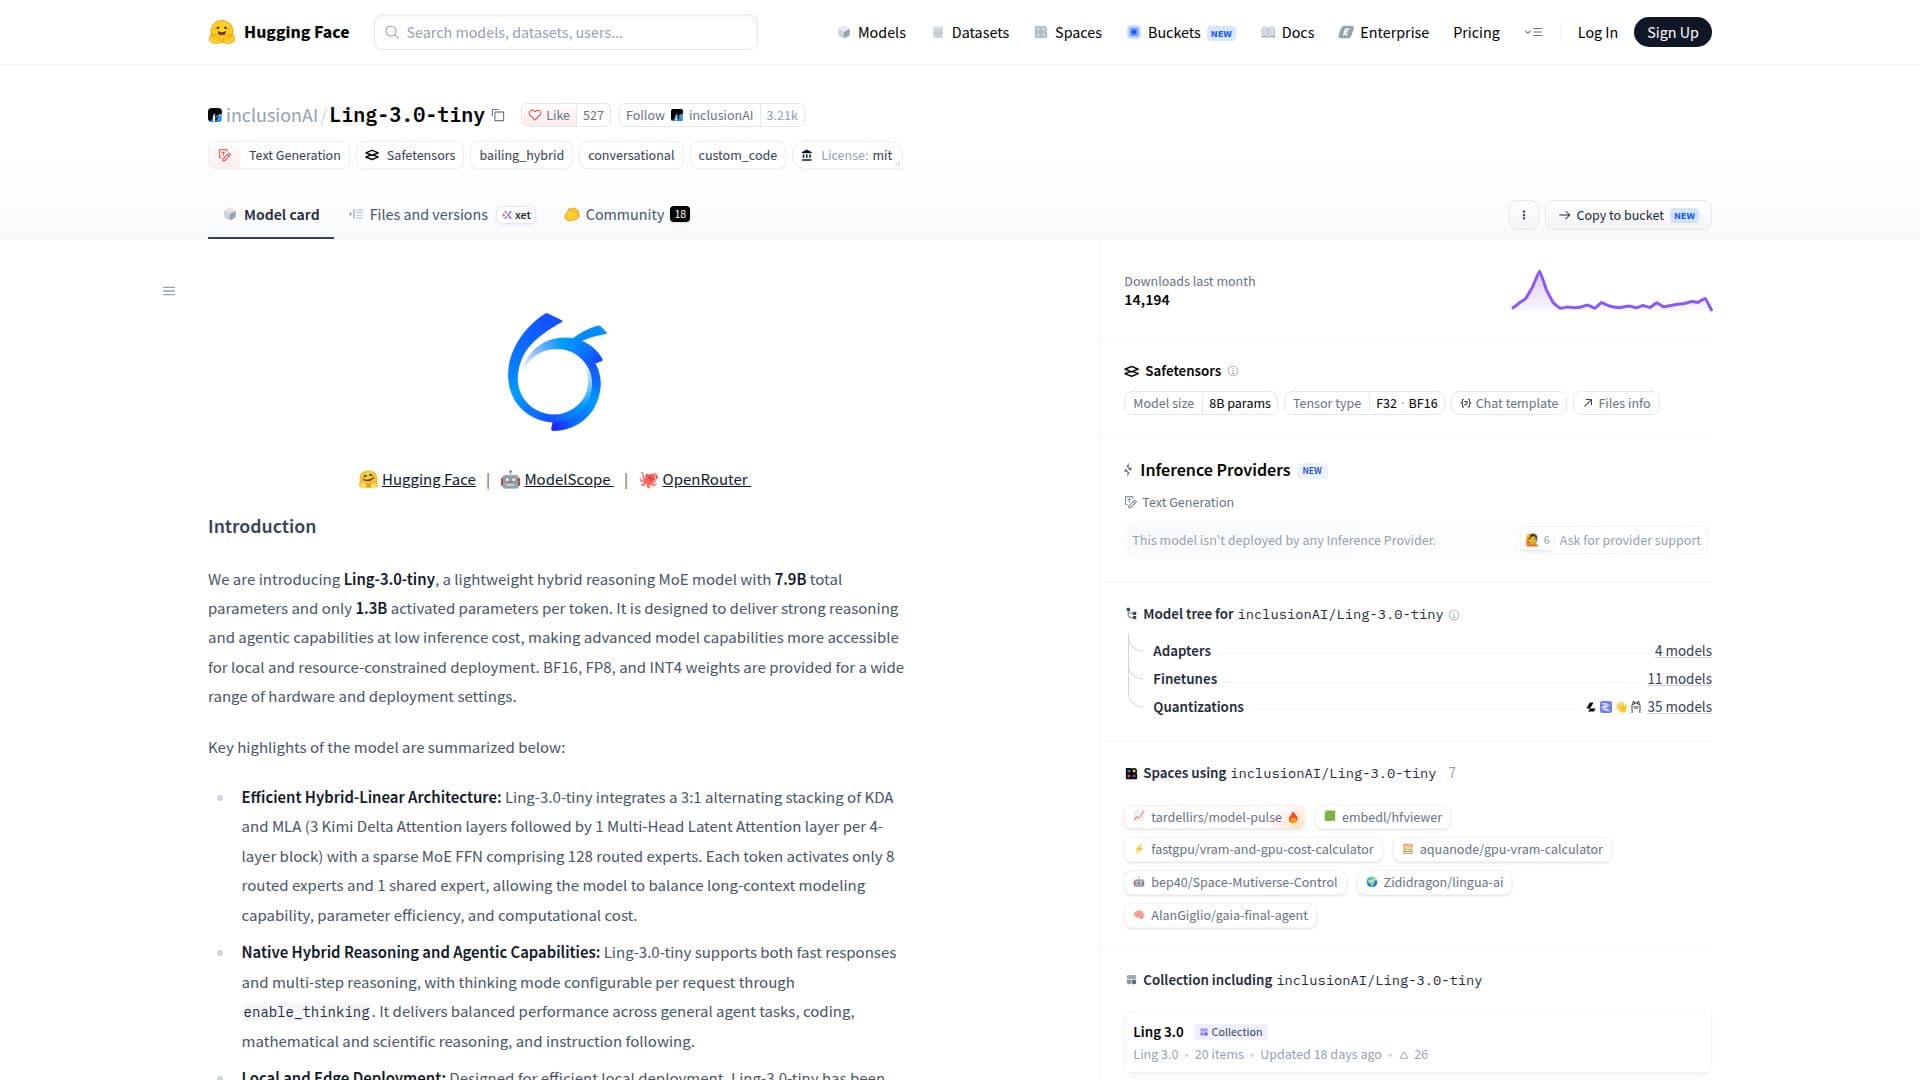
Ling-3.0-tiny é um modelo híbrido de raciocínio leve desenvolvido pela inclusionAI, hospedado no Hugging Face. Ele possui um total de 7,9 bilhões de parâmetros, com apenas 1,3 bilhão ativado por token, tornando-o eficiente para implantações locais e com recursos limitados. O modelo integra uma pilha alternada de 3:1 de camadas de Kimi Delta Attention (KDA) e Multi-Head Latent Attention (MLA), juntamente com uma Rede Feed-Forward (FFN) de Mistura de Especialistas (MoE) esparsa composta por 128 especialistas roteados. Essa arquitetura permite que o modelo equilibre a capacidade de modelagem de longo contexto, eficiência de parâmetros e custo computacional.
Ler mais
Ling-3.0-tiny é projetado para oferecer fortes capacidades de raciocínio e agentic a um baixo custo de inferência. Ele suporta tanto respostas rápidas quanto raciocínio em múltiplas etapas, com um modo de pensamento configurável. O modelo é validado em diversos hardwares, incluindo NVIDIA DGX Spark e Apple Silicon MacBook, permitindo raciocínios e cargas de trabalho agentic capazes sem a necessidade de GPUs de classe datacenter. Com FP8, ele alcança cerca de 100-105 tokens por segundo no DGX Spark e 86-90 tokens por segundo em um MacBook M4 Pro, com aproximadamente 8,34 GiB de uso de memória máxima em um comprimento de contexto de 8K.
A eficiência do modelo é destacada pelo seu desempenho no Artificial Analysis Intelligence Index v4.1.1, com uma pontuação de 25, e no Artificial Analysis Agentic Index, com uma pontuação de 16. Ele atinge uma velocidade de saída de mais de 160 tokens por segundo, com aproximadamente 18 segundos de latência de ponta a ponta para uma resposta de 500 tokens. Ling-3.0-tiny é adequado para uma ampla gama de tarefas, incluindo tarefas agentic, codificação, compreensão de longo contexto, confiabilidade do conhecimento, raciocínio matemático e científico, e seguimento de instruções.
- CategoriaModelos de IA e LLMs
- Modelo de preçosFreemium
- ImplantaçãoRoda localmente
- PlataformasWeb
Destaques de Ling-3.0-tiny
7,9B parâmetros totais
1,3B parâmetros ativados por token
Capacidades híbridas de raciocínio
Implantação local eficiente
Arquitetura KDA-MLA 3:1
FFN MoE esparsa com 128 especialistas
Suporta respostas rápidas e raciocínio em múltiplas etapas
Validado em NVIDIA DGX Spark e Apple Silicon
Primeiros passos com Ling-3.0-tiny
Acesse a página do modelo: Visite o Hugging Face
Autentique-se: Faça login na sua conta
Configure: Defina os parâmetros do modelo
Envie prompts: Use o modelo para inferência
Ajuste fino: Ajuste as configurações para tarefas específicas
Casos de uso de Ling-3.0-tiny
- Tarefas Agentic
- Codificação
- Raciocínio Científico
- Seguimento de Instruções
- Implantação Local