

Descrição
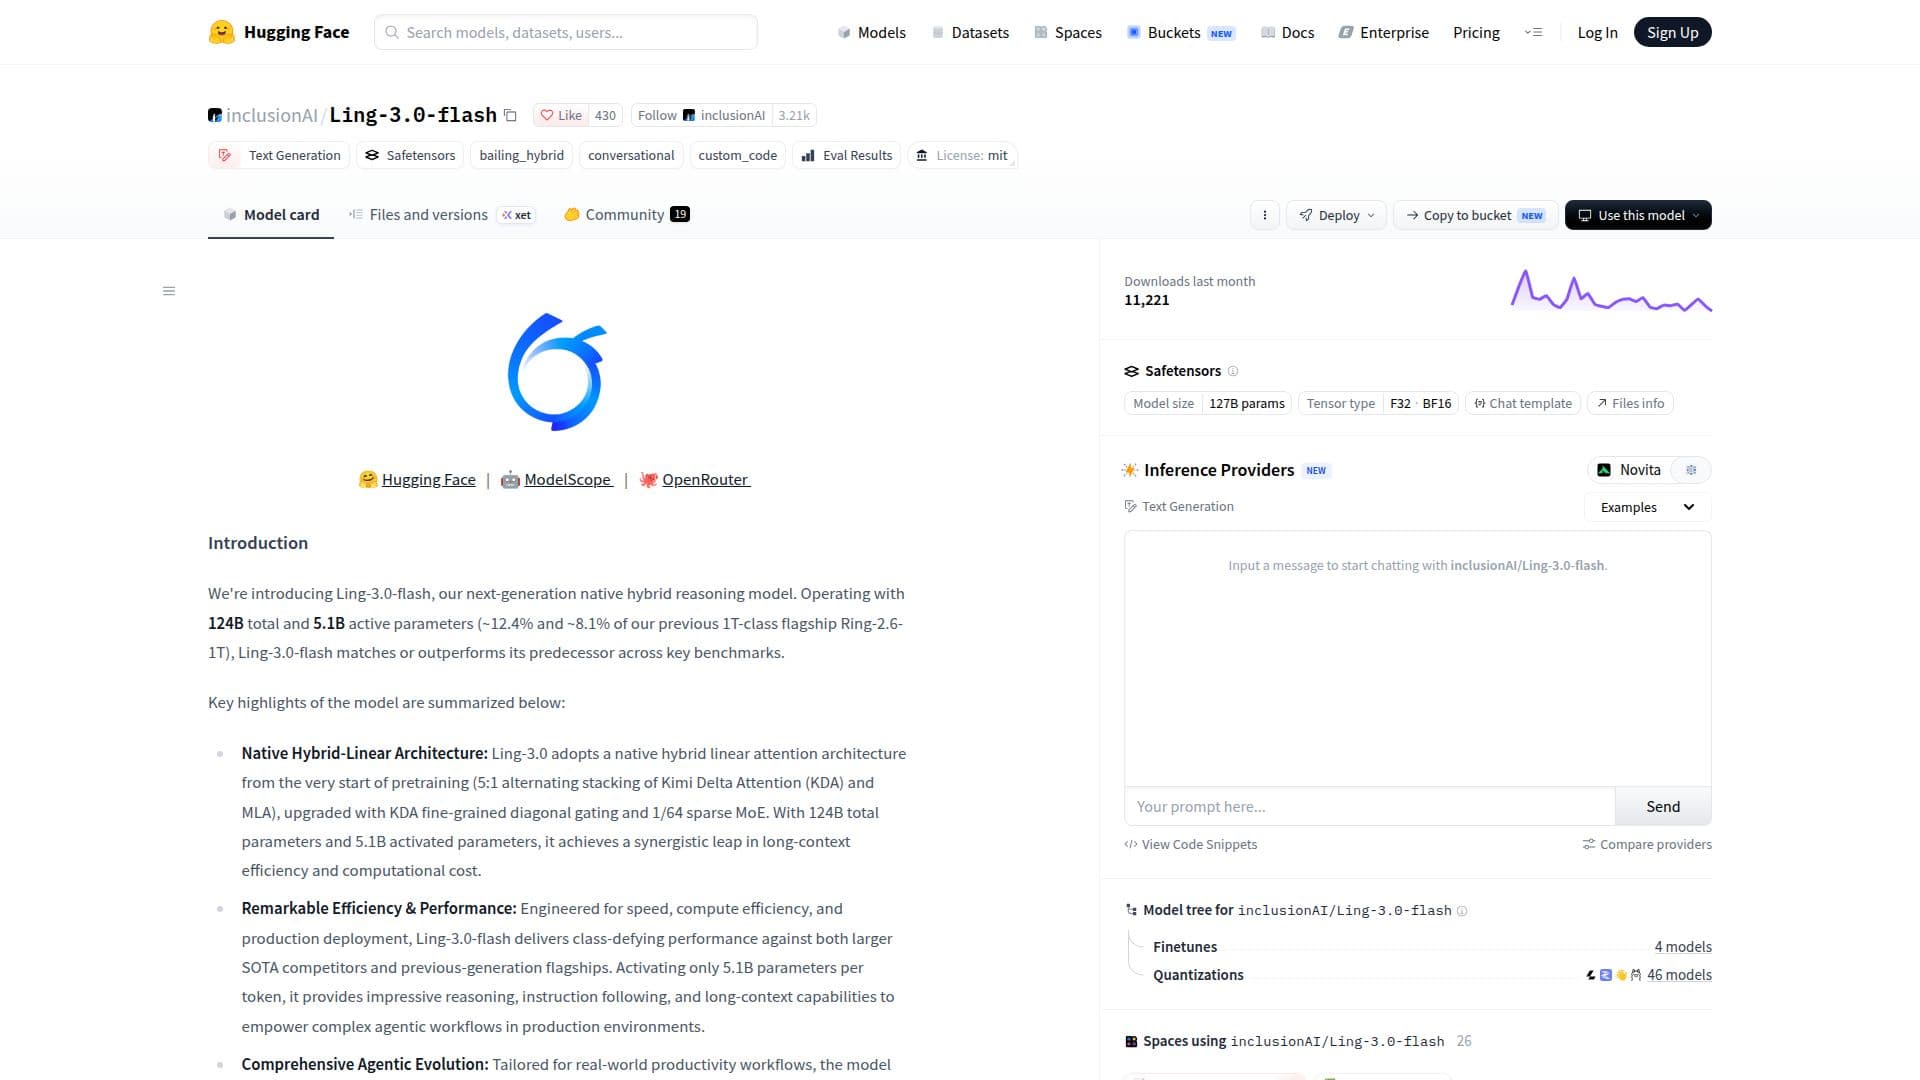
Ling-3.0-flash é um modelo de raciocínio híbrido de ponta desenvolvido pela inclusionAI e hospedado no Hugging Face. Ele opera com um total de 124 bilhões de parâmetros, com 5,1 bilhões ativados por token, proporcionando eficiência e desempenho notáveis. O modelo adota uma arquitetura nativa de atenção linear híbrida, apresentando Kimi Delta Attention (KDA) e MLA, aprimorada com controle diagonal de alta granularidade e MoE esparso. Essa arquitetura permite que o Ling-3.0-flash alcance um salto sinérgico na eficiência de longos contextos e no custo computacional.
Ler mais
Projetado para velocidade e eficiência computacional, o Ling-3.0-flash oferece desempenho que desafia as classes em comparação com concorrentes maiores de última geração e modelos de bandeira da geração anterior. Ele capacita fluxos de trabalho complexos em ambientes de produção, ativando apenas 5,1 bilhões de parâmetros por token. O modelo incorpora mais de 10.000 ambientes de treinamento interativos para alcançar execução de ciclo fechado de ponta a ponta em tarefas de codificação, gerais e de pesquisa profunda.
Ling-3.0-flash integra a arquitetura de cache hierárquico SGLang HiCache + Mooncake, apresentando pools duais físicos e um cache L3 compartilhado por cluster. Essa configuração elimina recomputações redundantes durante interações de longo horizonte, reduzindo o Tempo para o Primeiro Token (TTFT) em 60% a mais de 80% em cenários de entrada longa. O modelo se destaca em vários benchmarks autoritativos, incluindo SWE-Bench Pro, SWE-Bench Multilingual, Tau3-banking-AA, MCP-Atlas e SkillsBench.
O modelo é adaptado para fluxos de trabalho de produtividade do mundo real, oferecendo desempenho forte em conhecimento geral, raciocínio matemático, seguimento de instruções e compreensão de longos contextos. O Ling-3.0-flash é projetado para implantação em produção, oferecendo capacidades de raciocínio impressionantes e eficiência em longos contextos, tornando-o adequado para fluxos de trabalho complexos.
- CategoriaModelos de IA e LLMs
- Modelo de preçosFreemium
- ImplantaçãoNuvem
- PlataformasWeb
Destaques de Ling-3.0-flash
Arquitetura Linear Híbrida Nativa
Eficiência e Desempenho Notáveis
Evolução Abrangente Agentic
SGLang HiCache + Cache Mooncake
Execução de Ciclo Fechado de Ponta a Ponta
Eficiência em Longos Contextos
Seguimento de Instruções
Raciocínio Matemático
Primeiros passos com Ling-3.0-flash
Acesse a página do modelo: Visite o Hugging Face
Autentique-se: Faça login na sua conta
Configure: Defina parâmetros e preferências
Envie prompts: Insira suas consultas
Ajuste: Modifique as configurações do modelo
Casos de uso de Ling-3.0-flash
- Tarefas de Codificação
- Agentes de Pesquisa
- Seguimento de Instruções
- Compreensão de Longos Contextos
- Raciocínio Matemático







