Pular para o conteúdo principal
ToolPotion
Consultor de IA
Enviar

d1-2B

LLMsModelos de IA e LLMsCódigo aberto · Web

d1-2B é um modelo de decisão construído sobre o LFM3-VL-2B, projetado para análise de texto, imagens e vídeo. Ele fornece respostas calibradas em uma única passagem para frente, sem gerar tokens. Este modelo se destaca em vários benchmarks de decisão, oferecendo capacidades além da classificação, incluindo extração de texto, localização de objetos e estimativa de quantidades. É otimizado para tomada de decisão rápida em diversas aplicações.

Visitar URL
Compartilhar
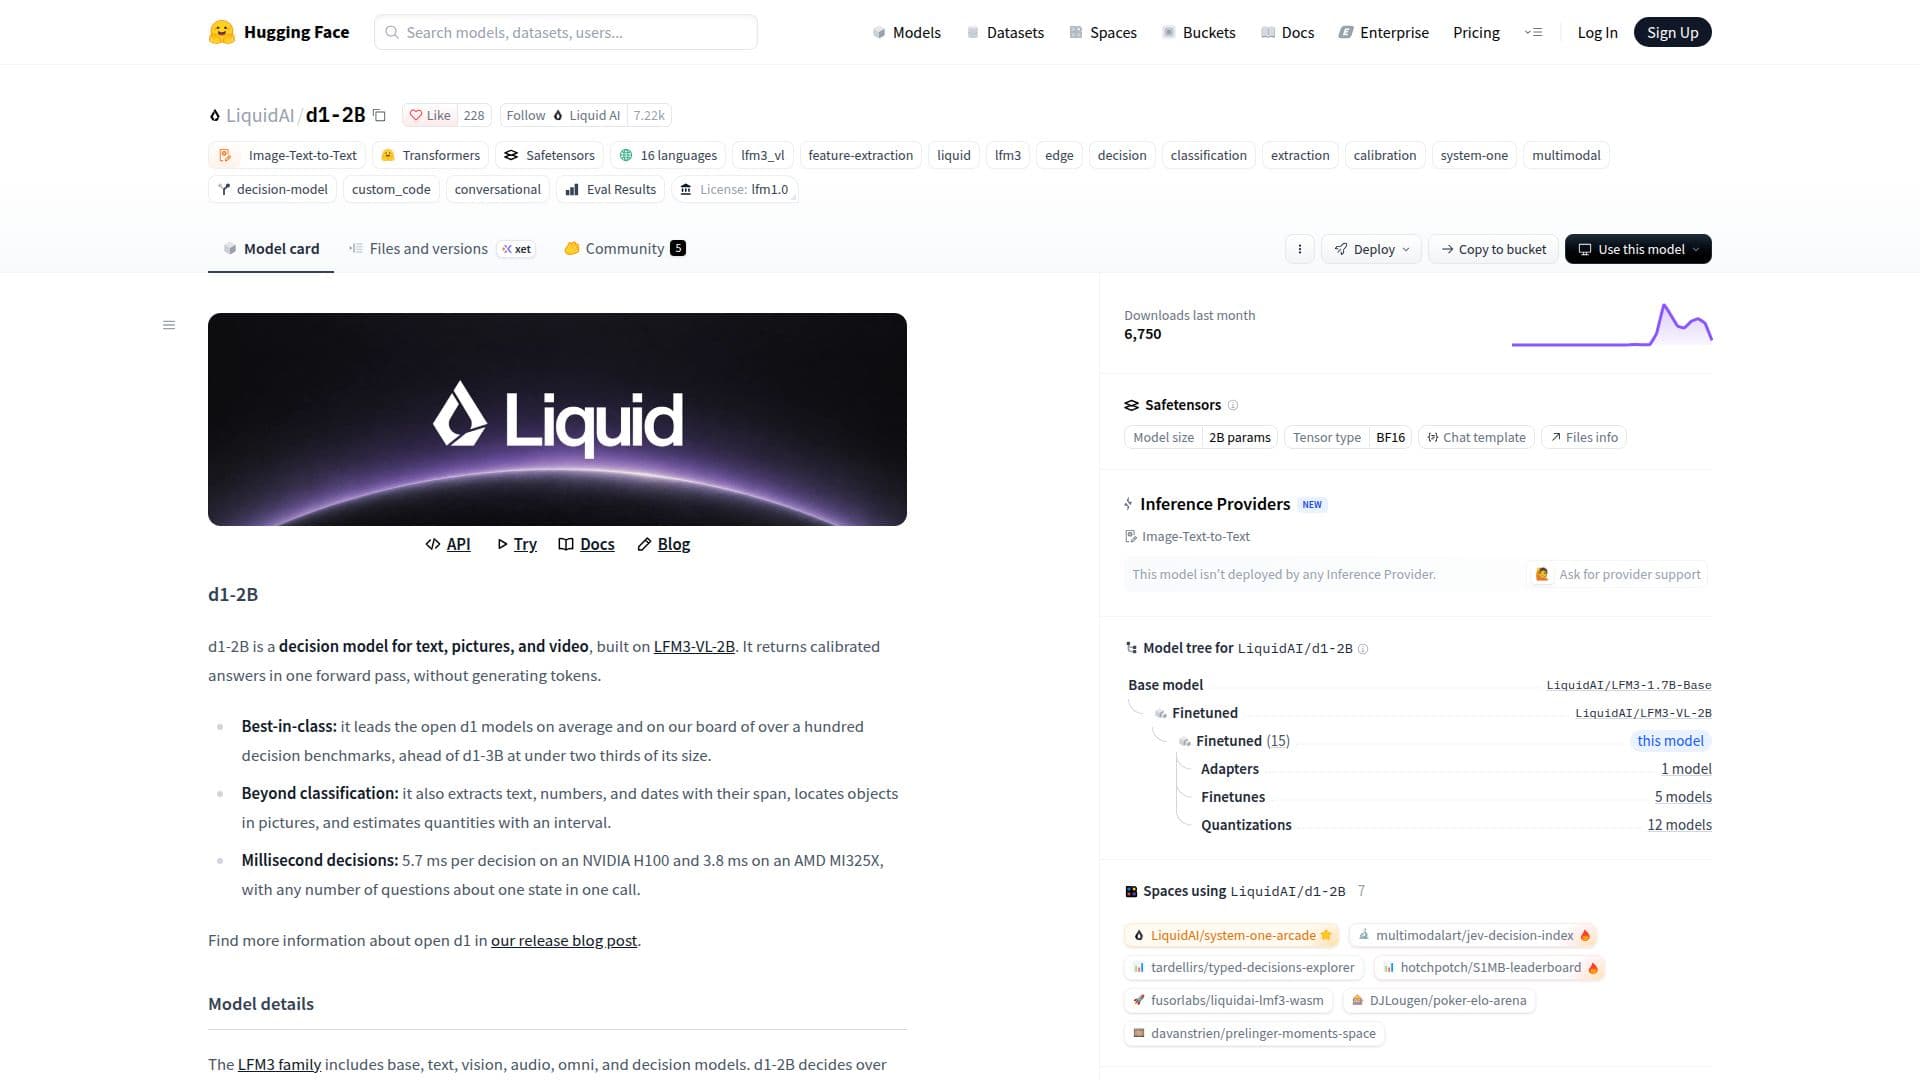
Captura de tela do d1-2B

d1-2B é um modelo de decisão altamente eficiente desenvolvido pela LiquidAI, disponível no Hugging Face. Construído sobre a arquitetura LFM3-VL-2B, este modelo é projetado para processar e tomar decisões com base em entradas multimodais, incluindo texto, imagens e vídeo. Uma característica chave do d1-2B é sua capacidade de retornar respostas calibradas em uma única passagem para frente, eliminando a necessidade de geração de tokens, o que contribui para sua velocidade e eficiência.

Ler mais

O modelo demonstra desempenho de classe mundial entre os modelos d1 abertos, liderando em média em mais de cem benchmarks de decisão. Apesar de ser menor que o d1-3B, muitas vezes supera este, mostrando seu design otimizado. Além das tarefas tradicionais de classificação, o d1-2B oferece capacidades avançadas, como a extração de texto específico, números e datas com seus intervalos, localização precisa de objetos dentro de imagens e estimativa de quantidades com intervalos definidos.

O desempenho é uma vantagem significativa, com o d1-2B alcançando tempos de decisão de 5,7 milissegundos em um NVIDIA H100 e 3,8 milissegundos em um AMD MI325X. Este processamento rápido é mantido mesmo com múltiplas perguntas sobre um único estado em uma única chamada. A família LFM3, que inclui o d1-2B, apresenta modelos base, de texto, visão, áudio, omni e de decisão. Enquanto o d1-2B lida com texto, imagens e vídeo, seu irmão d1-Omni-2B estende as capacidades para incluir áudio.

Com 1,92 bilhões de parâmetros e uma arquitetura de backbone LFM3 composta por 24 camadas (13 convoluções curtas com portão, 5 atenções de janela deslizante, 6 atenções globais), o d1-2B suporta um comprimento de contexto de 128K tokens e um vocabulário de 128.000 tokens. Ele aceita entradas como um estado (texto ou JSON), imagens ou vídeo, juntamente com qualquer número de perguntas nomeadas, produzindo respostas tipadas com probabilidades sem gerar tokens. Suporta uma ampla gama de idiomas, incluindo inglês, árabe, chinês, francês, alemão, italiano, japonês, coreano, português, espanhol, vietnamita, tailandês, indonésio, hindi, russo e polonês.

o d1-2B é versátil, adequado para várias etapas de pipeline que requerem decisões, como roteamento e triagem, moderação de conteúdo, classificação de intenção e tópico, extração de dados de documentos, julgamento e reclassificação, e inspeção visual. É explicitamente notado como não sendo um modelo de chat. Embora seja eficaz para perguntas com alto conteúdo de conhecimento, a confiabilidade pode diminuir além de 64K tokens de estado. As estimativas são confiáveis para contagens e pontuações, mas menos para quantidades livres. O modelo roda em Transformers com seu próprio código, não exigindo parâmetros de amostragem.

  • CategoriaModelos de IA e LLMs
  • Modelo de preçosCódigo aberto
  • ImplantaçãoNuvem
  • PlataformasWeb

  • Modelo de Decisão Multimodal (Texto, Imagens, Vídeo)

  • 2 Bilhões de Parâmetros

  • Passagem Única para Respostas Calibradas

  • Sem Geração de Tokens

  • Desempenho em Benchmarks de Decisão de Classe Mundial

  • Extração de Texto, Números e Datas

  • Localização de Objetos em Imagens

  • Estimativa de Quantidade com Intervalos

  • Velocidade de Decisão em Milissegundos (ex: 3,8 ms no AMD MI325X)

  • Arquitetura de Backbone LFM3

  • Comprimento de Contexto de 128K Tokens

  • Vocabulário de 128.000 Tokens

  • Suporte Multilíngue (15+ idiomas)

  • Projetado para Roteamento, Triagem, Moderação, Extração

  • Roda em Transformers com Código de Modelo Personalizado

  1. Acesse a Página do Modelo: Navegue até a página do modelo LiquidAI/d1-2B no Hugging Face.

  2. Explore os Arquivos: Revise os detalhes do modelo, arquitetura e especificações fornecidas.

  3. Configure a Inferência: Utilize a biblioteca Transformers para configurar o modelo para inferência.

  4. Prepare as Entradas: Forneça um estado (texto ou JSON), imagens ou vídeo, juntamente com perguntas nomeadas.

  5. Execute as Chamadas: Use `system_one` para solicitações únicas ou `system_one_batch` para solicitações em lote.

  6. Interprete a Saída: Receba respostas tipadas com probabilidades, sem tokens gerados.

  • Roteamento e Triagem
  • Moderação e Guardrails
  • Classificação de Intenção
  • Classificação de Tópicos
  • Extração de Documentos
  • Julgamento e Reclassificação
  • Inspeção Visual
  • Tomada de Decisão Multimodal

Avaliações de d1-2B

Carregando...

Ferramentas de IA populares como d1-2B

LiquidAI d1-omni-600M é um modelo de decisão com 600 milhões de parâmetros, projetado para decisões em uma única passagem sobre texto, imagens e fala. Ele processa eficientemente…

Modelos de IA e LLMs
Ver ferramenta

Modelo de decisão com 600 milhões de parâmetros, projetado para decisões em uma única passagem sobre texto, imagens e fala. Ele processa eficientemente…LiquidAI d1-omni-600M é um modelo de decisão com 600 milhões de parâmetros, projetado para decisões em uma única passagem sobre texto, imagens e fala. Ele processa eficientemente…

Modelos de IA e LLMs
Ver o Top 50 de LLMs

LiquidAI d1-Omni-2B

Modelos de IA

LiquidAI d1-Omni-2B é um modelo de decisão projetado para processar texto, imagens e áudio. Ele fornece respostas calibradas rapidamente sem gerar tokens, tornando-o ideal para…

Modelos de IA e LLMs
Ver ferramenta

Modelos de IA

Modelo de decisão projetado para processar texto, imagens e áudio. Ele fornece respostas calibradas rapidamente sem gerar tokens, tornando-o ideal para…LiquidAI d1-Omni-2B é um modelo de decisão projetado para processar texto, imagens e áudio. Ele fornece respostas calibradas rapidamente sem gerar tokens, tornando-o ideal para…

Modelos de IA e LLMs
Ver o Top 5 de Modelos de IA

d3-ultra

Modelos de IA

d3-ultra é um modelo de decisão multimodal de 27B do vLLM Semantic Router. Ele processa texto, JSON, imagens e vídeos para responder perguntas com probabilidades. Ideal para…

Modelos de IA e LLMs
Ver ferramenta

Modelos de IA

Modelo de decisão multimodal de 27B do vLLM Semantic Router. Ele processa texto, JSON, imagens e vídeos para responder perguntas com probabilidades. Ideal para…d3-ultra é um modelo de decisão multimodal de 27B do vLLM Semantic Router. Ele processa texto, JSON, imagens e vídeos para responder perguntas com probabilidades. Ideal para…

Modelos de IA e LLMs
Ver o Top 5 de Modelos de IA

GLiDE 27B é um modelo de decisão com 27 bilhões de parâmetros desenvolvido pela Fastino. Ele processa estados contendo texto, JSON e imagens opcionais para responder a perguntas…

Modelos de IA e LLMs
Ver ferramenta

Modelo de decisão com 27 bilhões de parâmetros desenvolvido pela Fastino. Ele processa estados contendo texto, JSON e imagens opcionais para responder a perguntas…GLiDE 27B é um modelo de decisão com 27 bilhões de parâmetros desenvolvido pela Fastino. Ele processa estados contendo texto, JSON e imagens opcionais para responder a perguntas…

Modelos de IA e LLMs
Ver o Top 50 de LLMs

DeepSeek-V4-Flash-Vision-Exp é um modelo multimodal experimental da família DeepSeek-V4, que aprimora as capacidades de compreensão visual. Ele se baseia na arquitetura…

Modelos de IA e LLMs
Ver ferramenta

Modelo multimodal experimental da família DeepSeek-V4, que aprimora as capacidades de compreensão visual. Ele se baseia na arquitetura…DeepSeek-V4-Flash-Vision-Exp é um modelo multimodal experimental da família DeepSeek-V4, que aprimora as capacidades de compreensão visual. Ele se baseia na arquitetura…

Modelos de IA e LLMs
Ver o Top 50 de LLMs

Ling-3.1-flash é um modelo avançado de raciocínio híbrido projetado para tarefas complexas do mundo real. Ele possui 560 bilhões de parâmetros no total e uma janela de contexto de…

Modelos de IA e LLMs

Nº 41 em LLMs

Ver ferramenta

Modelo avançado de raciocínio híbrido projetado para tarefas complexas do mundo real. Ele possui 560 bilhões de parâmetros no total e uma janela de contexto de…Ling-3.1-flash é um modelo avançado de raciocínio híbrido projetado para tarefas complexas do mundo real. Ele possui 560 bilhões de parâmetros no total e uma janela de contexto de…

Modelos de IA e LLMs
Nº 41 em LLMs

LiquidAI LFM3-1.7B é um modelo de texto projetado para agentes locais e aplicações especializadas. Ele apresenta uma arquitetura tri-híbrida e suporta uma janela de contexto de…

Modelos de IA e LLMs
Ver ferramenta

Modelo de texto projetado para agentes locais e aplicações especializadas. Ele apresenta uma arquitetura tri-híbrida e suporta uma janela de contexto de…LiquidAI LFM3-1.7B é um modelo de texto projetado para agentes locais e aplicações especializadas. Ele apresenta uma arquitetura tri-híbrida e suporta uma janela de contexto de…

Modelos de IA e LLMs
Ver o Top 50 de LLMs

MiniMax-M3.1-Flash é um modelo multimodal de mistura de especialistas projetado para codificação, fluxos de trabalho agentes e cibersegurança. Ele suporta entradas de texto,…

Modelos de IA e LLMs
Ver ferramenta

Modelo multimodal de mistura de especialistas projetado para codificação, fluxos de trabalho agentes e cibersegurança. Ele suporta entradas de texto,…MiniMax-M3.1-Flash é um modelo multimodal de mistura de especialistas projetado para codificação, fluxos de trabalho agentes e cibersegurança. Ele suporta entradas de texto,…

Modelos de IA e LLMs
Ver o Top 50 de LLMs
1 de 8