Descrição
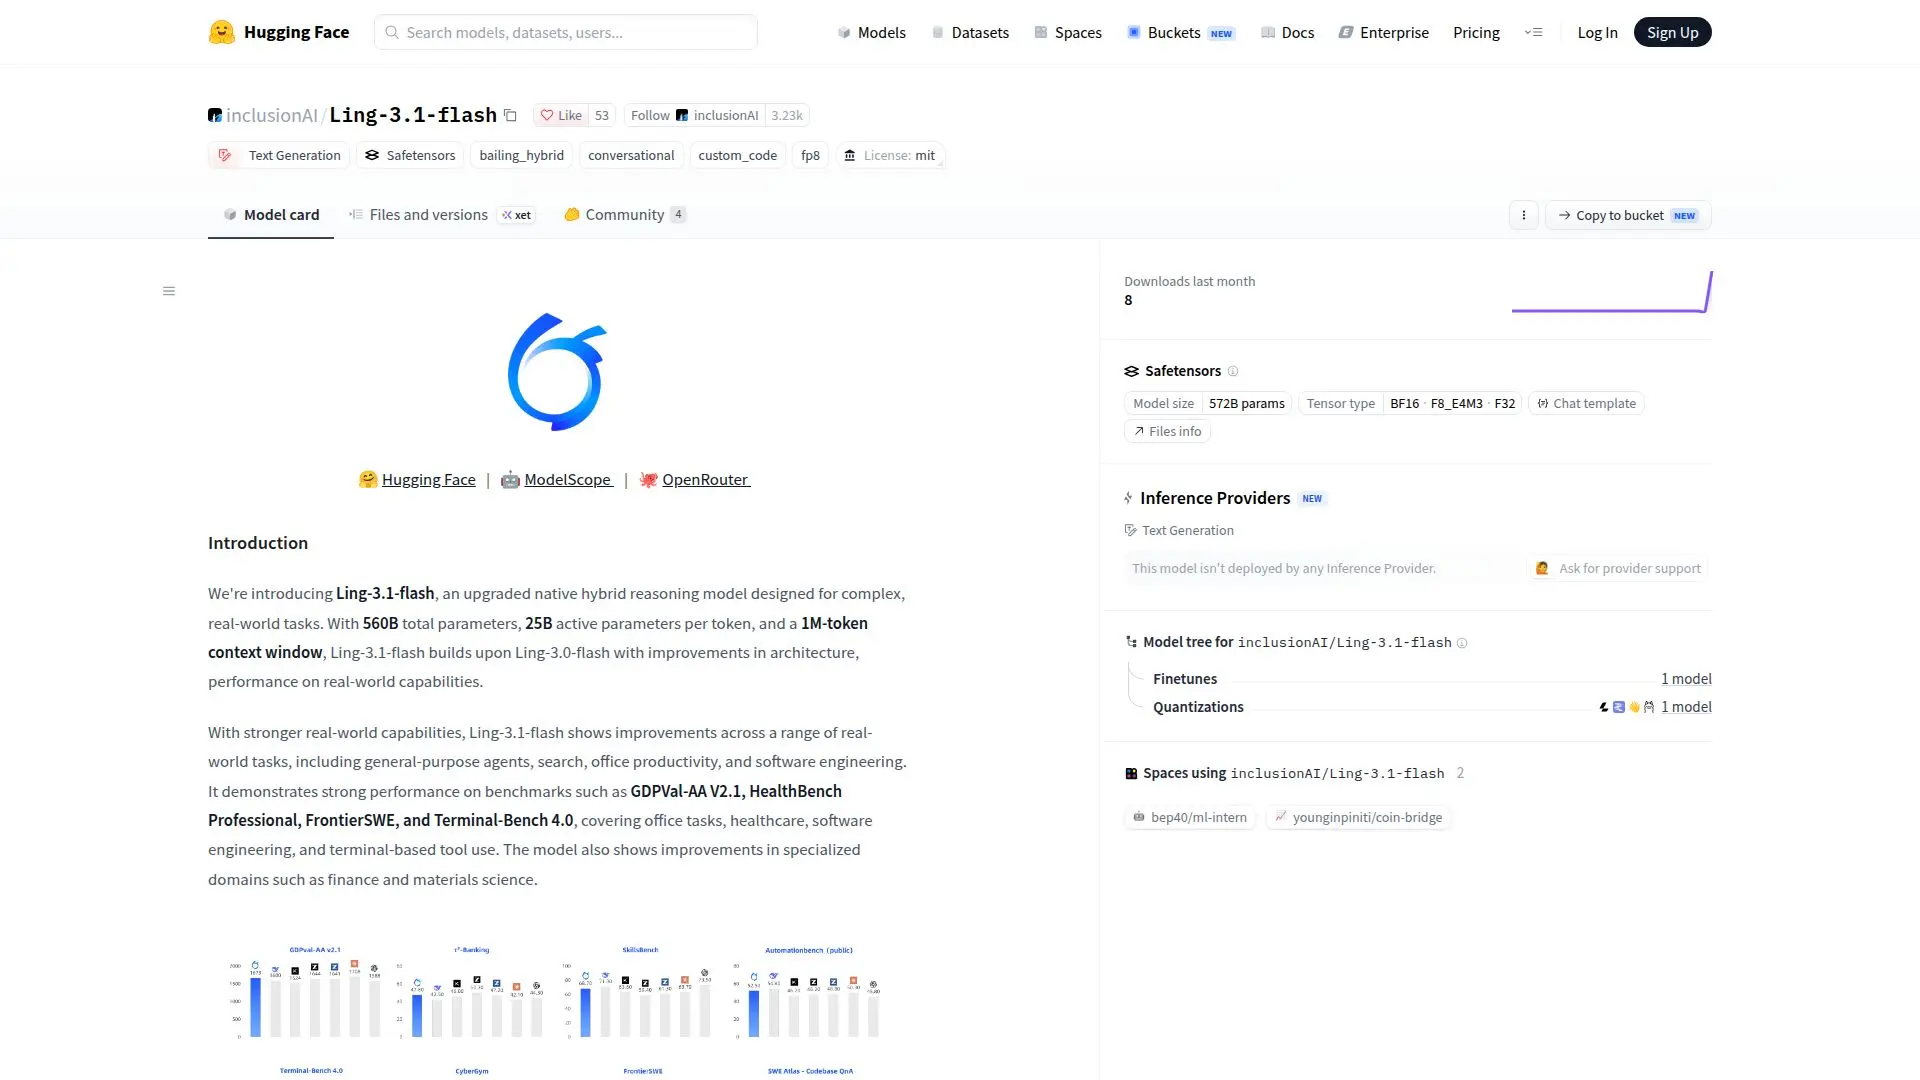
Ling-3.1-flash é um modelo nativo de raciocínio híbrido atualizado introduzido pela inclusionAI na plataforma Hugging Face. Projetado para enfrentar tarefas complexas do mundo real, este modelo possui um total de 560 bilhões de parâmetros, com 25 bilhões de parâmetros ativos por token e uma janela de contexto de 1 milhão de tokens. Essas melhorias se baseiam em seu antecessor, Ling-3.0-flash, oferecendo uma arquitetura e desempenho aprimorados.
Ler mais
O modelo se destaca em uma variedade de aplicações do mundo real, como agentes de uso geral, busca, produtividade em escritório e engenharia de software. Ele demonstrou um desempenho forte em benchmarks como GDPVal-AA V2.1, HealthBench Professional, FrontierSWE e Terminal-Bench 4.0. Esses benchmarks abrangem uma ampla gama de tarefas, incluindo tarefas de escritório, saúde, engenharia de software e uso de ferramentas baseadas em terminal. Além disso, Ling-3.1-flash apresenta melhorias notáveis em domínios especializados, como finanças e ciência dos materiais.
A arquitetura do Ling-3.1-flash é baseada em um modelo híbrido-linear de mistura de especialistas (MoE), apresentando 63 KDA e 9 camadas de transformadores Gated MLA, 4 camadas densas e 512 especialistas roteados. O modelo também inclui 64 cabeças de atenção e um tamanho oculto de 4096, com um tamanho de vocabulário de 157.184.
Ling-3.1-flash foi avaliado em vários benchmarks autoritativos, demonstrando seu forte desempenho em tarefas de codificação e agentes. Ele suporta frameworks como Claude Code, Kilo Code, Qwen Code, Hermes Agent e OpenClaw. O modelo também introduz o LingCode, um suporte construído sobre o agente de codificação de código aberto Pi, que melhora o desempenho em tarefas de codificação complexas e de longo prazo.
Para os usuários que desejam começar, a imagem SGLang recomendada inclui suporte ao Ling-3.1-flash, decodificação especulativa MTP e otimizações de decodificação Hopper. O modelo está disponível para inferência em várias configurações de servidor, e receitas verificadas são fornecidas para diferentes configurações de hardware.
- CategoriaModelos de IA e LLMs
- Modelo de preçosCódigo aberto
- ImplantaçãoNuvem
- PlataformasWeb
Destaques de Ling-3.1-flash
560B parâmetros totais
janela de contexto de 1M tokens
Arquitetura híbrido-linear MoE
63 KDA + 9 camadas Gated MLA
512 especialistas roteados
64 cabeças de atenção
Suporta múltiplos frameworks
Desempenho forte em benchmarks
Primeiros passos com Ling-3.1-flash
Acesse a página do modelo: Visite Hugging Face
Autentique-se: Faça login na sua conta
Configure: Configure o ambiente do servidor ou cliente
Envie prompts: Use receitas verificadas para inferência
Casos de uso de Ling-3.1-flash
- Agentes de uso geral
- Produtividade em escritório
- Engenharia de software
- Aplicações de saúde
- Análise financeira