Descrição
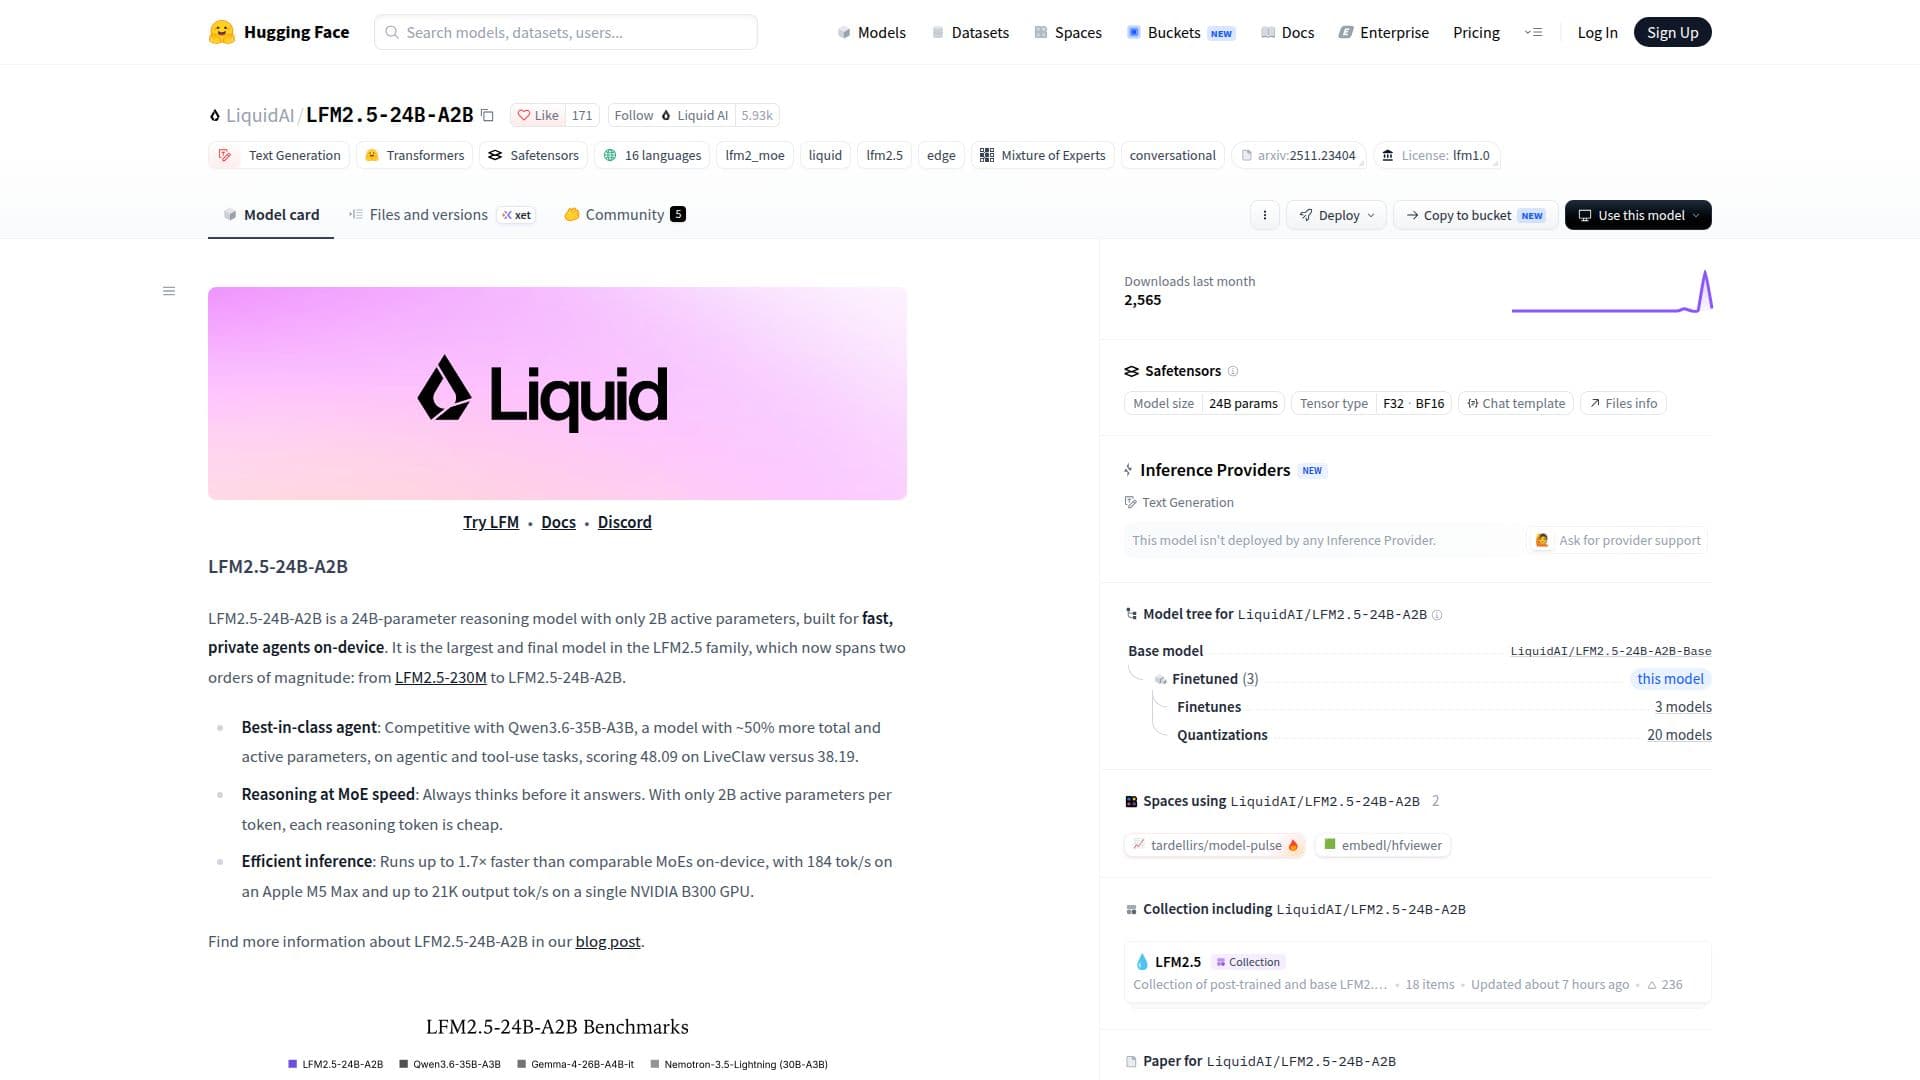
LiquidAI LFM2.5-24B-A2B é um modelo de raciocínio de última geração projetado para operar de forma eficiente com apenas 2B de parâmetros ativos de um total de 24B. Este modelo faz parte da família LFM2.5 e é adaptado para aplicações rápidas e privadas em dispositivos. Ele se destaca em tarefas de uso de ferramentas e raciocínio, demonstrando desempenho competitivo em relação a modelos maiores como Qwen3.6-35B-A3B.
Ler mais
O modelo é projetado para inferência eficiente, funcionando até 1,7 vezes mais rápido do que modelos comparáveis em dispositivos como o Apple M5 Max e a GPU NVIDIA B300. Ele suporta uma ampla gama de idiomas, incluindo inglês, árabe, chinês e mais, tornando-o versátil para aplicações multilíngues.
LFM2.5-24B-A2B está disponível em vários formatos, incluindo FP8 para serviço de GPU de alto rendimento, GGUF para inferência em CPU e ONNX para implantação em várias plataformas. Essa flexibilidade permite que ele seja integrado em diversos ambientes, desde nuvem até edge e dispositivos móveis.
O modelo é particularmente adequado para aplicações que exigem capacidades de raciocínio e chamada de ferramentas. Ele suporta chamadas de função em um processo estruturado de quatro etapas, aumentando sua utilidade em fluxos de trabalho de agentes. No entanto, não é recomendado para tarefas que exigem muito conhecimento sem capacidades suplementares de recuperação ou busca na web.
Para desenvolvedores, LFM2.5-24B-A2B oferece amplas opções de ajuste fino, incluindo ajuste fino supervisionado e otimização direta de preferências usando frameworks como Unsloth e TRL. O desempenho do modelo foi avaliado em várias tarefas, mostrando consistentemente alta eficiência e velocidade.
No geral, LiquidAI LFM2.5-24B-A2B é uma escolha robusta para desenvolvedores que buscam um modelo de raciocínio poderoso e eficiente para aplicações em dispositivos.
- CategoriaModelos de IA e LLMs
- Modelo de preçosCódigo aberto
- ImplantaçãoNuvem, On-premises
- PlataformasWeb, Windows, macOS
Destaques de LiquidAI LFM2.5-24B-A2B
24B parâmetros totais
2B parâmetros ativos
Inferência eficiente em dispositivos
Suporta múltiplas línguas
Capacidades de chamada de ferramentas
Disponível em múltiplos formatos
Suporte a ajuste fino
Inferência de GPU em alta velocidade
Primeiros passos com LiquidAI LFM2.5-24B-A2B
Acesse a página do modelo: Visite a página do modelo no Hugging Face
Autentique-se: Faça login na sua conta do Hugging Face
Configure: Configure o modelo para seu caso de uso específico
Envie prompts: Use o modelo para tarefas de raciocínio
Ajuste fino: Personalize o modelo com seus dados
Casos de uso de LiquidAI LFM2.5-24B-A2B
- Suporte Multilíngue
- Agentes em Dispositivos
- Fluxos de Trabalho de Chamada de Ferramentas
- Implantação Multiplataforma
- Aplicações de Ajuste Fino