Pular para o conteúdo principal
ToolPotion
Consultor de IA
Enviar

LiquidAI d1-omni-600M

LLMsModelos de IA e LLMsCódigo aberto · Web

LiquidAI d1-omni-600M é um modelo de decisão com 600 milhões de parâmetros, projetado para decisões em uma única passagem sobre texto, imagens e fala. Ele processa eficientemente entradas multimodais para fornecer respostas rápidas e precisas sem gerar tokens de saída.

Visitar URL
Compartilhar
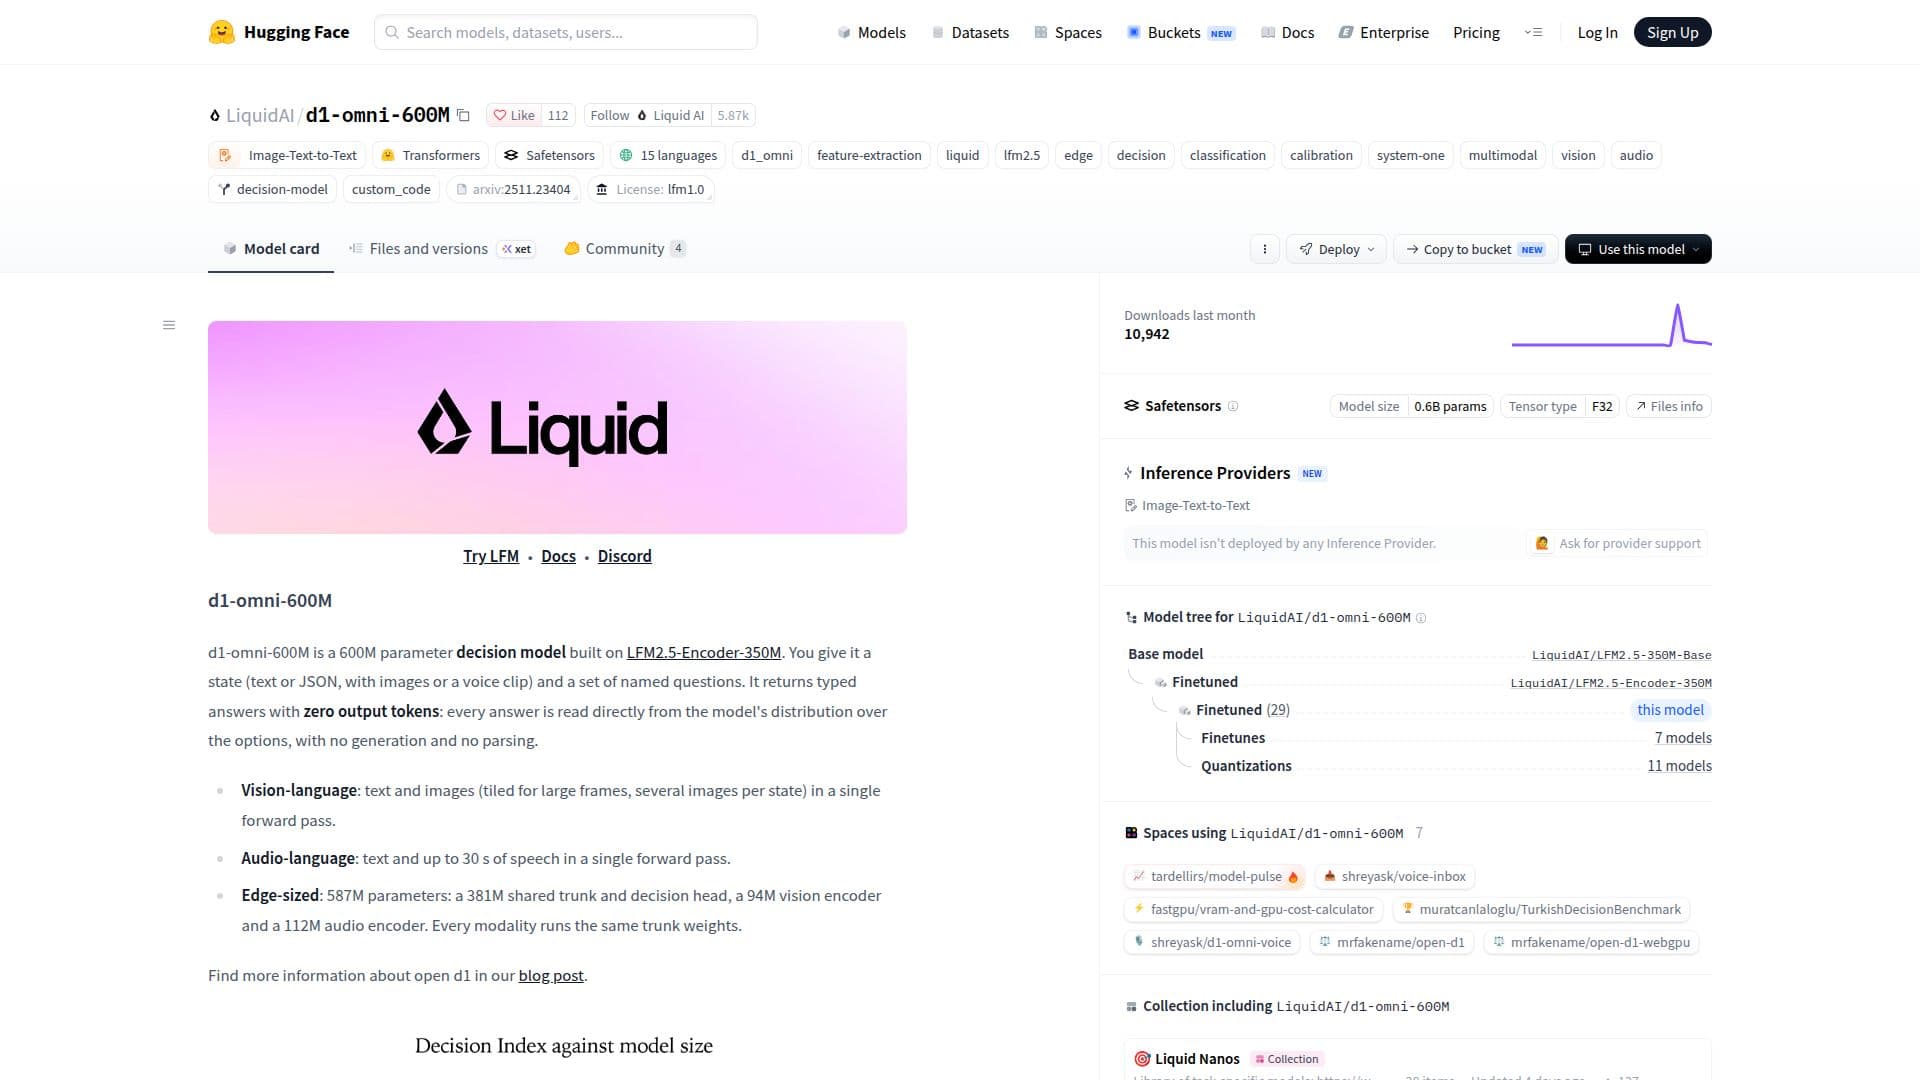
Captura de tela do LiquidAI d1-omni-600M

LiquidAI d1-omni-600M é um sofisticado modelo de decisão com 600 milhões de parâmetros, construído sobre a estrutura LFM2.5-Encoder-350M. Este modelo é projetado para lidar com entradas multimodais, incluindo texto, imagens e áudio, em uma única passagem para frente. É particularmente adequado para aplicações que requerem respostas de sim/não, seleções de opções ou classificações, como tarefas de roteamento, moderação, classificação e inspeção visual.

Ler mais

A arquitetura do modelo inclui um tronco compartilhado e uma cabeça de decisão, juntamente com codificadores especializados para visão e áudio. O codificador de visão é baseado na torre de visão SigLIP2, enquanto o codificador de áudio utiliza um FastConformer de 17 camadas. Este design garante que todas as modalidades sejam processadas usando os mesmos pesos do tronco, aumentando a eficiência e a consistência.

Uma das principais características do d1-omni-600M é sua capacidade de retornar respostas tipadas diretamente da distribuição do modelo sobre as opções, eliminando a necessidade de geração ou análise de tokens de saída. Essa capacidade é particularmente benéfica para implantações em edge, onde a velocidade e a eficiência de recursos são críticas.

O modelo suporta um comprimento de contexto de 16.384 tokens, acomodando posições de texto, imagem e áudio juntas. Quando imagens estão incluídas, o texto do estado e da pergunta é limitado a 896 tokens, conforme as especificações de treinamento. O tamanho do vocabulário do modelo é de 65.536, permitindo uma ampla gama de processamento de entradas.

As capacidades de áudio foram especificamente treinadas usando interações entre um falante de inglês e um assistente, focando na identificação de tipos de enunciados, tópicos e intenções do falante. O modelo não é projetado para aplicações de chat e não gera texto, tornando-o ideal para tarefas de tomada de decisão.

LiquidAI d1-omni-600M é um modelo de código aberto, incentivando mais pesquisas e desenvolvimento no campo da inteligência artificial. Está disponível para uso com transformers versão 5.15 ou superior e pode ser integrado em vários pipelines que requerem capacidades eficientes de tomada de decisão.

  • CategoriaModelos de IA e LLMs
  • Modelo de preçosCódigo aberto
  • ImplantaçãoNuvem
  • PlataformasWeb

  • 600M parâmetros

  • Suporte a entrada multimodal

  • Tomada de decisão em uma única passagem

  • Otimizado para implantação em edge

  • Código aberto

  • Codificadores de visão e áudio

  • Sem geração de tokens de saída

  • Comprimento de contexto de 16.384 tokens

  1. Acesse a página do modelo

  2. Autentique-se

  3. Configure o modelo

  4. Envie solicitações

  • Roteamento e Triagem
  • Moderação
  • Classificação de Intenções
  • Roteamento de Comandos de Voz
  • Inspeção Visual

Avaliações de LiquidAI d1-omni-600M

Carregando...

Ferramentas de IA populares como LiquidAI d1-omni-600M

Inkling-Small é um modelo multimodal versátil que processa entradas de texto, imagem e áudio para gerar saídas de texto. Ele apoia desenvolvedores na criação de aplicações de IA…

Modelos de IA e LLMs

Nº 27 em LLMs

Ver ferramenta

Modelo multimodal versátil que processa entradas de texto, imagem e áudio para gerar saídas de texto. Ele apoia desenvolvedores na criação de aplicações de IA…Inkling-Small é um modelo multimodal versátil que processa entradas de texto, imagem e áudio para gerar saídas de texto. Ele apoia desenvolvedores na criação de aplicações de IA…

Modelos de IA e LLMs
Nº 27 em LLMs

DeepSeek-V4-Flash-Vision-Exp é um modelo multimodal experimental da família DeepSeek-V4, que aprimora as capacidades de compreensão visual. Ele se baseia na arquitetura…

Modelos de IA e LLMs
Ver ferramenta

Modelo multimodal experimental da família DeepSeek-V4, que aprimora as capacidades de compreensão visual. Ele se baseia na arquitetura…DeepSeek-V4-Flash-Vision-Exp é um modelo multimodal experimental da família DeepSeek-V4, que aprimora as capacidades de compreensão visual. Ele se baseia na arquitetura…

Modelos de IA e LLMs
Ver o Top 50 de LLMs

Nemotron 3 Nano Omni é um modelo de raciocínio omni-modal da NVIDIA que processa imagens, vídeos, fala e texto. Oferece capacidades de IA versáteis para diversas aplicações.

Modelos de IA e LLMs

Nº 5 em LLMs

Ver ferramenta

Modelo de raciocínio omni-modal da NVIDIA que processa imagens, vídeos, fala e texto. Oferece capacidades de IA versáteis para diversas aplicações.Nemotron 3 Nano Omni é um modelo de raciocínio omni-modal da NVIDIA que processa imagens, vídeos, fala e texto. Oferece capacidades de IA versáteis para diversas aplicações.

Modelos de IA e LLMs
Nº 5 em LLMs

Step 3.7 Flash é um modelo de linguagem-visual Mixture-of-Experts esparso, projetado para cargas de trabalho de produção de alta frequência. Ele combina uma estrutura de linguagem…

Modelos de IA e LLMs
Ver ferramenta

Modelo de linguagem-visual Mixture-of-Experts esparso, projetado para cargas de trabalho de produção de alta frequência. Ele combina uma estrutura de linguagem…Step 3.7 Flash é um modelo de linguagem-visual Mixture-of-Experts esparso, projetado para cargas de trabalho de produção de alta frequência. Ele combina uma estrutura de linguagem…

Modelos de IA e LLMs
Ver o Top 50 de LLMs

Mistral Medium 3.5 é um modelo multimodal de classe fronteiriça otimizado para casos de uso agentic e de codificação. É lançado com pesos abertos sob uma licença MIT Modificada,…

Modelos de IA e LLMs

Nº 8 em LLMs

Ver ferramenta

Modelo multimodal de classe fronteiriça otimizado para casos de uso agentic e de codificação. É lançado com pesos abertos sob uma licença MIT Modificada,…Mistral Medium 3.5 é um modelo multimodal de classe fronteiriça otimizado para casos de uso agentic e de codificação. É lançado com pesos abertos sob uma licença MIT Modificada,…

Modelos de IA e LLMs
Nº 8 em LLMs

Pixtral-12B-2409 é um modelo de IA multimodal com 12 bilhões de parâmetros e um codificador de visão de 400 milhões de parâmetros, projetado para tarefas avançadas de…

Modelos de IA e LLMs
Ver ferramenta

Pixtral-12B-2409 é um modelo de IA multimodal com 12 bilhões de parâmetros e um codificador de visão de 400 milhões de parâmetros, projetado para tarefas avançadas de…

Modelos de IA e LLMs
Ver o Top 5 de Modelos de IA

Apertus 1.5 é uma família de modelos de linguagem multilíngues e multimodais projetados para suportar uma ampla gama de idiomas e contextos. Oferece acesso de código aberto e…

Modelos de IA e LLMs
Ver ferramenta

Família de modelos de linguagem multilíngues e multimodais projetados para suportar uma ampla gama de idiomas e contextos. Oferece acesso de código aberto e…Apertus 1.5 é uma família de modelos de linguagem multilíngues e multimodais projetados para suportar uma ampla gama de idiomas e contextos. Oferece acesso de código aberto e…

Modelos de IA e LLMs
Ver o Top 50 de LLMs

Youtu-Parsing-Omni

Modelos de IA

Youtu-Parsing-Omni é um modelo de parsing omni-modal versátil que converte entradas diversas, como documentos, imagens, gráficos e vídeos, em JSON estruturado. Ele se destaca em…

Modelos de IA e LLMs
Ver ferramenta

Modelos de IA

Modelo de parsing omni-modal versátil que converte entradas diversas, como documentos, imagens, gráficos e vídeos, em JSON estruturado. Ele se destaca em…Youtu-Parsing-Omni é um modelo de parsing omni-modal versátil que converte entradas diversas, como documentos, imagens, gráficos e vídeos, em JSON estruturado. Ele se destaca em…

Modelos de IA e LLMs
Ver o Top 5 de Modelos de IA
1 de 8