설명
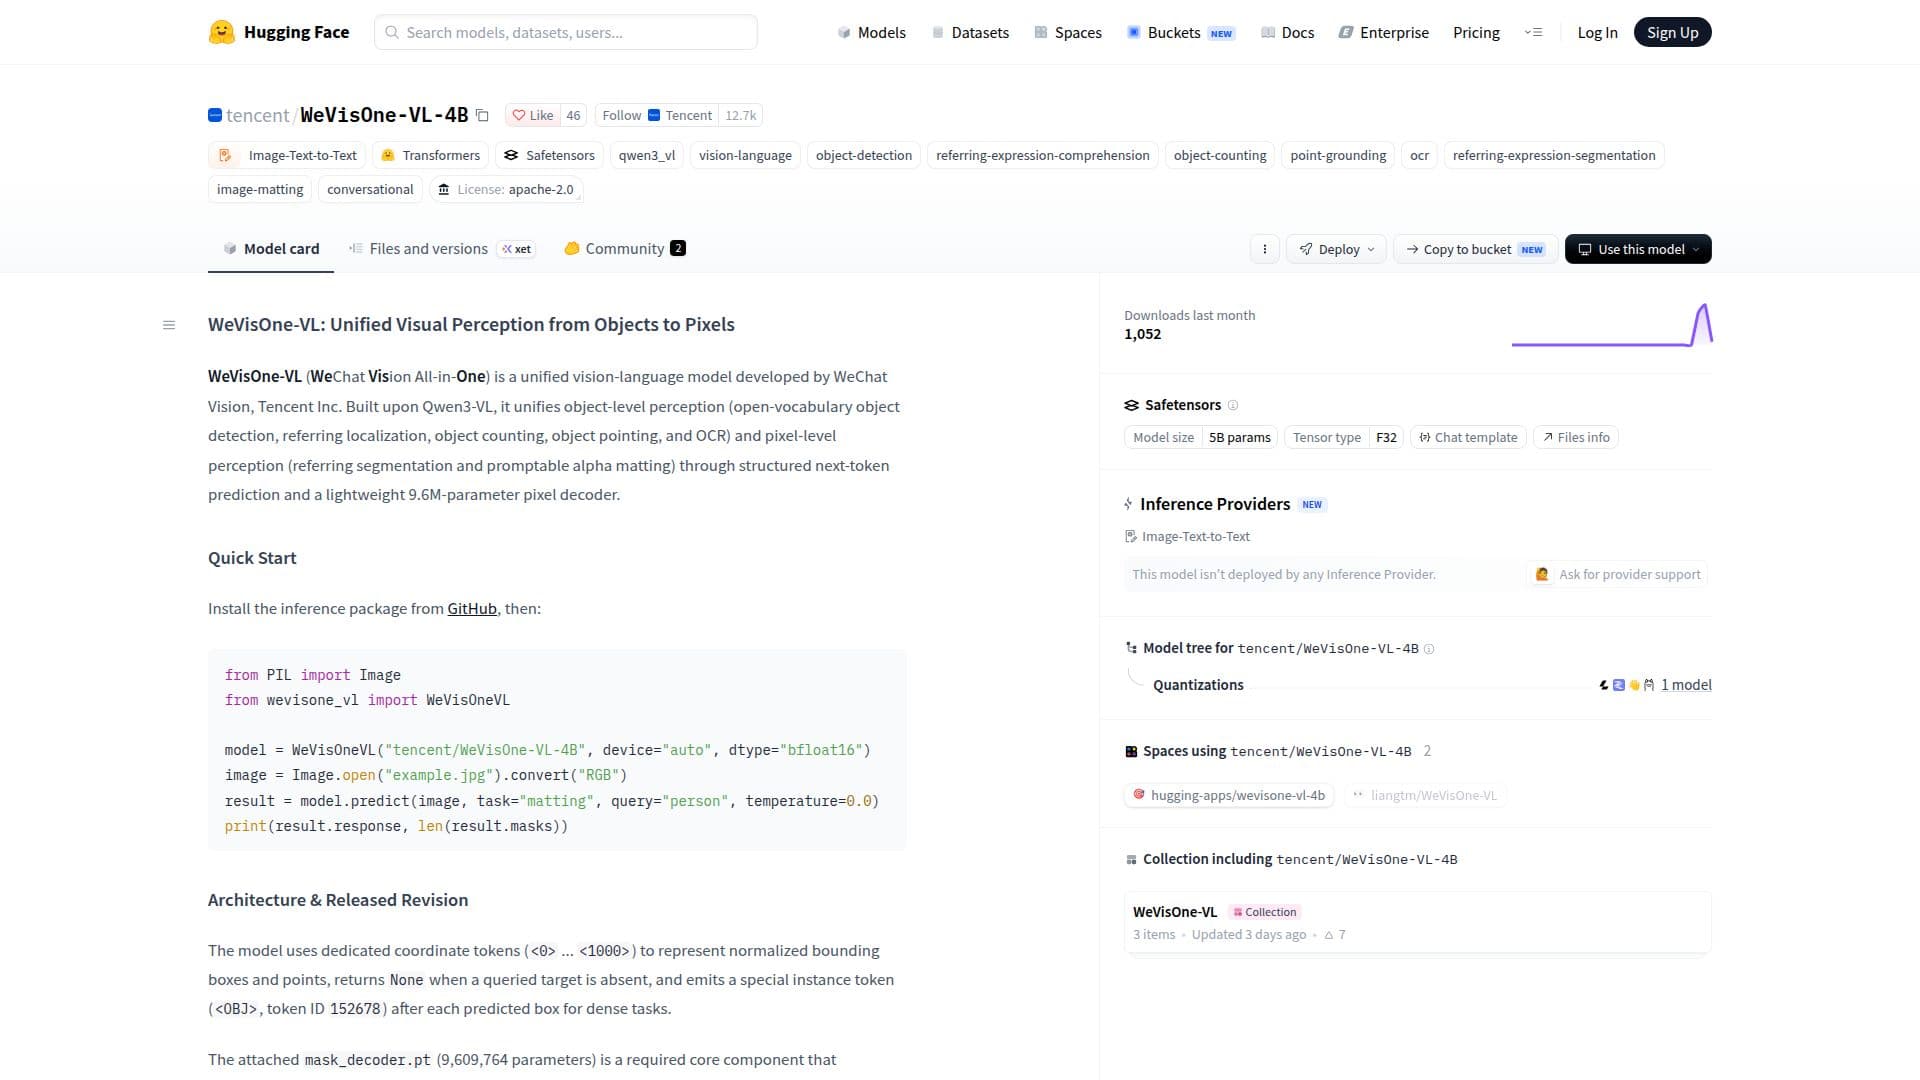
WeVisOne-VL은 Tencent Inc.의 WeChat Vision에서 개발한 비전-언어 모델입니다. 이 모델은 객체 수준과 픽셀 수준의 인식 작업을 통합하도록 설계되었습니다. Qwen3-VL 프레임워크를 기반으로 구축된 WeVisOne-VL은 개방형 어휘 객체 감지, 참조 위치 지정, 객체 수 세기, 객체 지시 및 광학 문자 인식(OCR)과 같은 다양한 시각적 작업을 지원합니다. 또한, 참조 분할 및 프롬프트 가능한 알파 매팅과 같은 픽셀 수준 작업도 처리합니다. 이 모델은 구조화된 다음 토큰 예측을 사용하며, 경량 9.6M 매개변수 픽셀 디코더를 특징으로 합니다.
더 읽기
WeVisOne-VL의 아키텍처에는 정규화된 경계 상자와 점을 나타내기 위한 전용 좌표 토큰이 포함되어 있습니다. 밀집 작업을 위해 특별한 인스턴스 토큰을 사용하며, 핵심 구성 요소로 마스크 디코더를 통합합니다. 이 디코더는 시각적 특징 어댑터, 박스 유도 쿼리 디코더 및 인스턴스 조건 밀집 예측 헤드를 결합하여 예측을 정제하고 전체 해상도 알파 매트를 출력합니다.
WeVisOne-VL은 시각적 기초, 참조 위치 지정, 지시, 수 세기, OCR 위치 지정, 참조 분할 및 이미지 매팅에 대한 연구 목적으로 사용됩니다. 자율적인 고위험 의사 결정이나 개인 식별을 위해 설계되지 않았습니다. 이 모델은 구조화된 출력을 생성하는 데 효율적이지만, 명시적인 사고의 연쇄를 지원하지 않으며 현재 단일 턴 이미지 인식으로 제한됩니다.
이 모델은 Apache License 2.0에 따라 출시되었으며, 제3자 구성 요소는 원래 라이센스를 유지합니다. 지난 한 달 동안 1,000회 이상 다운로드되어 연구 커뮤니티에서의 인기가 증가하고 있음을 나타냅니다.
- 카테고리AI 모델 및 LLM
- 요금제무료
- 배포클라우드
- 플랫폼웹
WeVisOne-VL 하이라이트
통합 비전-언어 모델
객체 수준 인식
픽셀 수준 인식
9.6M 매개변수 픽셀 디코더
구조화된 다음 토큰 예측
전용 좌표 토큰
밀집 작업을 위한 특별한 인스턴스 토큰
Apache License 2.0
WeVisOne-VL 시작하기
모델 페이지에 접근: WeVisOne-VL의 Hugging Face 페이지를 방문하세요.
인증: 모델에 접근할 수 있는 권한이 있는지 확인하세요.
구성: 연구 필요에 따라 모델 매개변수를 설정하세요.
프롬프트 전송: 처리할 시각적 작업을 입력하세요.
미세 조정: 필요에 따라 특정 작업에 맞게 모델을 조정하세요.
WeVisOne-VL의 사용 사례
- 객체 감지
- 참조 위치 지정
- 객체 수 세기
- OCR 위치 지정
- 이미지 매팅