설명
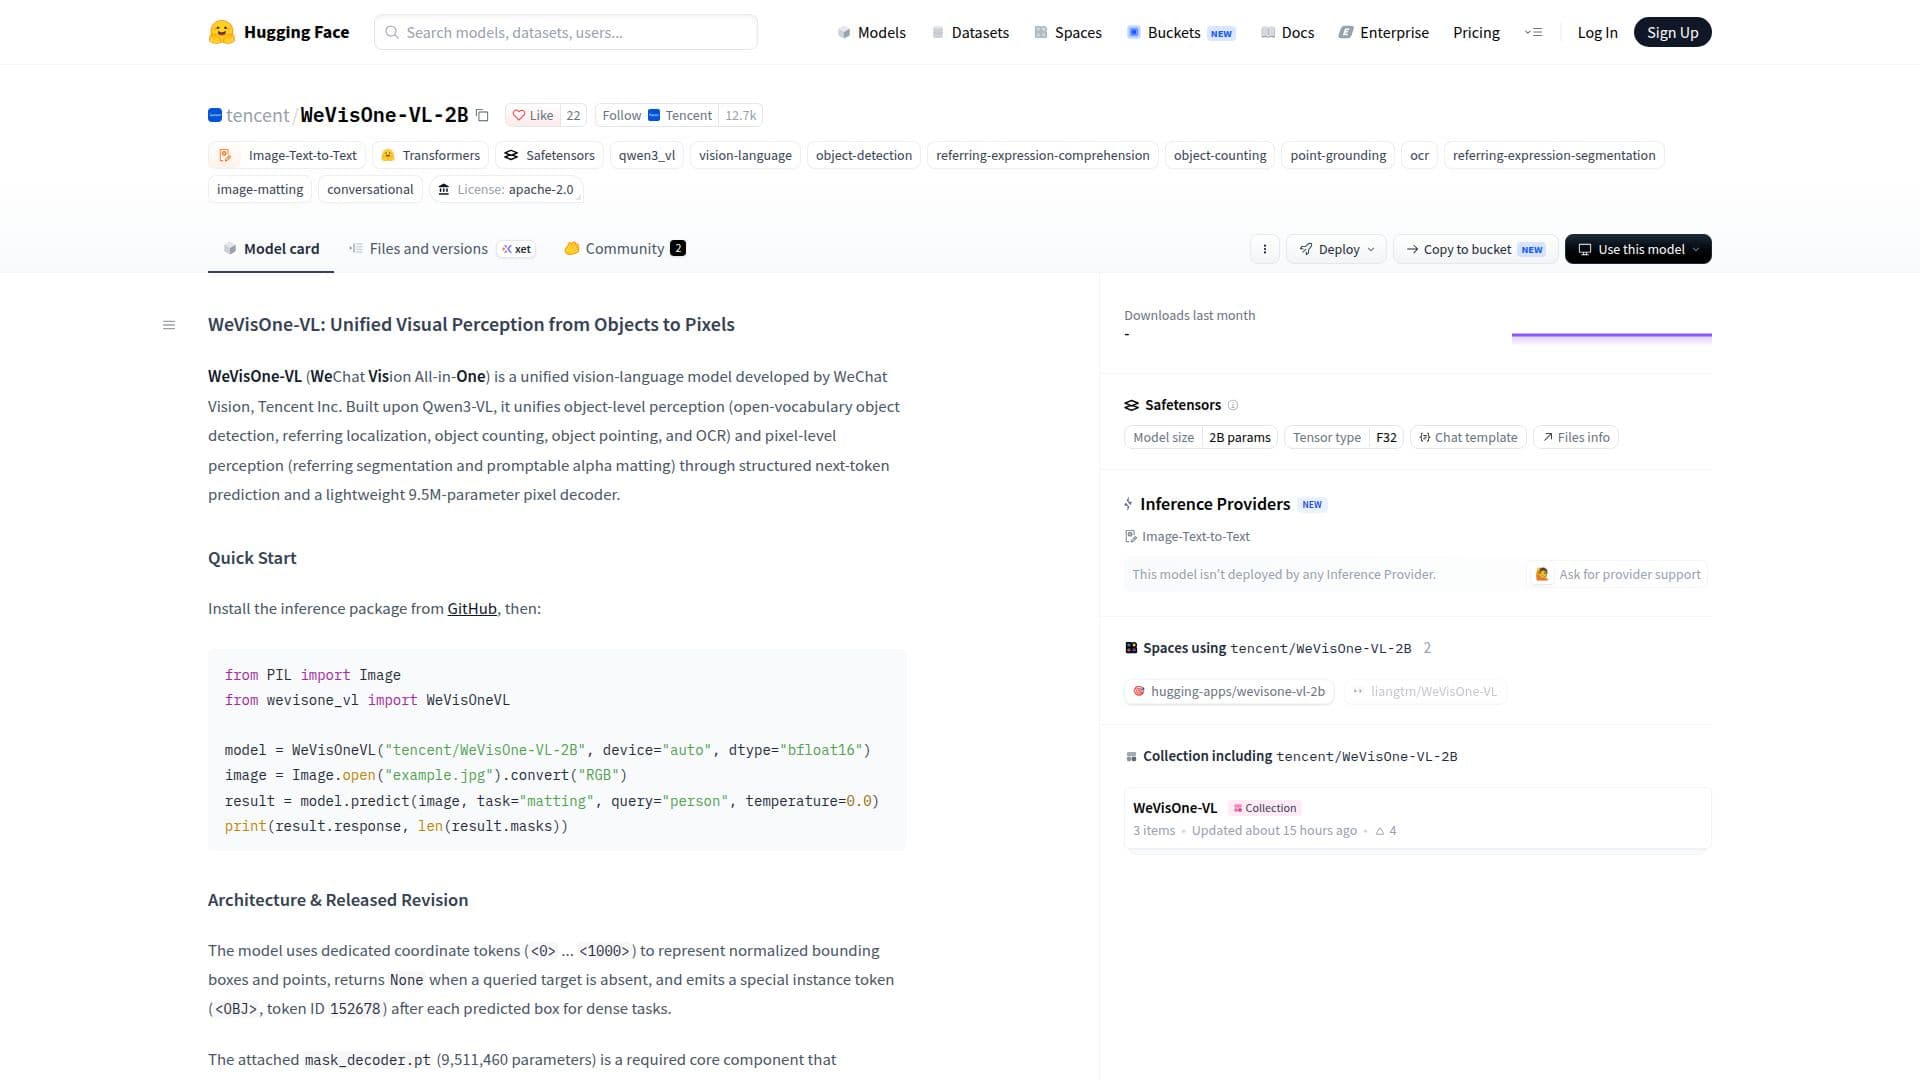
WeVisOne-VL은 Tencent Inc.의 WeChat Vision에서 개발한 정교한 비전-언어 모델입니다. 이 모델은 Qwen3-VL 프레임워크를 기반으로 구축되었으며, 객체 수준 및 픽셀 수준 인식 작업을 통합하도록 설계되었습니다. 개방 어휘 객체 감지, 참조 위치 지정, 객체 수 세기, 객체 지적 및 광학 문자 인식(OCR)을 처리할 수 있습니다. 또한, 참조 분할 및 프롬프트 가능한 알파 매팅과 같은 픽셀 수준 작업도 지원합니다.
더 읽기
이 모델은 구조화된 다음 토큰 예측을 사용하며 950만 개의 매개변수를 가진 경량 픽셀 디코더를 특징으로 합니다. WeVisOne-VL의 핵심 구성 요소는 mask_decoder.pt로, 이는 시각적 특징 어댑터, 박스 유도 쿼리 디코더 및 인스턴스 조건 밀집 예측 헤드를 통합합니다. 이러한 구성 요소는 함께 작동하여 예측을 개선하고 고해상도 알파 매트를 출력합니다.
WeVisOne-VL은 시각적 기초, 위치 지정, 지적, 수 세기, OCR, 분할 및 이미지 매팅에 대한 연구 응용 프로그램을 위해 설계되었습니다. 자율적 의사 결정이나 개인 식별을 위한 것이 아닙니다. 이 모델은 단일 턴 이미지 인식에 최적화되어 있으며 비디오 그리드를 지원하지 않습니다.
이 모델은 Apache License 2.0에 따라 출시되며, 제3자 구성 요소는 원래 라이센스를 유지합니다. 사용자는 특정 라이센스 세부정보를 검토하기 위해 소스 파일을 확인하는 것이 좋습니다.
- 카테고리컴퓨터 비전 도구
- 요금제오픈소스
- 배포클라우드
- 플랫폼웹
WeVisOne-VL 하이라이트
통합 비전-언어 모델
객체 수준 인식
픽셀 수준 인식
개방 어휘 객체 감지
참조 분할
프롬프트 가능한 알파 매팅
구조화된 다음 토큰 예측
경량 픽셀 디코더
WeVisOne-VL 시작하기
모델 페이지에 접근: Hugging Face 모델 페이지 방문
인증: Hugging Face 계정에 로그인
구성: 필요한 매개변수로 모델 설정
프롬프트 전송: 처리할 시각적 데이터 입력
미세 조정: 특정 작업에 맞게 모델 설정 조정
WeVisOne-VL의 사용 사례
- 시각적 기초
- 객체 감지
- 이미지 매팅
- OCR 위치 지정
- 참조 분할