본문으로 건너뛰기
ToolPotion
AI 어드바이저
제출 (무료)

ERNIE-5.5-Flash-Base-BF16

ERNIE-5.5-Flash-Base-BF16는 2800억 개의 총 매개변수를 가진 효율적인 희소 전문가 혼합(MoE) 언어 모델입니다. 33.5조 개의 토큰으로 사전 훈련되었으며, 100만 개 토큰의 컨텍스트로 미세 조정 및 추론을 지원합니다. 이 모델은 도메인 적응, 지침 조정 및 강화 학습 연구를 포함한 다양한 응용 프로그램을 위해 설계되었으며, 여러 벤치마크에서 강력한 성능을 제공합니다.

URL 방문
공유
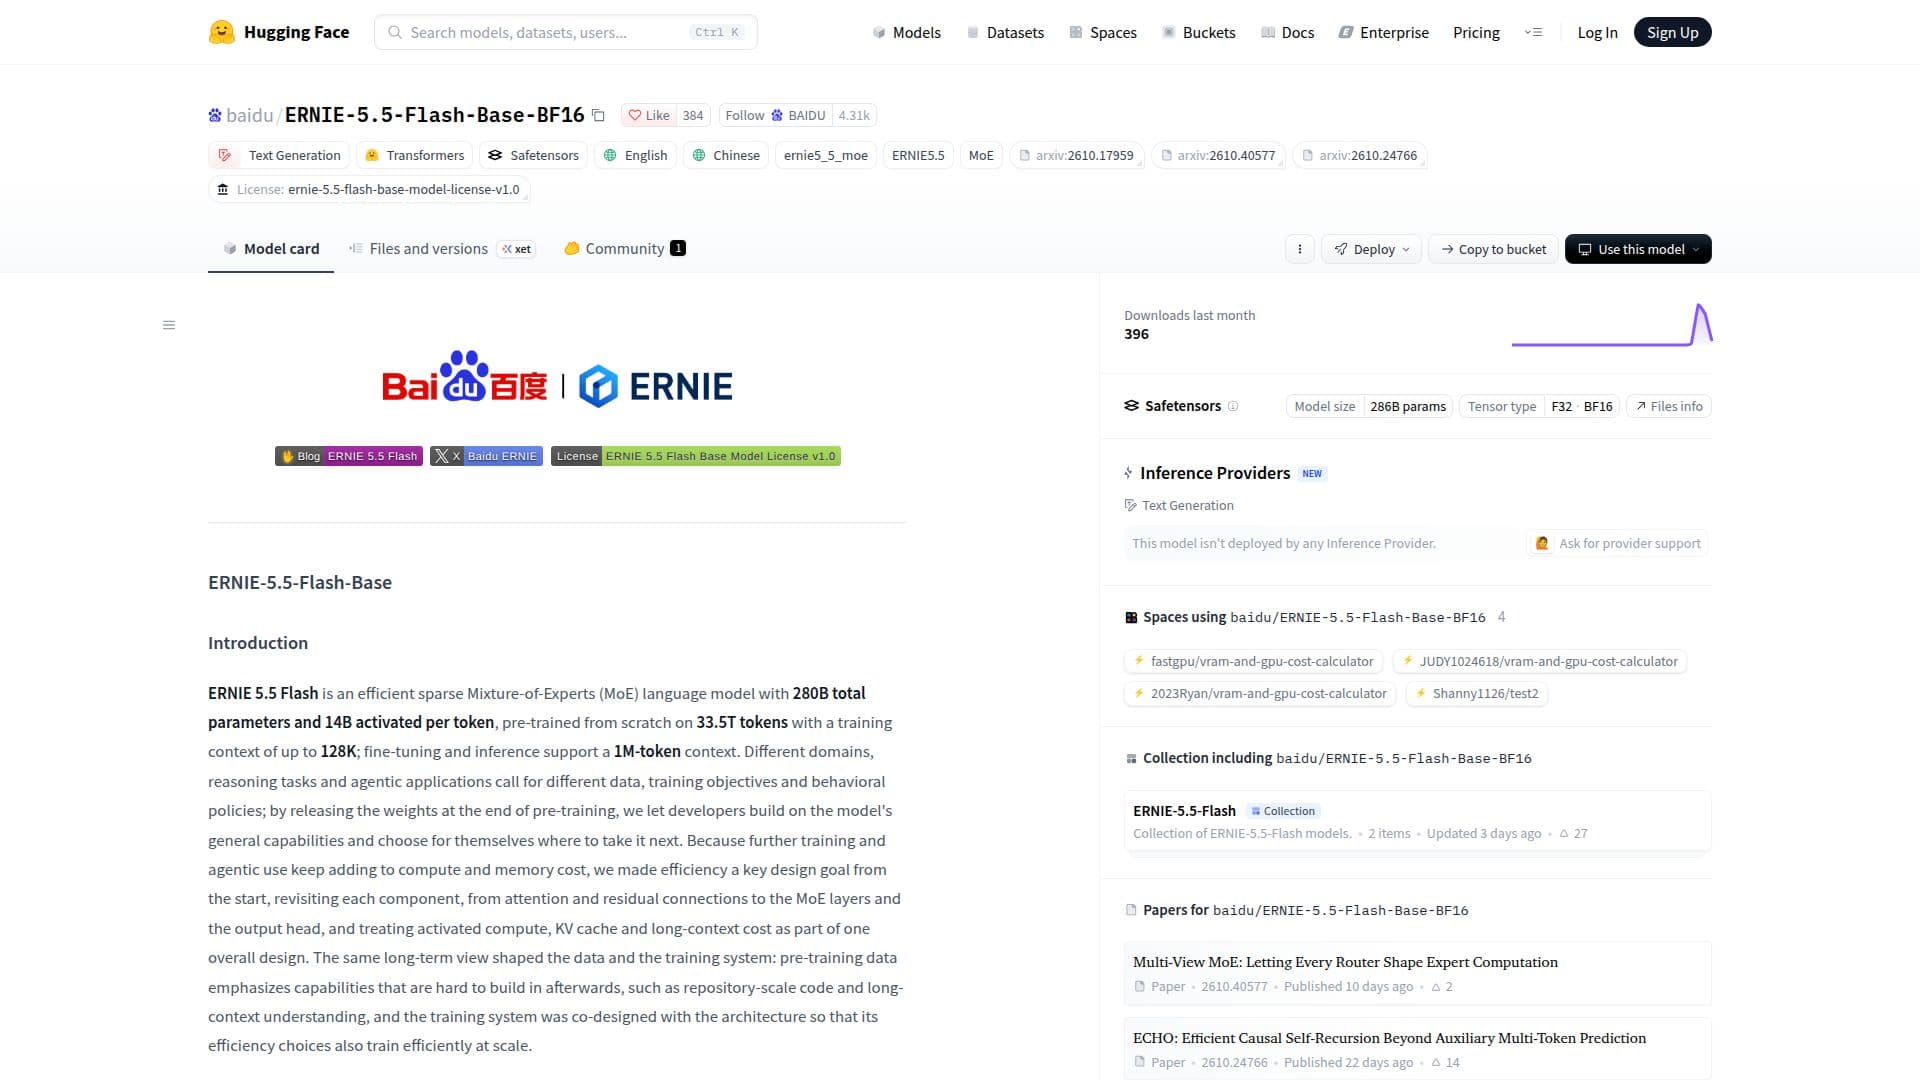
ERNIE-5.5-Flash-Base-BF16 스크린샷

ERNIE-5.5-Flash-Base-BF16는 바이두(Baidu)에서 개발한 정교한 희소 전문가 혼합(MoE) 언어 모델입니다. 2800억 개의 총 매개변수를 특징으로 하며, 토큰당 140억 개가 활성화되어 있어 복잡한 언어 작업에 매우 효율적입니다. 이 모델은 33.5조 개의 방대한 데이터셋에서 처음부터 사전 훈련되었으며, 최대 128,000개의 토큰으로 훈련 컨텍스트를 활용합니다. 미세 조정 및 추론을 위해 인상적인 100만 개 토큰의 컨텍스트 길이를 지원하여 긴 형식의 콘텐츠를 깊이 이해하고 생성할 수 있습니다.

더 읽기

효율성을 핵심 원칙으로 설계된 ERNIE 5.5 Flash는 주의 메커니즘, 잔여 연결, MoE 레이어 및 출력 헤드에 이르기까지 모든 구성 요소를 재검토합니다. 이러한 전체론적 접근 방식은 컴퓨팅, KV 캐시 및 긴 컨텍스트 비용을 관리하면서 최적의 성능을 보장합니다. 사전 훈련 데이터는 리포지토리 규모의 코드 이해 및 긴 컨텍스트 이해와 같은 고급 응용 프로그램에 중요한 기능을 강조하여 개발자가 다양한 사용 사례를 위해 일반적인 기능을 기반으로 구축할 수 있도록 합니다.

ERNIE-5.5-Flash-Base-BF16는 사전 훈련이 끝난 후의 체크포인트를 나타내며, 중간 또는 후속 훈련 단계 이전의 기본 모델로 작용합니다. 이는 도메인 적응, 지침 조정 및 강화 학습에 참여하는 연구자 및 개발자에게 이상적인 출발점을 제공합니다. 이 모델은 지식, 추론, 수학, 코드, 다국어 작업 및 긴 컨텍스트 이해와 관련된 벤치마크에서 뛰어난 성과를 보여주었습니다.

이 아키텍처는 43개의 레이어를 가진 280B-A14B 하이브리드 주의 MoE를 통합하고 있으며, 1개의 밀집 FFN과 42개의 다중 라우터 잠재 MoE 레이어를 포함합니다. 37개의 강력하게 압축된 주의(HCA) 레이어와 희소 주의를 가진 6개의 다중 헤드 잠재 주의(MLA + DSA) 레이어가 특징입니다. 이 모델은 MoE 레이어당 512개의 라우팅된 전문가(상위 10개)와 1개의 공유 전문가를 활용합니다. 저순위 게이트 주의, 가상 헤드 주의(VHA), 다중 라우터 잠재 MoE, ECHO, 다양체 제약 하이퍼 연결(mHC) 및 다중 최대 출력 헤드와 같은 혁신이 고급 기능과 효율성에 기여합니다. 토크나이저는 약 200,000개의 항목을 지원하며, 숫자를 최대 3자리씩 오른쪽에서 왼쪽으로 토큰화합니다.

배포는 SGLang 및 vLLM을 통해 지원되며, 최대 1,048,576개의 토큰 길이로 프로덕션 서비스를 제공합니다. 이 모델은 ERNIE 5.5 Flash Base Model License Agreement v1.0에 따라 제공됩니다.

  • 카테고리AI 모델 및 LLM
  • 배포클라우드
  • 플랫폼웹

  • 2800억 개의 총 매개변수

  • 토큰당 140억 개의 활성화된 매개변수

  • 33.5조 개의 토큰으로 사전 훈련됨

  • 최대 128,000개의 토큰으로 훈련 컨텍스트

  • 미세 조정 및 추론 지원 100만 개 토큰 컨텍스트

  • 효율적인 희소 전문가 혼합(MoE) 아키텍처

  • 43개의 레이어를 가진 하이브리드 주의 MoE

  • 37개의 강력하게 압축된 주의(HCA) 레이어

  • 6개의 다중 헤드 잠재 주의(MLA + DSA) 레이어

  • MoE 레이어당 512개의 라우팅된 전문가(상위 10개) 및 1개의 공유 전문가

  • 저순위 게이트 주의 및 가상 헤드 주의(VHA)

  • 정확한 전문가 선택을 위한 다중 라우터 잠재 MoE

  • 다중 지평 손실 및 추측 디코딩을 위한 ECHO

  • 신호 전파를 위한 다양체 제약 하이퍼 연결(mHC)

  • 어휘 분포를 선명하게 하는 다중 최대 출력 헤드

  • 약 200,000 항목의 BPE 토크나이저

  • 프로덕션 서비스를 위한 SGLang 및 vLLM 지원

  1. 모델 페이지 접근: Hugging Face에서 ERNIE-5.5-Flash-Base-BF16 페이지로 이동합니다.

  2. 파일 탐색: 페이지에서 제공되는 모델 파일 및 문서를 검토합니다.

  3. 모델 다운로드: ERNIE-5.5-Flash-Base-BF16 모델 체크포인트를 다운로드합니다.

  4. vLLM 및 플러그인 설치: 배포를 위해 vLLM 및 ERNIE 5.5 플러그인을 설치합니다.

  5. 서버 시작: SGLang 또는 vLLM을 사용하여 모델 서버를 시작합니다.

  6. 요청 전송: curl과 같은 도구를 사용하여 추론을 위해 완료 엔드포인트에 요청을 전송합니다.

  • 텍스트 생성
  • 도메인 적응
  • 지침 조정
  • 강화 학습 연구
  • 코드 이해
  • 긴 컨텍스트 이해
  • 다국어 응용 프로그램
  • 추론 작업
  • 에이전틱 응용 프로그램

Baidu의 제품

바이두 원신 어시스턴트의 모델입니다.

ERNIE-5.5-Flash-Base-BF16 리뷰

로딩 중...

ERNIE-5.5-Flash-Base-BF16와(과) 비슷한 인기 AI 도구

ERNIE-5.5-Flash-Base는 280B의 총 매개변수를 가진 효율적인 희소 전문가 혼합(MoE) 언어 모델로, 텍스트 생성을 위해 설계되었습니다. 33.5T 토큰으로 사전 훈련되었으며, 1M 토큰 컨텍스트로 미세 조정 및 추론을 지원합니다. 이 모델은 도메인 적응, 지침 조정 및 강화 학습 연구를 위한 강력한…

AI 모델 및 LLM
도구 보기

280B의 총 매개변수를 가진 효율적인 희소 전문가 혼합(MoE) 언어 모델로, 텍스트 생성을 위해 설계되었습니다. 33.5T 토큰으로 사전 훈련되었으며, 1M 토큰 컨텍스트로 미세 조정 및 추론을 지원합니다. 이 모델은 도메인 적응, 지침 조정 및 강화 학습 연구를 위한 강력한…ERNIE-5.5-Flash-Base는 280B의 총 매개변수를 가진 효율적인 희소 전문가 혼합(MoE) 언어 모델로, 텍스트 생성을 위해 설계되었습니다. 33.5T 토큰으로 사전 훈련되었으며, 1M 토큰 컨텍스트로 미세 조정 및 추론을 지원합니다. 이 모델은 도메인 적응, 지침 조정 및 강화 학습 연구를 위한 강력한…

AI 모델 및 LLM
LLM TOP 100 보기

DeepSeek-V4-Pro는 효율적인 백만 토큰 컨텍스트 인텔리전스를 위해 설계된 고급 AI 모델입니다. 하이브리드 주의 아키텍처를 특징으로 하며, 32조 개 이상의 토큰으로 사전 훈련되어 복잡한 추론 작업 및 코딩 벤치마크에 적합합니다.

AI 모델 및 LLM
도구 보기

효율적인 백만 토큰 컨텍스트 인텔리전스를 위해 설계된 고급 AI 모델입니다. 하이브리드 주의 아키텍처를 특징으로 하며, 32조 개 이상의 토큰으로 사전 훈련되어 복잡한 추론 작업 및 코딩 벤치마크에 적합합니다.DeepSeek-V4-Pro는 효율적인 백만 토큰 컨텍스트 인텔리전스를 위해 설계된 고급 AI 모델입니다. 하이브리드 주의 아키텍처를 특징으로 하며, 32조 개 이상의 토큰으로 사전 훈련되어 복잡한 추론 작업 및 코딩 벤치마크에 적합합니다.

추천AI 모델 및 LLM
LLM TOP 100 보기

DeepSeek-V3는 6710억 개의 매개변수를 가진 전문가 혼합 언어 모델로, 효율적인 추론과 비용 효율적인 훈련을 위해 설계되었습니다. 자연어 처리 작업에서 강력한 성능을 보여주는 다양한 벤치마크에서 우수한 성능을 발휘합니다.

AI 모델 및 LLM

LLM 42위

도구 보기

6710억 개의 매개변수를 가진 전문가 혼합 언어 모델로, 효율적인 추론과 비용 효율적인 훈련을 위해 설계되었습니다. 자연어 처리 작업에서 강력한 성능을 보여주는 다양한 벤치마크에서 우수한 성능을 발휘합니다.DeepSeek-V3는 6710억 개의 매개변수를 가진 전문가 혼합 언어 모델로, 효율적인 추론과 비용 효율적인 훈련을 위해 설계되었습니다. 자연어 처리 작업에서 강력한 성능을 보여주는 다양한 벤치마크에서 우수한 성능을 발휘합니다.

추천AI 모델 및 LLM
LLM 42위

DeepSeek-V4-Pro-DSpark는 하이브리드 주의 아키텍처와 다변량 제약 하이퍼 연결을 특징으로 하는 고급 언어 모델입니다. 이 모델은 백만 개의 토큰에 대한 컨텍스트 길이를 지원하며, 효율적인 장기 컨텍스트 처리를 위해 최적화되어 있습니다.

AI 모델 및 LLM

LLM 71위

도구 보기

하이브리드 주의 아키텍처와 다변량 제약 하이퍼 연결을 특징으로 하는 고급 언어 모델입니다. 이 모델은 백만 개의 토큰에 대한 컨텍스트 길이를 지원하며, 효율적인 장기 컨텍스트 처리를 위해 최적화되어 있습니다.DeepSeek-V4-Pro-DSpark는 하이브리드 주의 아키텍처와 다변량 제약 하이퍼 연결을 특징으로 하는 고급 언어 모델입니다. 이 모델은 백만 개의 토큰에 대한 컨텍스트 길이를 지원하며, 효율적인 장기 컨텍스트 처리를 위해 최적화되어 있습니다.

AI 모델 및 LLM
LLM 71위

AliceAI-Foundation-80B-A3B-Base는 하이브리드 아키텍처와 MoE 레이어를 갖춘 기초 언어 모델로, 800억 개의 매개변수를 특징으로 합니다. 사실적 지식 작업에서 특히 러시아어에 강점을 보이며, 최대 262,144 토큰의 컨텍스트 길이를 지원합니다.

AI 모델 및 LLM

LLM 29위

도구 보기

하이브리드 아키텍처와 MoE 레이어를 갖춘 기초 언어 모델로, 800억 개의 매개변수를 특징으로 합니다. 사실적 지식 작업에서 특히 러시아어에 강점을 보이며, 최대 262,144 토큰의 컨텍스트 길이를 지원합니다.AliceAI-Foundation-80B-A3B-Base는 하이브리드 아키텍처와 MoE 레이어를 갖춘 기초 언어 모델로, 800억 개의 매개변수를 특징으로 합니다. 사실적 지식 작업에서 특히 러시아어에 강점을 보이며, 최대 262,144 토큰의 컨텍스트 길이를 지원합니다.

AI 모델 및 LLM
LLM 29위

Ling-3.0-flash는 효율성과 성능을 위해 설계된 차세대 하이브리드 추론 모델입니다. 1240억 개의 매개변수를 갖춘 이 모델은 추론, 지시 따르기 및 긴 맥락 이해에서 뛰어난 성능을 발휘하여 복잡한 작업 흐름에 적합합니다.

AI 모델 및 LLM

LLM 65위

도구 보기

효율성과 성능을 위해 설계된 차세대 하이브리드 추론 모델입니다. 1240억 개의 매개변수를 갖춘 이 모델은 추론, 지시 따르기 및 긴 맥락 이해에서 뛰어난 성능을 발휘하여 복잡한 작업 흐름에 적합합니다.Ling-3.0-flash는 효율성과 성능을 위해 설계된 차세대 하이브리드 추론 모델입니다. 1240억 개의 매개변수를 갖춘 이 모델은 추론, 지시 따르기 및 긴 맥락 이해에서 뛰어난 성능을 발휘하여 복잡한 작업 흐름에 적합합니다.

AI 모델 및 LLM
LLM 65위

DeepSeek-V3

AI GitHub 저장소

DeepSeek-V3는 DeepSeek에서 제공하는 오픈 가중치 Mixture-of-Experts 언어 모델로, 총 6710억 개의 매개변수와 토큰당 370억 개의 활성화된 매개변수를 가지고 있습니다. 14.8조 개의 토큰으로 사전 훈련되었으며, 128K의 컨텍스트 길이를 지원합니다. GitHub와 Hugging…

AI 모델 및 LLM
도구 보기

AI GitHub 저장소

DeepSeek에서 제공하는 오픈 가중치 Mixture-of-Experts 언어 모델로, 총 6710억 개의 매개변수와 토큰당 370억 개의 활성화된 매개변수를 가지고 있습니다. 14.8조 개의 토큰으로 사전 훈련되었으며, 128K의 컨텍스트 길이를 지원합니다. GitHub와 Hugging…DeepSeek-V3는 DeepSeek에서 제공하는 오픈 가중치 Mixture-of-Experts 언어 모델로, 총 6710억 개의 매개변수와 토큰당 370억 개의 활성화된 매개변수를 가지고 있습니다. 14.8조 개의 토큰으로 사전 훈련되었으며, 128K의 컨텍스트 길이를 지원합니다. GitHub와 Hugging…

AI 모델 및 LLM
AI GitHub 저장소 TOP 250 보기

Kimi-K2-Instruct는 고급 AI 작업을 위해 설계된 최첨단 전문가 혼합 언어 모델입니다. 이 모델은 추론, 코딩 및 도구 사용에서 뛰어난 성능을 제공하며, 320억 개의 활성화된 매개변수를 갖추고 있습니다.

AI 모델 및 LLM

LLM 51위

도구 보기

고급 AI 작업을 위해 설계된 최첨단 전문가 혼합 언어 모델입니다. 이 모델은 추론, 코딩 및 도구 사용에서 뛰어난 성능을 제공하며, 320억 개의 활성화된 매개변수를 갖추고 있습니다.Kimi-K2-Instruct는 고급 AI 작업을 위해 설계된 최첨단 전문가 혼합 언어 모델입니다. 이 모델은 추론, 코딩 및 도구 사용에서 뛰어난 성능을 제공하며, 320억 개의 활성화된 매개변수를 갖추고 있습니다.

AI 모델 및 LLM
LLM 51위
1/8