설명
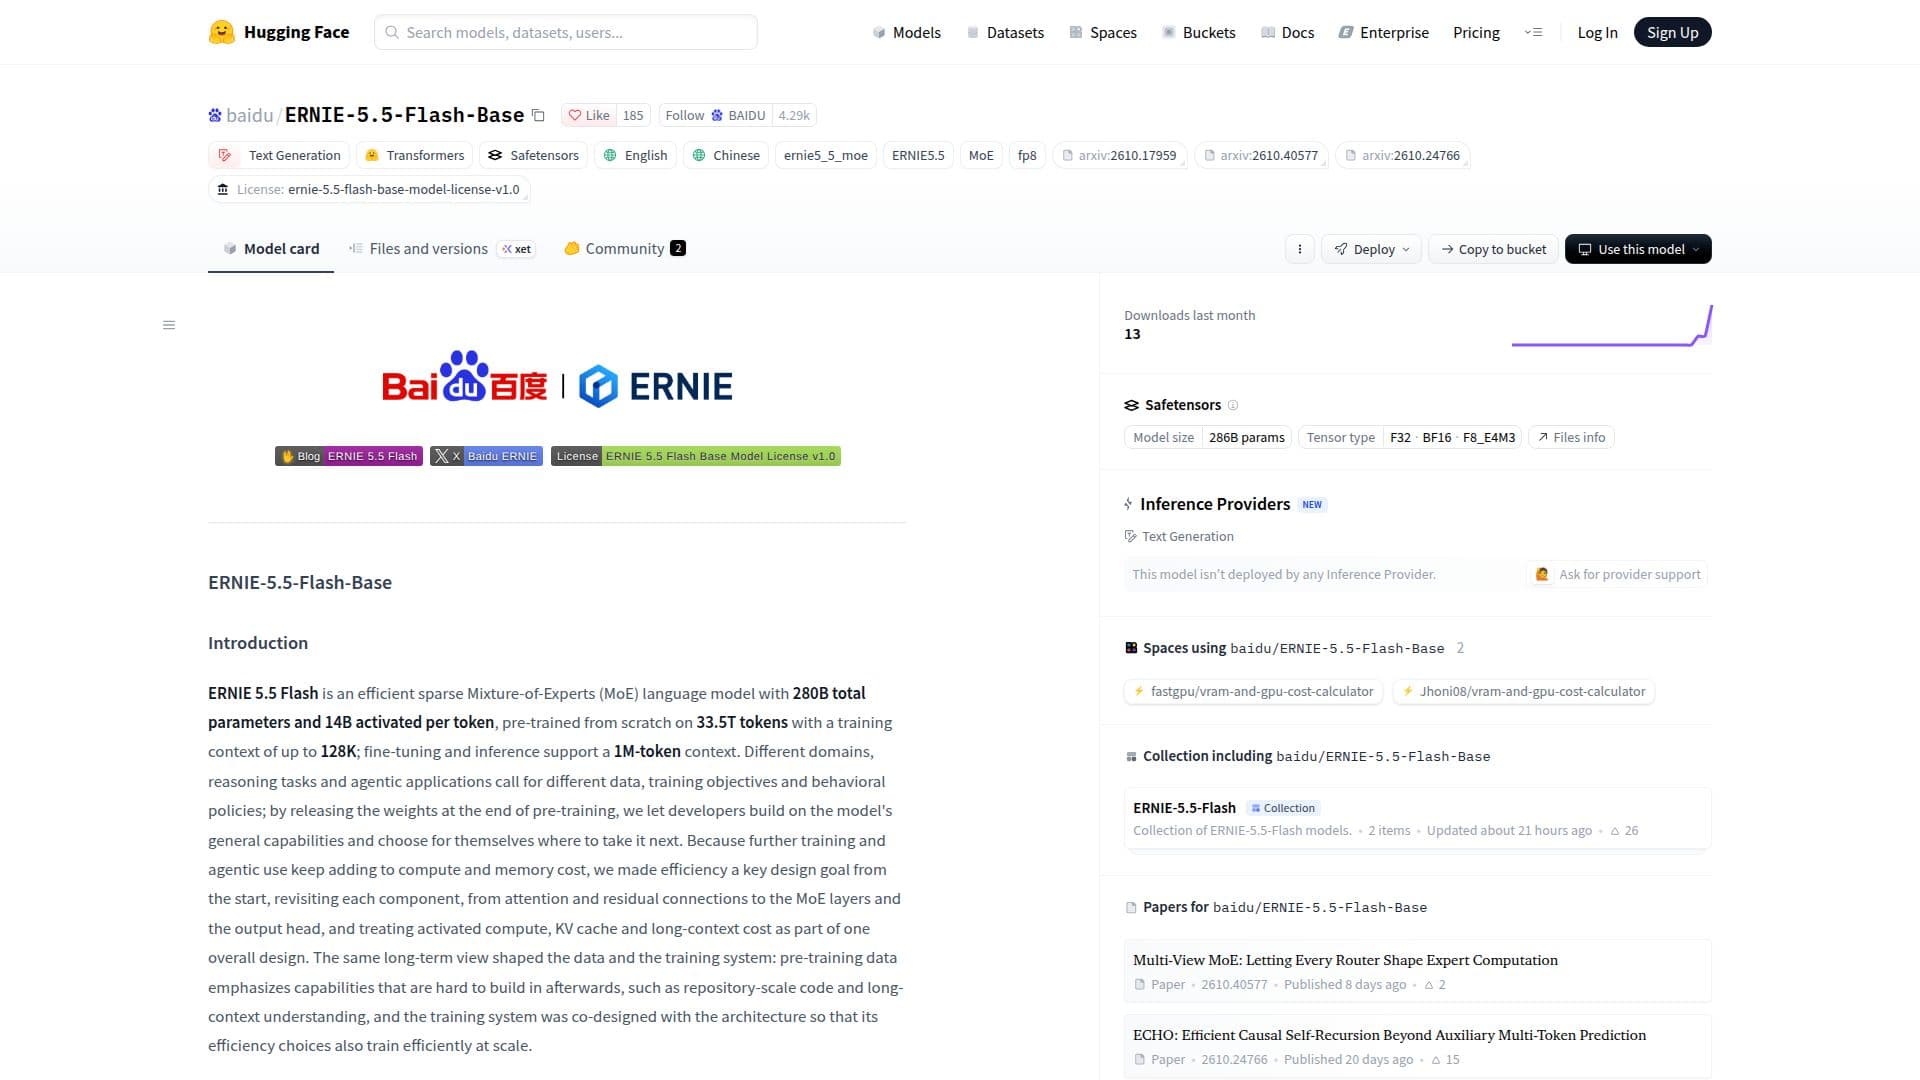
ERNIE-5.5-Flash-Base는 Baidu에서 개발한 정교한 텍스트 생성 모델로, Hugging Face에서 사용할 수 있습니다. 이는 2800억 개의 총 매개변수를 가진 효율적인 희소 전문가 혼합(MoE) 언어 모델로, 토큰당 140억 개가 활성화됩니다. 이 모델은 33.5조 개의 방대한 데이터셋에서 처음부터 사전 훈련되었으며, 최대 128K의 훈련 컨텍스트를 활용합니다. 미세 조정 및 추론을 위해 인상적인 1M 토큰 컨텍스트 길이를 지원합니다.
더 읽기
효율성을 핵심 목표로 설계된 ERNIE 5.5 Flash는 주의 메커니즘, 잔여 연결, MoE 레이어 및 출력 헤드에 이르기까지 모든 구성 요소를 재검토합니다. 이 전체적인 접근 방식은 활성화된 계산, KV 캐시 및 긴 컨텍스트 비용을 통합 설계의 일부로 고려합니다. 사전 훈련 데이터는 훈련 후 구축하기 어려운 기능, 예를 들어 저장소 규모의 코드 이해 및 긴 컨텍스트 이해를 강조합니다. 훈련 시스템은 효율적인 확장을 보장하기 위해 아키텍처와 함께 공동 설계되었습니다.
ERNIE-5.5-Flash-Base는 사전 훈련이 끝난 후의 체크포인트를 나타내며, 개발자에게 이상적인 기초를 제공합니다. 이는 도메인 적응, 지침 조정 및 강화 학습 연구를 가능하게 합니다. 이 모델은 지식, 추론, 수학, 코드, 다국어 작업 및 긴 컨텍스트 벤치마크를 포함한 통합 평가 파이프라인에서 강력한 결과를 보여줍니다. 그 성능은 DeepSeek-V4-Flash-Base, Hy3-preview-Base 및 MiMo-V2.5-Base와 같은 다른 대형 모델과 비교되며, 모두 일관된 조건에서 평가됩니다.
아키텍처는 43개의 레이어를 포함하는 280B-A14B 하이브리드 주의 MoE를 통합하고 있으며, 1개의 밀집 FFN과 42개의 다중 라우터 잠재 MoE 레이어가 포함되어 있습니다. 37개의 강력하게 압축된 주의(HCA) 레이어와 희소 주의(MLA + DSA)를 가진 6개의 다중 헤드 잠재 주의 레이어가 특징입니다. 이 모델은 MoE 레이어당 512개의 라우팅된 전문가(상위 10개)와 1개의 공유 전문가를 활용합니다. 주요 혁신에는 레이어별 헤드 차원을 가진 하이브리드 MLA + HCA 주의, 저순위 게이트 주의, 가상 헤드 주의(VHA), 다중 라우터 잠재 MoE, 미래 토큰 예측을 위한 ECHO, 신호 전파를 위한 다양체 제약 하이퍼 연결(mHC), 그리고 다중 최대 출력 헤드가 포함됩니다. 토크나이저는 약 200K 항목의 BPE 토크나이저를 사용하여 숫자를 오른쪽에서 왼쪽으로 최대 3자리 그룹으로 토큰화합니다.
ERNIE-5.5-Flash-Base의 배포는 SGLang 및 vLLM로 지원되며, 긴 컨텍스트 추론을 위해 최대 1,048,576 토큰의 컨텍스트 길이로 프로덕션 서비스를 가능하게 합니다. 이 모델은 ERNIE 5.5 Flash Base 모델 라이선스 계약 v1.0에 따라 제공되며, 저작권은 Baidu에 있습니다.
- 카테고리AI 모델 및 LLM
- 요금제오픈소스
- 배포클라우드
- 플랫폼웹
ERNIE-5.5-Flash-Base 하이라이트
280B의 총 매개변수와 토큰당 14B 활성화
33.5T 토큰으로 사전 훈련됨
미세 조정 및 추론을 위한 1M 토큰 컨텍스트 지원
효율적인 희소 전문가 혼합(MoE) 아키텍처
레이어별 헤드 차원을 가진 하이브리드 MLA + HCA 주의
저순위 게이트 주의 및 가상 헤드 주의(VHA)
512개의 라우팅된 전문가와 1개의 공유 전문가를 가진 다중 라우터 잠재 MoE
다중 수평 손실 및 추측 디코딩을 위한 ECHO
신호 전파를 위한 다양체 제약 하이퍼 연결(mHC)
세분화된 어휘 분포를 위한 다중 최대 출력 헤드
오른쪽에서 왼쪽으로 숫자 토큰화를 지원하는 약 200K 항목의 BPE 토크나이저
SGLang 및 vLLM로 배포 지원
지식, 추론, 수학, 코드, 다국어 및 긴 컨텍스트 벤치마크에서 강력한 성능
FP8 및 BF16 정밀도 가중치 사용 가능
ERNIE-5.5-Flash-Base 시작하기
모델 접근: Hugging Face의 ERNIE-5.5-Flash-Base 페이지로 이동합니다.
모델 다운로드: FP8(safetensors) 또는 BF16(safetensors) 정밀도 중에서 선택하여 다운로드합니다.
배포 도구 설치: vLLM 및 ERNIE 5.5 플러그인을 설치하거나 공식 SGLang 사전 구축된 Docker 이미지를 사용합니다.
서버 시작: vLLM 또는 SGLang 서버를 시작하여 모델을 호스팅합니다.
요청 전송: curl 또는 기타 API 클라이언트를 사용하여 텍스트 생성을 위한 완성 엔드포인트에 요청을 전송합니다.
모델 미세 조정: 사전 훈련된 체크포인트를 활용하여 도메인 적응, 지침 조정 또는 강화 학습 연구를 수행합니다.
ERNIE-5.5-Flash-Base의 사용 사례
- 텍스트 생성
- 도메인 적응
- 지침 조정
- 강화 학습 연구
- 코드 생성 및 이해
- 긴 컨텍스트 이해
- 다국어 애플리케이션
- 추론 작업