본문으로 건너뛰기
ToolPotion
AI 어드바이저
제출 (무료)

d1-2B

LLMAI 모델 및 LLM오픈소스 · 웹

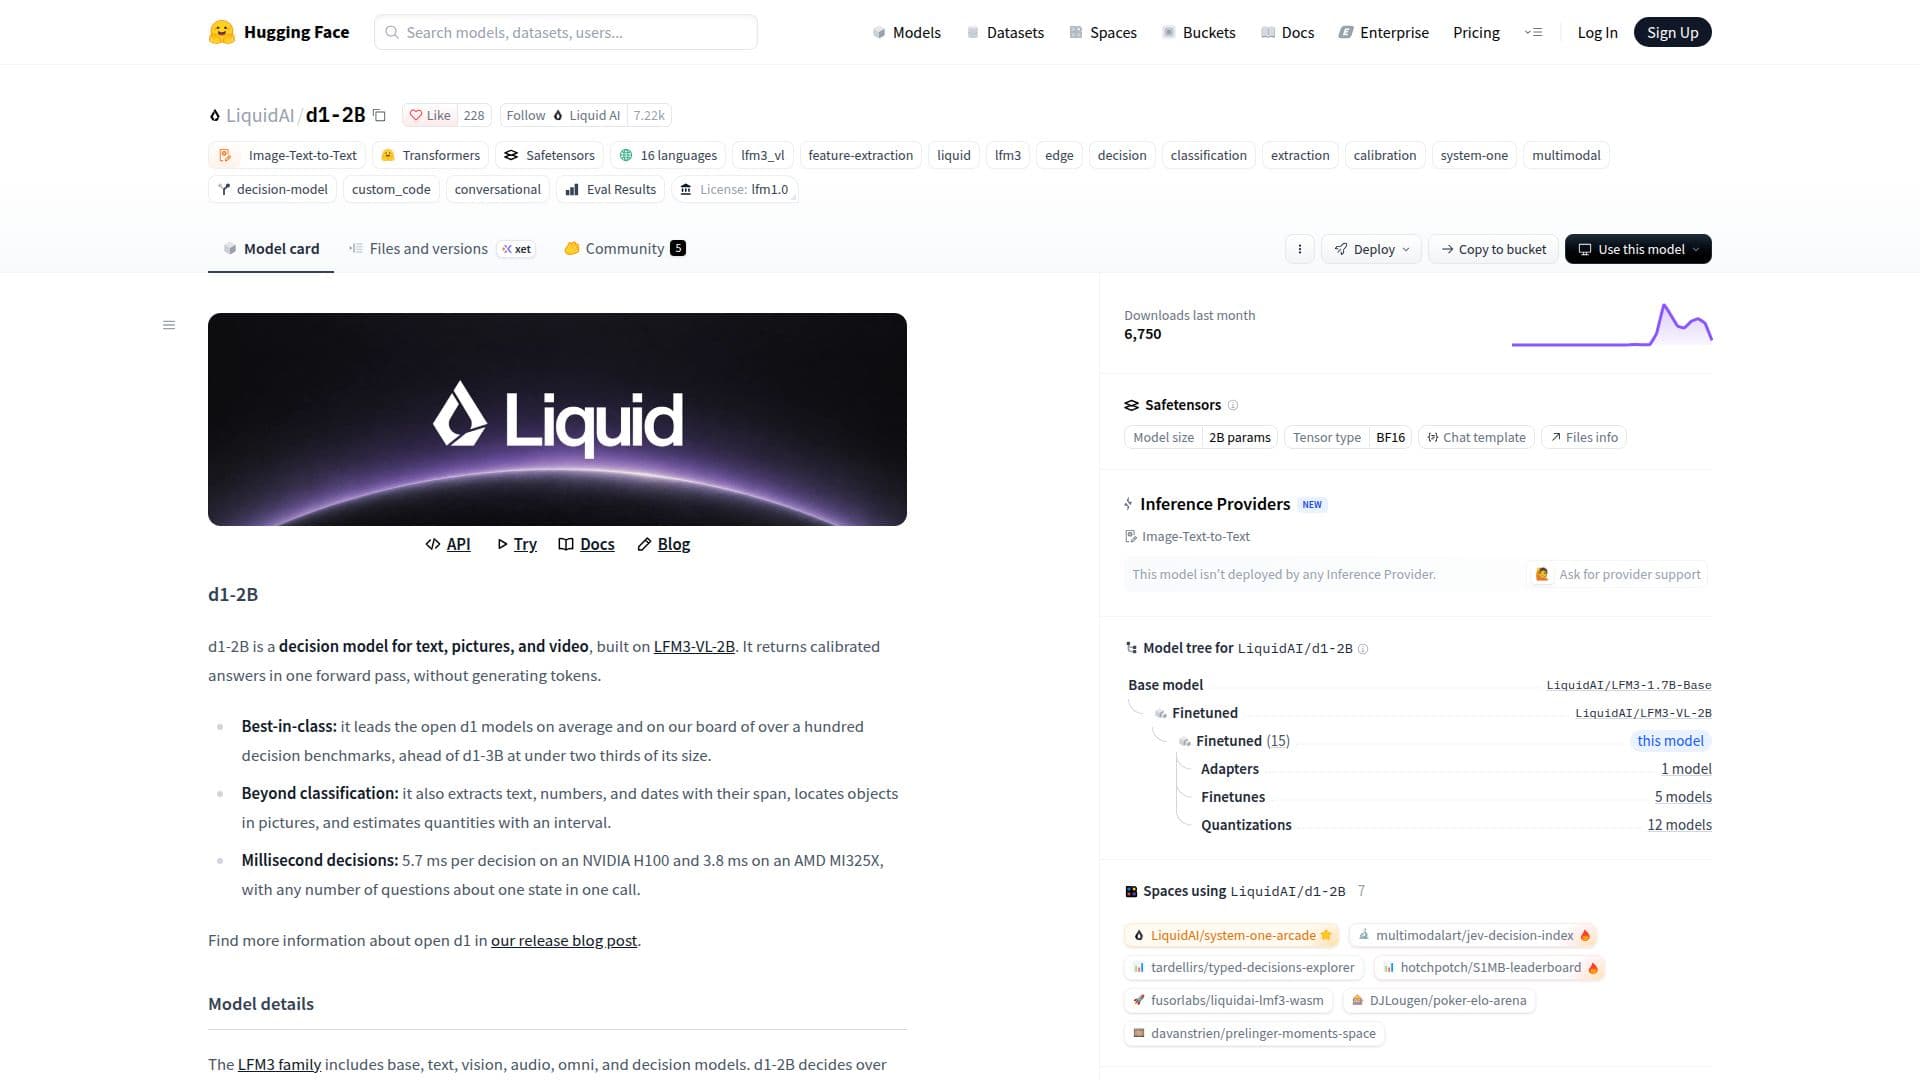
d1-2B는 텍스트, 이미지 및 비디오 분석을 위해 설계된 LFM3-VL-2B 기반의 의사 결정 모델입니다. 이 모델은 토큰 생성을 하지 않고 단일 전방 패스를 통해 보정된 답변을 제공합니다. d1-2B는 다양한 의사 결정 벤치마크에서 뛰어난 성능을 발휘하며, 분류를 넘어 텍스트 추출, 객체 위치 지정 및 수량 추정 등의 기능을 제공합니다. 다양한 응용 프로그램에서 신속한 의사 결정을 위해 최적화되어 있습니다.

URL 방문
공유
d1-2B 스크린샷
d1-2B 스크린샷

d1-2B는 LiquidAI에 의해 개발된 매우 효율적인 의사 결정 모델로, Hugging Face에서 사용할 수 있습니다. LFM3-VL-2B 아키텍처를 기반으로 구축된 이 모델은 텍스트, 이미지 및 비디오를 포함한 다중 모드 입력을 처리하고 의사 결정을 내리도록 설계되었습니다. d1-2B의 주요 특징은 토큰 생성을 필요로 하지 않고 단일 전방 패스를 통해 보정된 답변을 반환할 수 있는 능력으로, 이는 속도와 효율성에 기여합니다.

더 읽기

이 모델은 오픈 d1 모델 중에서 최고의 성능을 보여주며, 백 개 이상의 의사 결정 벤치마크에서 평균적으로 선두를 달리고 있습니다. d1-3B보다 크기는 작지만, 종종 더 나은 성능을 보여주며 최적화된 설계를 자랑합니다. 전통적인 분류 작업을 넘어 d1-2B는 특정 텍스트, 숫자 및 날짜를 그 범위와 함께 추출하고, 이미지 내에서 객체를 정확히 위치시키며, 정의된 간격으로 수량을 추정하는 고급 기능을 제공합니다.

성능은 중요한 장점으로, d1-2B는 NVIDIA H100에서 5.7 밀리초, AMD MI325X에서 3.8 밀리초의 의사 결정 시간을 기록합니다. 이 빠른 처리 속도는 단일 호출에서 하나의 상태에 대한 여러 질문이 있을 때도 유지됩니다. d1-2B를 포함한 LFM3 계열은 기본, 텍스트, 비전, 오디오, 옴니 및 의사 결정 모델을 특징으로 합니다. d1-2B는 텍스트, 이미지 및 비디오를 처리하는 반면, 그 형제 모델인 d1-Omni-2B는 오디오 기능을 포함합니다.

1.92억 개의 매개변수와 24개의 레이어(13개의 게이트가 있는 짧은 합성곱, 5개의 슬라이딩 윈도우 주의, 6개의 전역 주의)로 구성된 LFM3 백본 아키텍처를 갖춘 d1-2B는 128K 토큰의 컨텍스트 길이와 128,000 토큰의 어휘를 지원합니다. 이 모델은 상태(텍스트 또는 JSON), 이미지 또는 비디오와 함께 이름이 지정된 질문을 제공받아, 토큰을 생성하지 않고 확률과 함께 유형화된 답변을 생성합니다. 영어, 아랍어, 중국어, 프랑스어, 독일어, 이탈리아어, 일본어, 한국어, 포르투갈어, 스페인어, 베트남어, 태국어, 인도네시아어, 힌디어, 러시아어 및 폴란드어를 포함한 다양한 언어를 지원합니다.

d1-2B는 라우팅 및 분류, 콘텐츠 조정, 의도 및 주제 분류, 문서에서 데이터 추출, 평가 및 재순위 지정, 시각적 검사와 같은 의사 결정을 요구하는 다양한 파이프라인 단계에 적합합니다. 이 모델은 명시적으로 채팅 모델이 아님을 주의해야 합니다. 지식이 많은 질문에 효과적이지만, 64K 토큰을 초과하는 상태에서는 신뢰성이 감소할 수 있습니다. 수량 및 점수에 대한 추정은 신뢰할 수 있지만, 자유로운 수량에 대해서는 덜 신뢰할 수 있습니다. 이 모델은 자체 코드로 Transformers에서 실행되며 샘플링 매개변수를 필요로 하지 않습니다.

  • 카테고리AI 모델 및 LLM
  • 요금제오픈소스
  • 배포클라우드
  • 플랫폼웹

  • 다중 모드 의사 결정 모델 (텍스트, 이미지, 비디오)

  • 20억 개의 매개변수

  • 보정된 답변을 위한 단일 전방 패스

  • 토큰 생성 없음

  • 최고 수준의 의사 결정 벤치마크 성능

  • 텍스트, 숫자 및 날짜 추출

  • 이미지 내 객체 위치 지정

  • 간격을 통한 수량 추정

  • 밀리초 단위의 의사 결정 속도 (예: AMD MI325X에서 3.8 ms)

  • LFM3 백본 아키텍처

  • 128K 토큰 컨텍스트 길이

  • 128,000 토큰 어휘

  • 다국어 지원 (15개 이상의 언어)

  • 라우팅, 분류, 조정 및 추출을 위한 설계

  • 커스텀 모델 코드로 Transformers에서 실행

  1. 모델 페이지 접근: Hugging Face에서 LiquidAI/d1-2B 모델 페이지로 이동합니다.

  2. 파일 탐색: 제공된 모델 세부정보, 아키텍처 및 사양을 검토합니다.

  3. 추론 구성: Transformers 라이브러리를 사용하여 모델을 추론을 위해 설정합니다.

  4. 입력 준비: 상태(텍스트 또는 JSON), 이미지 또는 비디오와 함께 이름이 지정된 질문을 제공합니다.

  5. 호출 실행: 단일 요청에는 `system_one`을 사용하고, 배치 요청에는 `system_one_batch`를 사용합니다.

  6. 출력 해석: 생성된 토큰 없이 확률과 함께 유형화된 답변을 받습니다.

  • 라우팅 및 분류
  • 조정 및 가드레일
  • 의도 분류
  • 주제 분류
  • 문서에서의 추출
  • 평가 및 재순위 지정
  • 시각적 검사
  • 다중 모드 의사 결정

d1-2B 리뷰

로딩 중...

d1-2B와(과) 비슷한 인기 AI 도구

LiquidAI d1-omni-600M은 텍스트, 이미지 및 음성에 대한 단일 패스 결정을 위해 설계된 600M 매개변수 결정 모델입니다. 이 모델은 멀티모달 입력을 효율적으로 처리하여 출력 토큰을 생성하지 않고도 빠르고 정확한 응답을 제공합니다.

AI 모델 및 LLM
도구 보기

텍스트, 이미지 및 음성에 대한 단일 패스 결정을 위해 설계된 600M 매개변수 결정 모델입니다. 이 모델은 멀티모달 입력을 효율적으로 처리하여 출력 토큰을 생성하지 않고도 빠르고 정확한 응답을 제공합니다.LiquidAI d1-omni-600M은 텍스트, 이미지 및 음성에 대한 단일 패스 결정을 위해 설계된 600M 매개변수 결정 모델입니다. 이 모델은 멀티모달 입력을 효율적으로 처리하여 출력 토큰을 생성하지 않고도 빠르고 정확한 응답을 제공합니다.

AI 모델 및 LLM
LLM TOP 50 보기

LiquidAI d1-Omni-2B는 텍스트, 이미지 및 오디오를 처리하기 위해 설계된 의사결정 모델입니다. 토큰을 생성하지 않고 신속하게 조정된 답변을 제공하여 통화 라우팅 및 소리 이벤트 감지와 같은 애플리케이션에 적합합니다.

AI 모델 및 LLM
도구 보기

텍스트, 이미지 및 오디오를 처리하기 위해 설계된 의사결정 모델입니다. 토큰을 생성하지 않고 신속하게 조정된 답변을 제공하여 통화 라우팅 및 소리 이벤트 감지와 같은 애플리케이션에 적합합니다.LiquidAI d1-Omni-2B는 텍스트, 이미지 및 오디오를 처리하기 위해 설계된 의사결정 모델입니다. 토큰을 생성하지 않고 신속하게 조정된 답변을 제공하여 통화 라우팅 및 소리 이벤트 감지와 같은 애플리케이션에 적합합니다.

AI 모델 및 LLM
AI 모델 TOP 5 보기

d3-ultra

AI 모델

d3-ultra는 vLLM Semantic Router의 27B 다중 모달 결정 모델입니다. 텍스트, JSON, 이미지 및 비디오를 처리하여 확률로 질문에 답변합니다. 복잡한 의사 결정 작업에 적합하며, 질문당 최대 131,072 토큰을 지원하고 테스트를 위한 무료 API를 제공합니다.

AI 모델 및 LLM
도구 보기

AI 모델

vLLM Semantic Router의 27B 다중 모달 결정 모델입니다. 텍스트, JSON, 이미지 및 비디오를 처리하여 확률로 질문에 답변합니다. 복잡한 의사 결정 작업에 적합하며, 질문당 최대 131,072 토큰을 지원하고 테스트를 위한 무료 API를 제공합니다.d3-ultra는 vLLM Semantic Router의 27B 다중 모달 결정 모델입니다. 텍스트, JSON, 이미지 및 비디오를 처리하여 확률로 질문에 답변합니다. 복잡한 의사 결정 작업에 적합하며, 질문당 최대 131,072 토큰을 지원하고 테스트를 위한 무료 API를 제공합니다.

AI 모델 및 LLM
AI 모델 TOP 5 보기

GLiDE 27B는 Fastino에서 개발한 270억 개의 매개변수를 가진 의사결정 모델입니다. 이 모델은 텍스트, JSON 및 선택적 이미지를 포함하는 상태를 처리하여 각 옵션에 대한 확률로 입력된 질문에 답변합니다. 이 모델은 분류, 라우팅 및 점수 매기기 작업에 적합하며, 다양한 의사결정 응용 프로그램을 위해…

AI 모델 및 LLM
도구 보기

Fastino에서 개발한 270억 개의 매개변수를 가진 의사결정 모델입니다. 이 모델은 텍스트, JSON 및 선택적 이미지를 포함하는 상태를 처리하여 각 옵션에 대한 확률로 입력된 질문에 답변합니다. 이 모델은 분류, 라우팅 및 점수 매기기 작업에 적합하며, 다양한 의사결정 응용 프로그램을 위해…GLiDE 27B는 Fastino에서 개발한 270억 개의 매개변수를 가진 의사결정 모델입니다. 이 모델은 텍스트, JSON 및 선택적 이미지를 포함하는 상태를 처리하여 각 옵션에 대한 확률로 입력된 질문에 답변합니다. 이 모델은 분류, 라우팅 및 점수 매기기 작업에 적합하며, 다양한 의사결정 응용 프로그램을 위해…

AI 모델 및 LLM
LLM TOP 50 보기

DeepSeek-V4-Flash-Vision-Exp는 시각적 이해 능력을 향상시키는 DeepSeek-V4 계열의 실험적인 다중 모달 모델입니다. 이는 DeepSeek-V4-Flash 아키텍처를 기반으로 하여 텍스트 전용 성능을 유지하면서 개선된 다중 모달 에이전트 기능을 제공합니다.

AI 모델 및 LLM
도구 보기

시각적 이해 능력을 향상시키는 DeepSeek-V4 계열의 실험적인 다중 모달 모델입니다. 이는 DeepSeek-V4-Flash 아키텍처를 기반으로 하여 텍스트 전용 성능을 유지하면서 개선된 다중 모달 에이전트 기능을 제공합니다.DeepSeek-V4-Flash-Vision-Exp는 시각적 이해 능력을 향상시키는 DeepSeek-V4 계열의 실험적인 다중 모달 모델입니다. 이는 DeepSeek-V4-Flash 아키텍처를 기반으로 하여 텍스트 전용 성능을 유지하면서 개선된 다중 모달 에이전트 기능을 제공합니다.

AI 모델 및 LLM
LLM TOP 50 보기

Ling-3.1-flash는 복잡한 실제 작업을 위해 설계된 고급 하이브리드 추론 모델입니다. 총 5600억 개의 매개변수와 100만 토큰의 컨텍스트 창을 특징으로 하여 의료, 금융 및 소프트웨어 엔지니어링을 포함한 다양한 분야에서 성능을 향상시킵니다.

AI 모델 및 LLM

LLM 41위

도구 보기

복잡한 실제 작업을 위해 설계된 고급 하이브리드 추론 모델입니다. 총 5600억 개의 매개변수와 100만 토큰의 컨텍스트 창을 특징으로 하여 의료, 금융 및 소프트웨어 엔지니어링을 포함한 다양한 분야에서 성능을 향상시킵니다.Ling-3.1-flash는 복잡한 실제 작업을 위해 설계된 고급 하이브리드 추론 모델입니다. 총 5600억 개의 매개변수와 100만 토큰의 컨텍스트 창을 특징으로 하여 의료, 금융 및 소프트웨어 엔지니어링을 포함한 다양한 분야에서 성능을 향상시킵니다.

AI 모델 및 LLM
LLM 41위

LiquidAI LFM3-1.7B는 로컬 에이전트 및 전문 애플리케이션을 위해 설계된 텍스트 모델입니다. 이 모델은 트라이 하이브리드 아키텍처를 특징으로 하며 256K 토큰의 컨텍스트 윈도우를 지원하여 엣지 장치에 적합합니다. 이 모델은 도메인별 파인 튜닝에 적합합니다.

AI 모델 및 LLM
도구 보기

로컬 에이전트 및 전문 애플리케이션을 위해 설계된 텍스트 모델입니다. 이 모델은 트라이 하이브리드 아키텍처를 특징으로 하며 256K 토큰의 컨텍스트 윈도우를 지원하여 엣지 장치에 적합합니다. 이 모델은 도메인별 파인 튜닝에 적합합니다.LiquidAI LFM3-1.7B는 로컬 에이전트 및 전문 애플리케이션을 위해 설계된 텍스트 모델입니다. 이 모델은 트라이 하이브리드 아키텍처를 특징으로 하며 256K 토큰의 컨텍스트 윈도우를 지원하여 엣지 장치에 적합합니다. 이 모델은 도메인별 파인 튜닝에 적합합니다.

AI 모델 및 LLM
LLM TOP 50 보기

MiniMax-M3.1-Flash는 코딩, 에이전트 워크플로우 및 사이버 보안을 위해 설계된 다중 모달 전문가 혼합 모델입니다. 텍스트, 이미지 및 비디오 입력을 지원하며, 희소 주의 및 양자화 인식 훈련을 통해 작업 성능과 추론 효율성을 향상시킵니다.

AI 모델 및 LLM
도구 보기

코딩, 에이전트 워크플로우 및 사이버 보안을 위해 설계된 다중 모달 전문가 혼합 모델입니다. 텍스트, 이미지 및 비디오 입력을 지원하며, 희소 주의 및 양자화 인식 훈련을 통해 작업 성능과 추론 효율성을 향상시킵니다.MiniMax-M3.1-Flash는 코딩, 에이전트 워크플로우 및 사이버 보안을 위해 설계된 다중 모달 전문가 혼합 모델입니다. 텍스트, 이미지 및 비디오 입력을 지원하며, 희소 주의 및 양자화 인식 훈련을 통해 작업 성능과 추론 효율성을 향상시킵니다.

AI 모델 및 LLM
LLM TOP 50 보기
1/8