설명
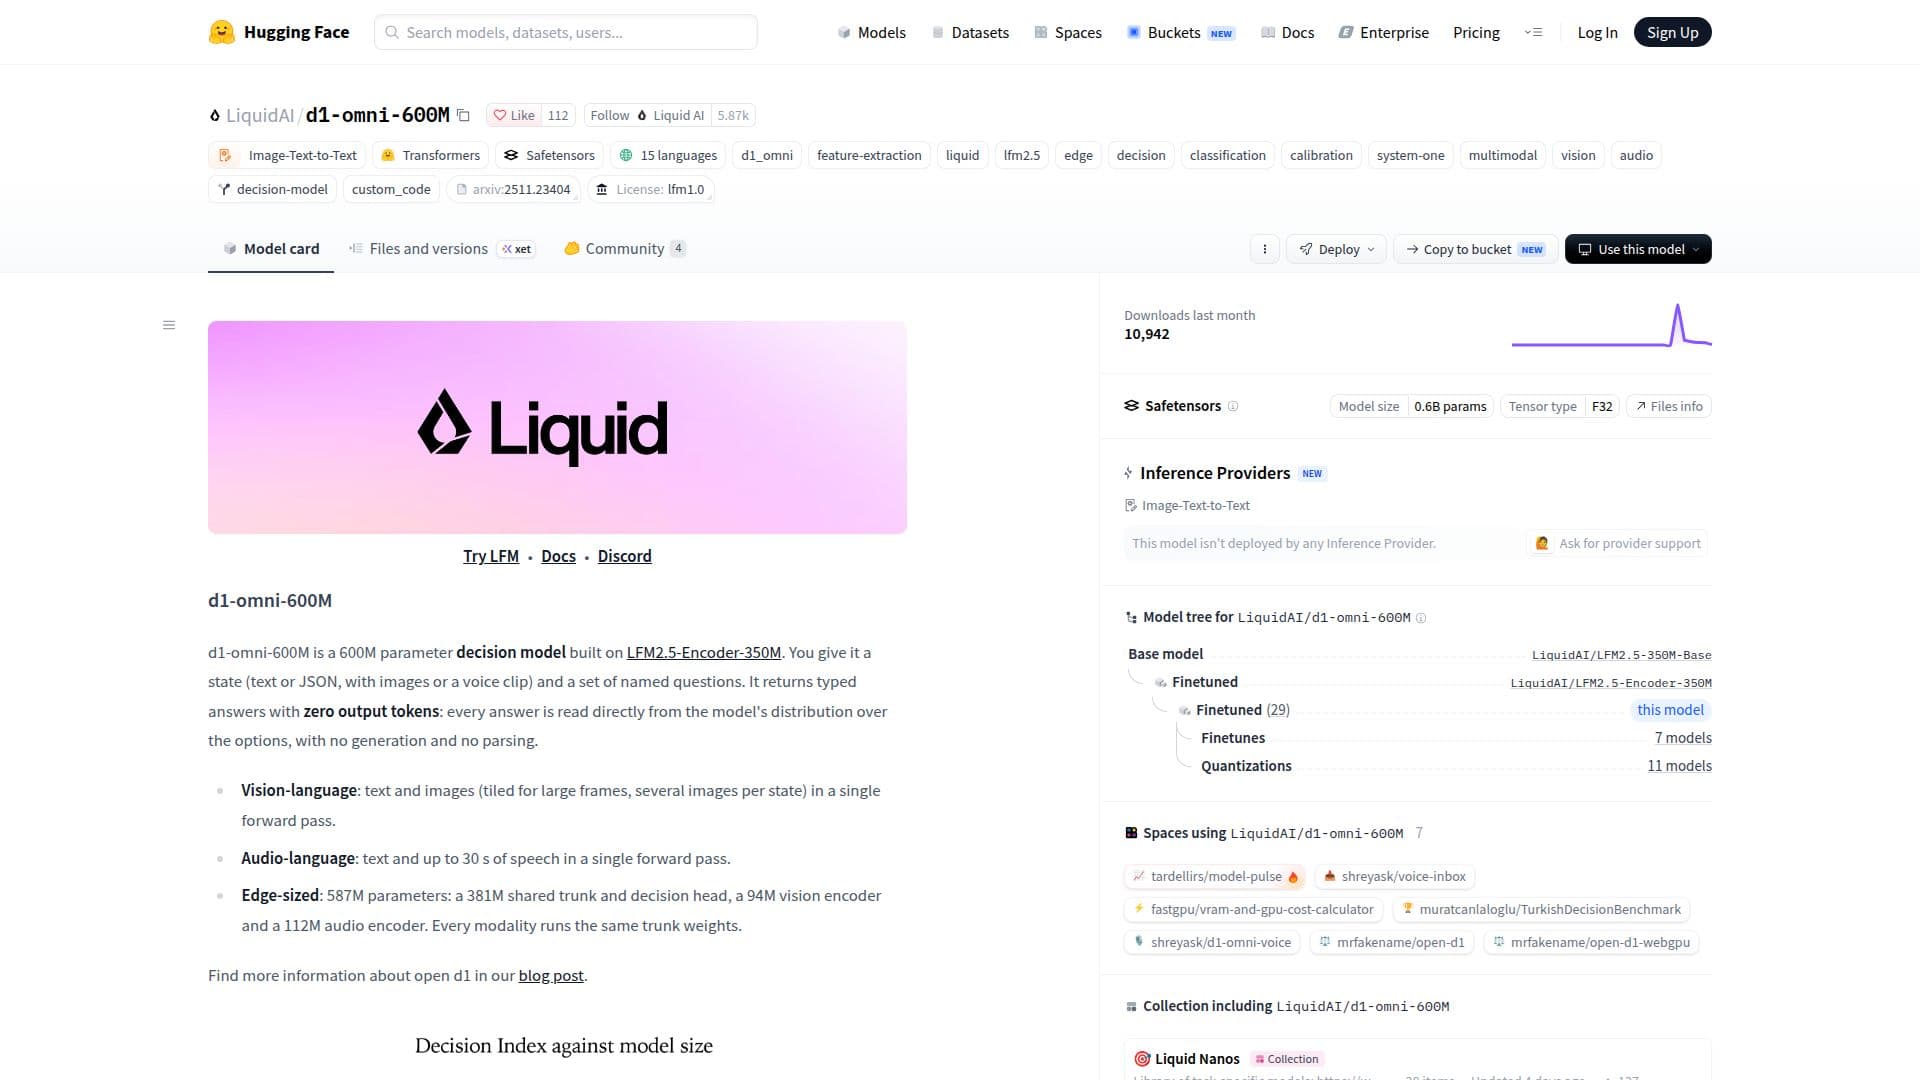
LiquidAI d1-omni-600M은 6억 개의 매개변수를 갖춘 정교한 결정 모델로, LFM2.5-Encoder-350M 프레임워크를 기반으로 구축되었습니다. 이 모델은 텍스트, 이미지 및 오디오를 포함한 멀티모달 입력을 단일 전방 패스로 처리하도록 설계되었습니다. 특히 라우팅, 조정, 분류 및 시각 검사 작업과 같은 예/아니오 답변, 옵션 선택 또는 평가가 필요한 애플리케이션에 적합합니다.
더 읽기
모델의 아키텍처는 공유 트렁크와 결정 헤드를 포함하며, 비전 및 오디오를 위한 전문 인코더가 함께 제공됩니다. 비전 인코더는 SigLIP2 비전 타워를 기반으로 하며, 오디오 인코더는 17층 FastConformer를 사용합니다. 이 설계는 모든 모달리티가 동일한 트렁크 가중치를 사용하여 처리되도록 하여 효율성과 일관성을 향상시킵니다.
d1-omni-600M의 주요 기능 중 하나는 모델의 옵션 분포에서 직접 입력된 답변을 반환할 수 있는 능력으로, 출력 토큰 생성이나 파싱이 필요하지 않습니다. 이 기능은 속도와 자원 효율성이 중요한 엣지 배포에 특히 유용합니다.
모델은 텍스트, 이미지 및 오디오 위치를 함께 수용할 수 있는 16,384 토큰의 컨텍스트 길이를 지원합니다. 이미지가 포함될 경우 상태 및 질문 텍스트는 훈련 사양에 따라 896 토큰으로 제한됩니다. 모델의 어휘 크기는 65,536으로, 광범위한 입력 처리를 가능하게 합니다.
오디오 기능은 영어 화자와 어시스턴트 간의 상호작용을 통해 특별히 훈련되었으며, 발화 유형, 주제 및 화자의 의도를 식별하는 데 중점을 두었습니다. 이 모델은 채팅 애플리케이션을 위해 설계되지 않았으며 텍스트를 생성하지 않으므로 의사 결정 작업에 이상적입니다.
LiquidAI d1-omni-600M은 오픈 소스 모델로, 인공지능 분야의 추가 연구 및 개발을 장려합니다. 이 모델은 transformers 버전 5.15 이상에서 사용할 수 있으며, 효율적인 의사 결정 기능이 필요한 다양한 파이프라인에 통합될 수 있습니다.
- 카테고리AI 모델 및 LLM
- 요금제오픈소스
- 배포클라우드
- 플랫폼웹
LiquidAI d1-omni-600M 하이라이트
600M 매개변수
멀티모달 입력 지원
단일 패스 의사 결정
엣지 배포 최적화
오픈 소스
비전 및 오디오 인코더
출력 토큰 생성 없음
16,384 토큰의 컨텍스트 길이
LiquidAI d1-omni-600M 시작하기
모델 페이지에 접근하기
인증하기
모델 구성하기
프롬프트 전송하기
LiquidAI d1-omni-600M의 사용 사례
- 라우팅 및 분류
- 조정
- 의도 분류
- 음성 명령 라우팅
- 시각 검사