설명
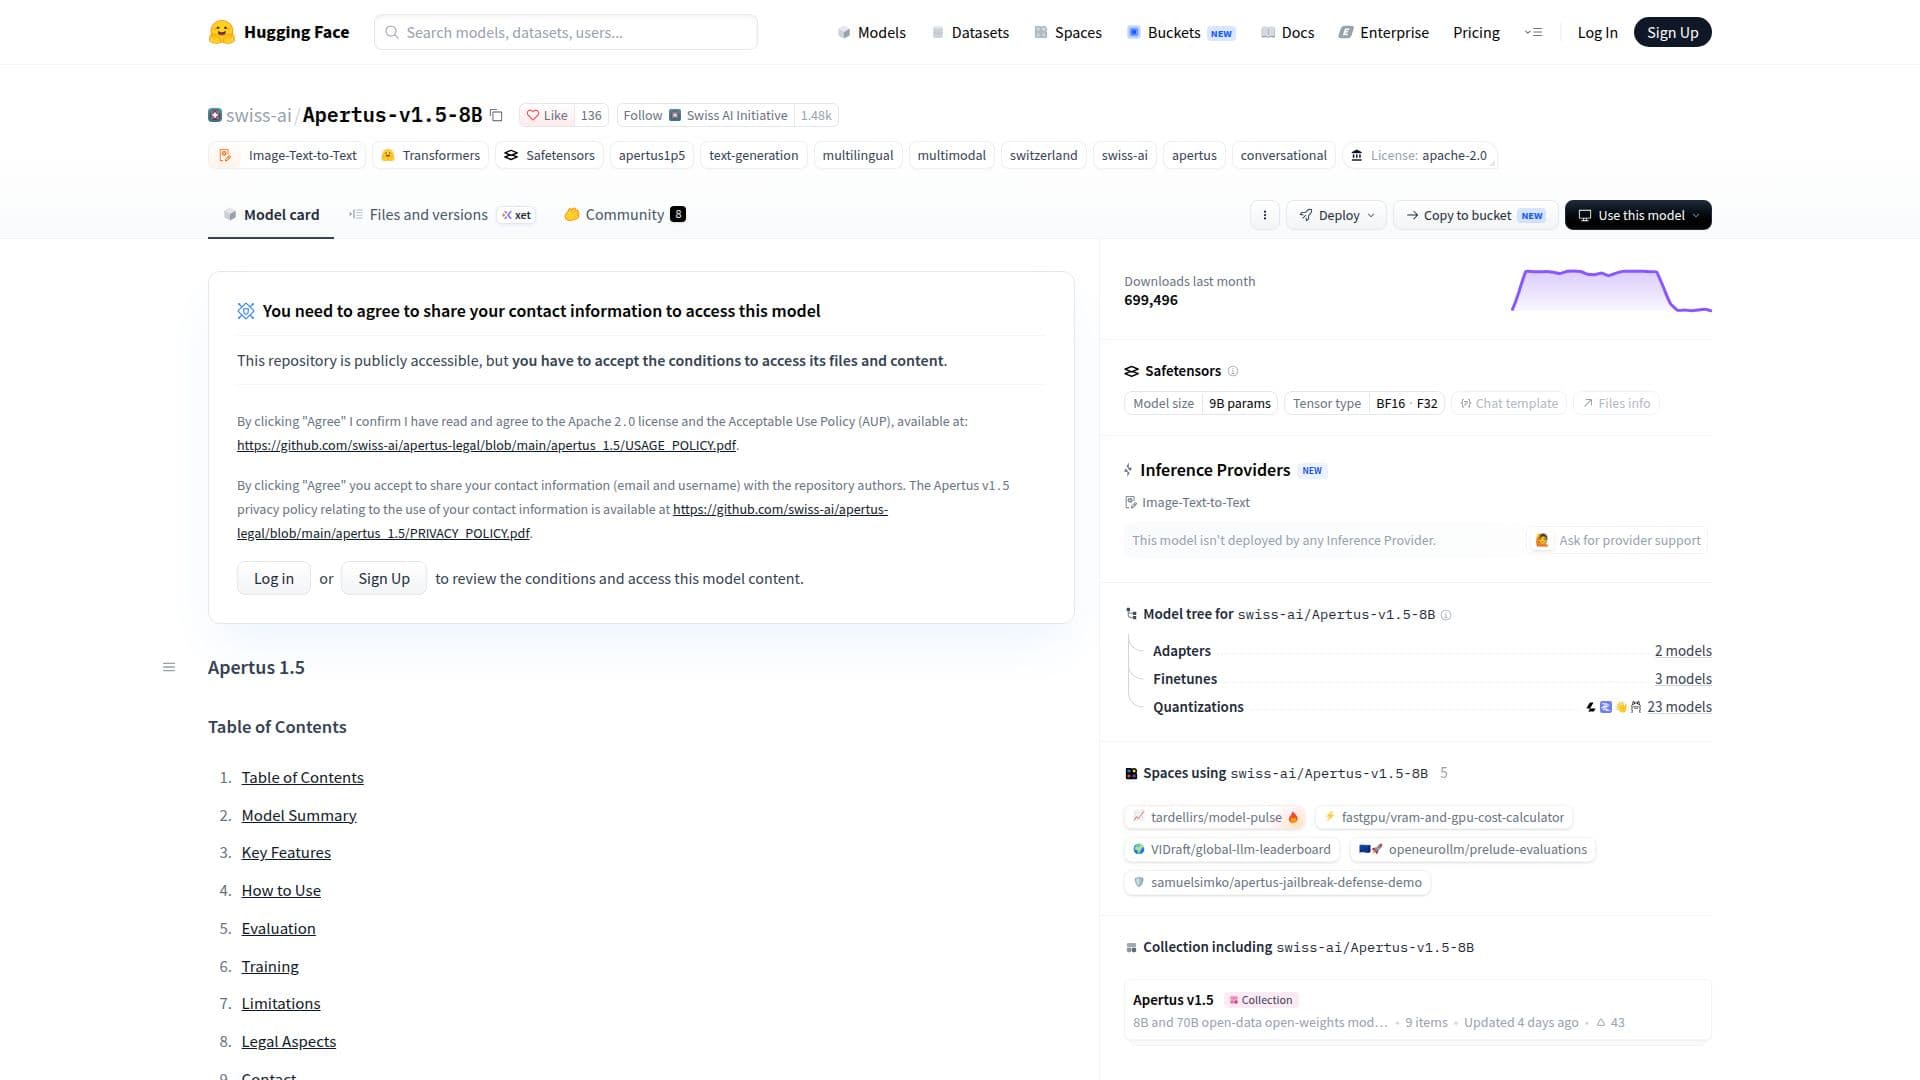
Apertus 1.5는 다국어 및 다중 모드 AI 기능을 향상시키기 위해 개발된 고급 언어 모델 시리즈입니다. 80억 및 700억 개의 매개변수를 갖춘 모델을 통해 Apertus 1.5는 다양한 언어를 지원하며 최대 262,144 토큰까지의 맥락을 처리할 수 있습니다. 이는 텍스트 생성에서 복잡한 추론 작업에 이르기까지 다양한 애플리케이션에 매우 유용합니다.
더 읽기
모델은 디코더 전용 변환기 아키텍처를 기반으로 구축되었으며, 80B 모델의 경우 4조 개의 토큰과 70B 모델의 경우 2조 개의 토큰을 포함한 상당한 양의 데이터로 사전 훈련되었습니다. 이러한 광범위한 훈련을 통해 Apertus 1.5는 이미지, 오디오 및 텍스트 입력에서 텍스트를 처리하고 생성할 수 있어 개발자에게 혁신적인 애플리케이션을 만들 수 있는 새로운 가능성을 제공합니다.
Apertus 1.5는 책임 있는 개발을 염두에 두고 설계되었으며, 데이터 소유자의 선택적 동의를 존중하고 훈련 데이터의 암기를 방지하는 방법을 사용합니다. 모델은 완전히 공개되어 있으며, 공개 가중치, 데이터 및 훈련 세부정보가 일반에 공개되어 투명성과 접근성을 보장합니다.
모델은 또한 추론 기능을 향상시키는 '사고 모드'를 도입하여 보다 정확하고 맥락을 고려한 응답을 가능하게 합니다. 이 기능은 향상된 지침 준수 및 도구 사용 기능과 결합되어, 고급 AI 기능을 프로젝트에 통합하려는 개발자에게 강력한 도구가 됩니다.
Apertus 1.5의 배포는 Transformers 및 vLLM과 같은 오픈 소스 프레임워크에서 지원되며, 시작하는 데 필요한 자세한 지침이 제공됩니다. 모델은 데스크톱 및 클라우드 환경 모두에서 사용할 수 있어 다양한 배포 시나리오에 유연성을 제공합니다.
- 카테고리AI 모델 및 LLM
- 요금제오픈 소스
- 배포클라우드, 셀프 호스팅
- 플랫폼웹
Apertus 1.5 하이라이트
다국어 지원
다중 모드 입력 처리
오픈 소스 접근
긴 맥락 처리
향상된 추론 기능
강화된 지침 준수
도구 사용 통합
책임 있는 데이터 처리
Apertus 1.5 시작하기
모델 페이지 접근: Hugging Face의 Apertus 1.5 페이지 방문
인증: 모델에 접근하기 위해 로그인 또는 가입
구성: 모델 매개변수 및 환경 설정
프롬프트 전송: 처리할 텍스트, 이미지 또는 오디오 입력
미세 조정: 특정 작업을 위한 모델 설정 조정
Apertus 1.5의 사용 사례
- 다국어 텍스트 생성
- 다중 모드 콘텐츠 생성
- 고급 추론 작업
- 지침 준수
- 도구 통합