설명
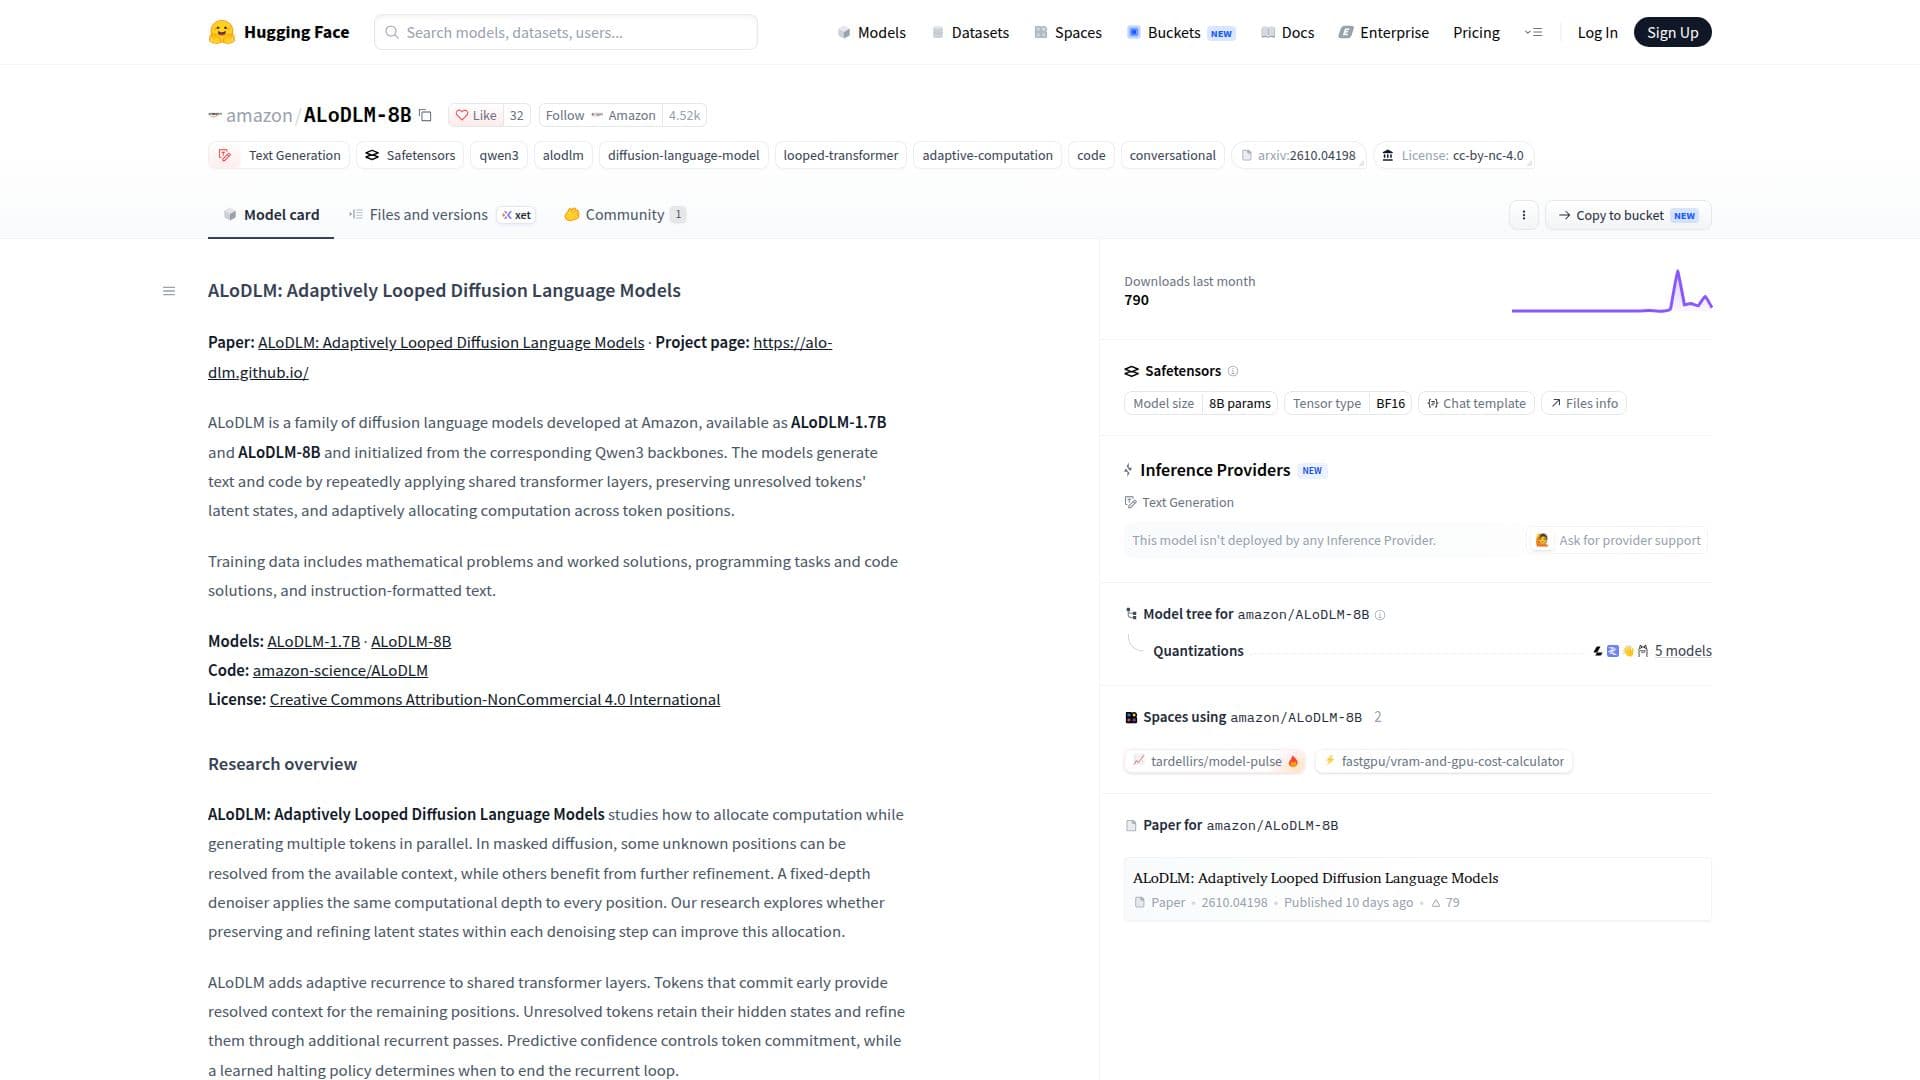
ALoDLM-8B는 아마존이 개발한 확산 언어 모델인 ALoDLM 패밀리의 일부입니다. 이 모델들은 공유된 변환기 층을 반복적으로 적용하여 텍스트와 코드를 생성하도록 설계되었습니다. ALoDLM-8B는 그보다 작은 ALoDLM-1.7B와 함께 Qwen3 백본에서 초기화됩니다. 이 모델들은 적응형 계산을 활용하여 해결되지 않은 토큰의 잠재 상태를 보존하고, 토큰 위치에 따라 계산을 효과적으로 할당합니다.
더 읽기
ALoDLM-8B의 훈련 데이터에는 수학 문제와 해결책, 프로그래밍 작업, 지침 형식의 텍스트가 포함됩니다. 이러한 다양한 데이터셋은 모델이 다양한 언어 및 코드 생성 작업에서 뛰어난 성능을 발휘할 수 있도록 합니다. 모델의 아키텍처는 공유된 변환기 층에서 적응형 반복을 특징으로 하여, 조기 결정을 내린 토큰이 나머지 위치에 대한 해결된 컨텍스트를 제공할 수 있도록 합니다. 해결되지 않은 토큰은 자신의 숨겨진 상태를 유지하고 추가 반복 패스를 통해 이를 정제합니다.
ALoDLM-8B의 연구는 여러 토큰을 병렬로 생성하는 동안 계산 할당을 탐구합니다. 이 모델은 고정 깊이의 디노이저를 사용하여 모든 위치에 동일한 계산 깊이를 적용하며, 적응형 반복은 각 디노이징 단계 내에서 잠재 상태를 보존하고 정제하여 할당을 개선하는 데 도움을 줍니다. 모델의 예측 신뢰도는 토큰의 결정을 제어하며, 학습된 중단 정책은 반복 루프를 종료할 시점을 결정합니다.
ALoDLM-8B의 의도된 사용은 확산 언어 모델링, 적응형 계산, 수학적 추론 및 코드 생성에 대한 비상업적 연구입니다. 보고된 벤치마크가 자율 운영이나 중대한 결과를 초래하는 결정에 대한 준비성을 확립하지 않기 때문에 특정 응용 프로그램에 대해 모델을 평가하는 것이 중요합니다. 이 모델은 Creative Commons Attribution-NonCommercial 4.0 International 라이센스 하에 있으며, 가중치는 공개 다운로드가 가능합니다.
- 카테고리AI 모델 및 LLM
- 요금제오픈소스
- 배포클라우드
- 플랫폼웹
ALoDLM-8B 하이라이트
적응형 계산 할당
지속적인 잠재 정제
추론 시간 제어
공유 변환기 층
해결되지 않은 토큰을 위한 반복 패스
토큰 결정을 위한 예측 신뢰도
학습된 중단 정책
비상업적 연구 지원
ALoDLM-8B 시작하기
모델 페이지 접근: ALoDLM-8B의 허깅페이스 모델 페이지를 방문하세요.
인증: 필요시 허깅페이스 계정에 로그인하세요.
구성: Python 및 필요한 라이브러리를 사용하여 모델 환경을 설정하세요.
프롬프트 전송: 프롬프트를 전송하여 모델을 사용해 텍스트나 코드를 생성하세요.
미세 조정: 필요시 특정 작업을 위해 모델 매개변수를 조정하세요.
ALoDLM-8B의 사용 사례
- 텍스트 생성
- 코드 생성
- 수학적 추론
- 연구
- 적응형 계산