본문으로 건너뛰기
ToolPotion
AI 어드바이저
제출 (무료)

llmspeed

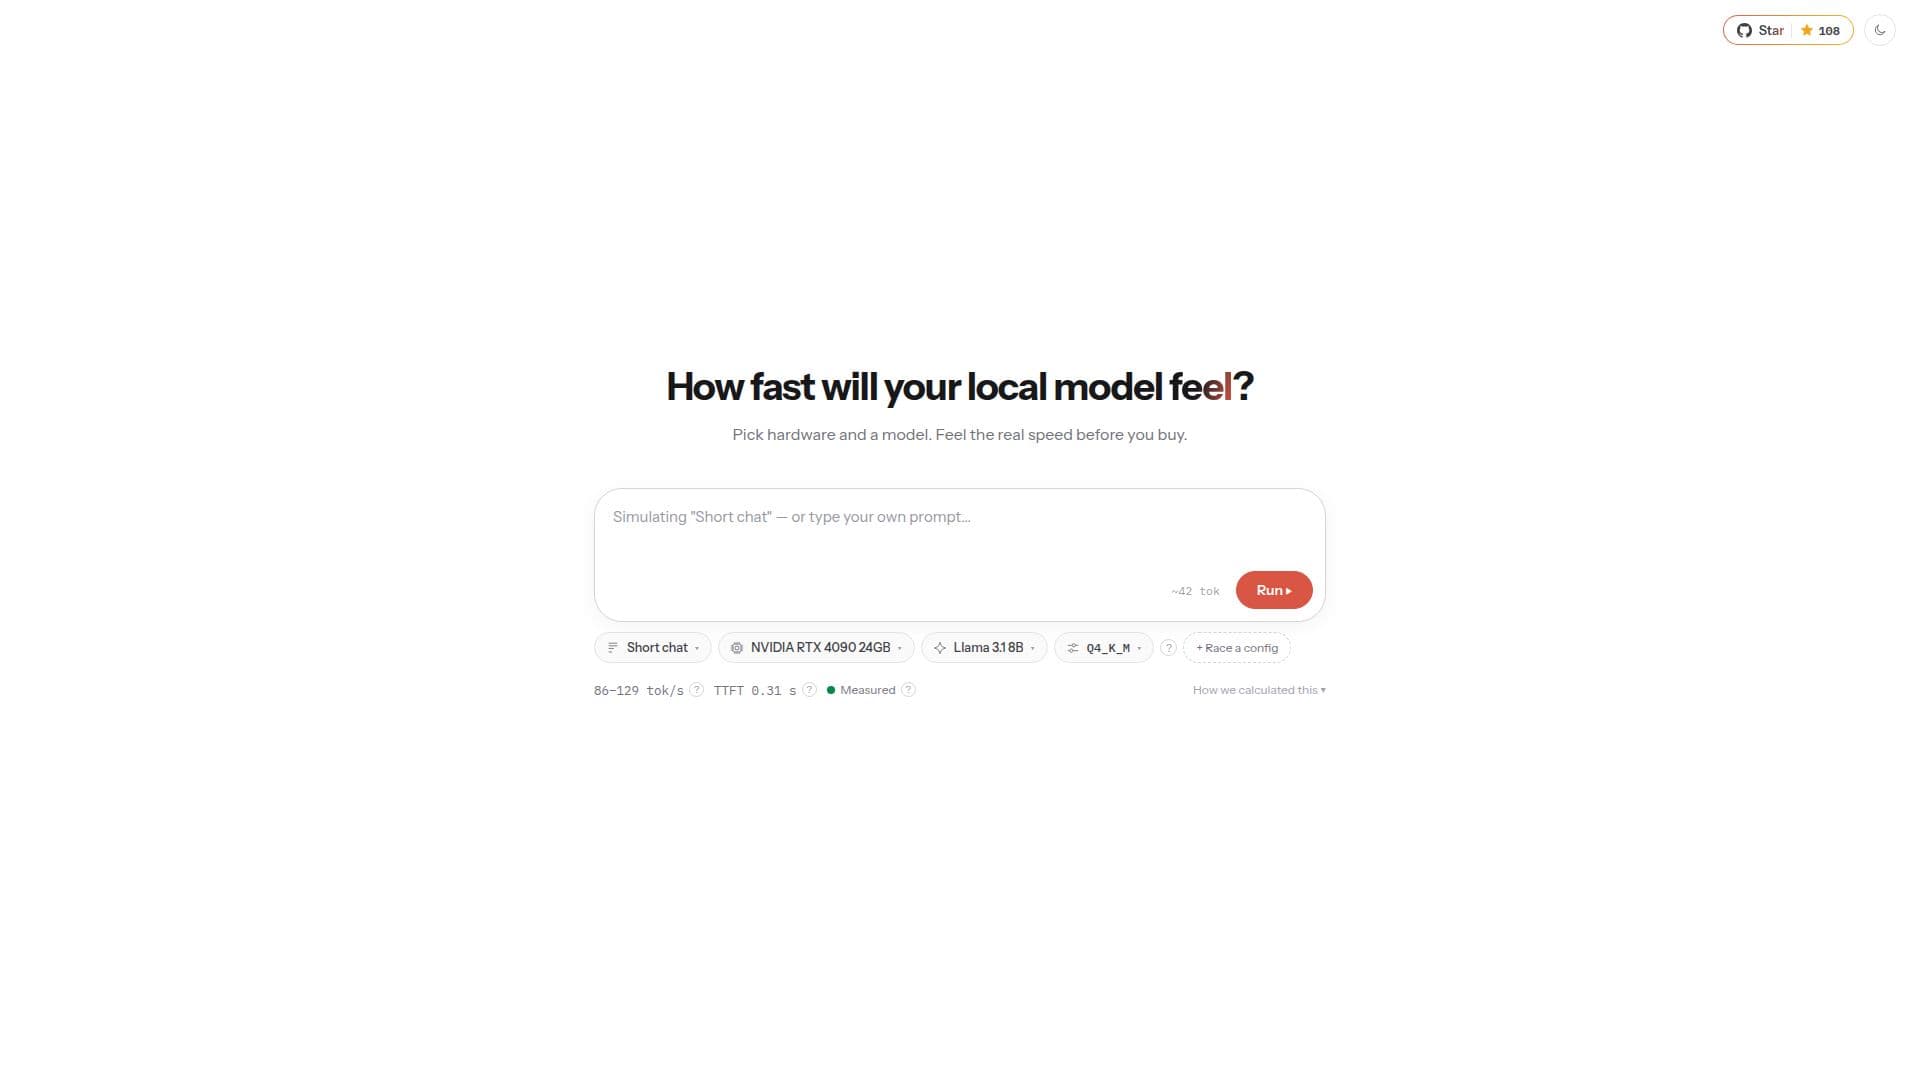
llmspeed는 사용자가 구매하기 전에 로컬 LLM의 속도를 시뮬레이션할 수 있도록 합니다. 하드웨어와 모델을 선택함으로써 사용자는 검증된 벤치마크를 기반으로 초당 토큰 수 및 첫 번째 토큰까지의 시간과 같은 실시간 성능 지표를 경험할 수 있습니다.

URL 방문
공유
llmspeed 스크린샷
llmspeed 스크린샷

llmspeed는 사용자가 구매하기 전에 로컬 대형 언어 모델(LLM)의 성능을 평가할 수 있도록 설계된 독특한 도구입니다. 사용자가 특정 하드웨어와 모델을 선택할 수 있도록 함으로써, llmspeed는 초당 토큰 수 및 첫 번째 토큰까지의 시간과 같은 실시간 성능 지표의 시뮬레이션을 제공합니다. 이 시뮬레이션은 다양한 출처의 검증된 벤치마크에 기반하여 정확성과 신뢰성을 보장합니다.

더 읽기

이 플랫폼은 NVIDIA GPU, AMD 프로세서, Apple Mac 등 다양한 하드웨어 옵션을 지원합니다. 사용자는 Qwen, GLM, Gemma 및 GPT-OSS와 같은 모델 중에서 선택할 수 있어 포괄적인 평가 경험을 제공합니다. llmspeed의 오픈 소스 특성은 GitHub에서 제공되며, 커뮤니티 기여와 투명성을 허용합니다.

가격 모델이 USD 0으로 설정된 llmspeed는 로컬 LLM의 잠재적 속도를 이해하고자 하는 모든 사용자에게 접근 가능합니다. 이 도구는 특정 하드웨어나 모델에 투자하기 전에 정확한 성능 통찰력이 필요한 개발자, 연구자 및 AI 애호가에게 특히 유용합니다.

전반적으로 llmspeed는 하드웨어 능력과 모델 성능 간의 격차를 해소하여 정보에 기반한 구매 결정을 가능하게 하고 AI 워크플로를 최적화하는 귀중한 서비스를 제공합니다.

  • 카테고리MLOps 및 모델 배포
  • 요금제무료
  • 배포클라우드
  • 플랫폼웹

  • 초당 토큰 수 시뮬레이션

  • 첫 번째 토큰까지의 시간 계산

  • 다양한 하드웨어 옵션 지원

  • 여러 LLM 모델 포함

  • 검증된 벤치마크 기반

  • GitHub에서 오픈 소스

  • 무료 사용 가능

  • 커뮤니티 기반 통찰력

  1. 하드웨어 선택: 지원되는 다양한 장치 중에서 선택

  2. 모델 선택: 테스트할 LLM 모델 선택

  3. 시뮬레이션 실행: 성능 지표를 보기 위해 시뮬레이션 실행

  4. 결과 분석: 정보에 기반한 결정을 내리기 위해 결과 분석

  • 하드웨어 평가
  • 모델 비교
  • 성능 벤치마킹
  • 연구 및 개발
  • AI 워크플로 최적화

llmspeed 리뷰

로딩 중...

llmspeed와(과) 비슷한 인기 AI 도구

GPU 또는 Mac을 감지하고, VRAM 요구 사항 및 속도 추정치를 포함하여 로컬에서 실행할 수 있는 LLM, 코딩, 이미지 및 비디오 모델을 보여주는 무료 도구입니다.

머신러닝 및 데이터 사이언스

머신러닝 및 데이터 사이언스 47위

도구 보기

GPU 또는 Mac을 감지하고, VRAM 요구 사항 및 속도 추정치를 포함하여 로컬에서 실행할 수 있는 LLM, 코딩, 이미지 및 비디오 모델을 보여주는 무료 도구입니다.

머신러닝 및 데이터 사이언스
머신러닝 및 데이터 사이언스 47위

ComputeArena는 커뮤니티에서 제출한 로컬 AI 모델의 벤치마크를 위한 플랫폼을 제공합니다. 사용자는 커뮤니티 하드웨어에서 제공한 서명된 보고서를 사용하여 다양한 모델, 양자화 및 칩 간의 성능을 비교할 수 있습니다.

머신러닝 및 데이터 사이언스
도구 보기

커뮤니티에서 제출한 로컬 AI 모델의 벤치마크를 위한 플랫폼을 제공합니다. 사용자는 커뮤니티 하드웨어에서 제공한 서명된 보고서를 사용하여 다양한 모델, 양자화 및 칩 간의 성능을 비교할 수 있습니다.ComputeArena는 커뮤니티에서 제출한 로컬 AI 모델의 벤치마크를 위한 플랫폼을 제공합니다. 사용자는 커뮤니티 하드웨어에서 제공한 서명된 보고서를 사용하여 다양한 모델, 양자화 및 칩 간의 성능을 비교할 수 있습니다.

머신러닝 및 데이터 사이언스
AI 앱 TOP 250 보기

vLLM

AI 앱

vLLM은 대형 언어 모델(LLM)을 위한 고처리량 및 메모리 효율적인 추론 및 서비스 엔진입니다. 이는 최첨단 성능을 통해 AI 모델의 빠른 배포를 가능하게 하여 다양한 산업의 사용자에게 LLM 서비스를 쉽고 빠르며 비용 효율적으로 제공합니다.

MLOps 및 모델 배포
도구 보기

AI 앱

대형 언어 모델(LLM)을 위한 고처리량 및 메모리 효율적인 추론 및 서비스 엔진입니다. 이는 최첨단 성능을 통해 AI 모델의 빠른 배포를 가능하게 하여 다양한 산업의 사용자에게 LLM 서비스를 쉽고 빠르며 비용 효율적으로 제공합니다.vLLM은 대형 언어 모델(LLM)을 위한 고처리량 및 메모리 효율적인 추론 및 서비스 엔진입니다. 이는 최첨단 성능을 통해 AI 모델의 빠른 배포를 가능하게 하여 다양한 산업의 사용자에게 LLM 서비스를 쉽고 빠르며 비용 효율적으로 제공합니다.

MLOps 및 모델 배포
AI 앱 TOP 250 보기

노트북 LLM 탐색기는 귀하의 노트북이 단일 CPU에서 Qwen3.8-27B 또는 DeepSeek-V4-Flash-0731을 실행할 수 있는지 판단하는 데 도움을 줍니다. RAM, 디스크 및 OS 요구 사항에 대한 검증된 경로를 제공하여 효율적인 로컬 추론을 보장합니다.

AI 모델 및 LLM
도구 보기

귀하의 노트북이 단일 CPU에서 Qwen3.8-27B 또는 DeepSeek-V4-Flash-0731을 실행할 수 있는지 판단하는 데 도움을 줍니다. RAM, 디스크 및 OS 요구 사항에 대한 검증된 경로를 제공하여 효율적인 로컬 추론을 보장합니다.노트북 LLM 탐색기는 귀하의 노트북이 단일 CPU에서 Qwen3.8-27B 또는 DeepSeek-V4-Flash-0731을 실행할 수 있는지 판단하는 데 도움을 줍니다. RAM, 디스크 및 OS 요구 사항에 대한 검증된 경로를 제공하여 효율적인 로컬 추론을 보장합니다.

AI 모델 및 LLM
AI 앱 TOP 250 보기

Dreamscale Labs는 물리적 AI를 위한 실시간 클라우드 추론을 제공하여 로봇 팀이 비싼 로컬 GPU 없이 모델을 배포하고 평가할 수 있도록 합니다. 이 플랫폼은 모델, GPU 커널 및 네트워크 레이어를 최적화하여 낮은 지연 시간 실행을 보장합니다.

로보틱스 및 AI 하드웨어

AI DevOps 및 클라우드 도구 180위

도구 보기

물리적 AI를 위한 실시간 클라우드 추론을 제공하여 로봇 팀이 비싼 로컬 GPU 없이 모델을 배포하고 평가할 수 있도록 합니다. 이 플랫폼은 모델, GPU 커널 및 네트워크 레이어를 최적화하여 낮은 지연 시간 실행을 보장합니다.Dreamscale Labs는 물리적 AI를 위한 실시간 클라우드 추론을 제공하여 로봇 팀이 비싼 로컬 GPU 없이 모델을 배포하고 평가할 수 있도록 합니다. 이 플랫폼은 모델, GPU 커널 및 네트워크 레이어를 최적화하여 낮은 지연 시간 실행을 보장합니다.

로보틱스 및 AI 하드웨어
AI DevOps 및 클라우드 도구 180위

목적에 맞게 설계된 ASIC 인프라를 통해 모델을 제공하는 고속 AI 추론 제공업체로, OpenAI 호환 API를 통해 지연에 민감한 작업 부하인 코딩 에이전트 및 실시간 음성에 대해 낮은 첫 번째 토큰 시간과 높은 처리량을 제공합니다.

MLOps 및 모델 배포
도구 보기

목적에 맞게 설계된 ASIC 인프라를 통해 모델을 제공하는 고속 AI 추론 제공업체로, OpenAI 호환 API를 통해 지연에 민감한 작업 부하인 코딩 에이전트 및 실시간 음성에 대해 낮은 첫 번째 토큰 시간과 높은 처리량을 제공합니다.

MLOps 및 모델 배포
AI 앱 TOP 250 보기

gpt-oss는 강력한 성능과 효율적인 배포를 위해 설계된 두 개의 오픈 가중치 언어 모델인 gpt-oss-120b와 gpt-oss-20b를 포함합니다. 이 모델들은 Apache 2.0 라이선스 하에 제공되어 다양한 애플리케이션에 접근할 수 있으며, 안전성과 사용자 맞춤화를 보장합니다.

AI 모델 및 LLM
도구 보기

강력한 성능과 효율적인 배포를 위해 설계된 두 개의 오픈 가중치 언어 모델인 gpt-oss-120b와 gpt-oss-20b를 포함합니다. 이 모델들은 Apache 2.0 라이선스 하에 제공되어 다양한 애플리케이션에 접근할 수 있으며, 안전성과 사용자 맞춤화를 보장합니다.gpt-oss는 강력한 성능과 효율적인 배포를 위해 설계된 두 개의 오픈 가중치 언어 모델인 gpt-oss-120b와 gpt-oss-20b를 포함합니다. 이 모델들은 Apache 2.0 라이선스 하에 제공되어 다양한 애플리케이션에 접근할 수 있으며, 안전성과 사용자 맞춤화를 보장합니다.

추천AI 모델 및 LLM
LLM TOP 50 보기

ZETIC Melange는 모든 기기에서 어떤 모델이든 온디바이스 AI 배포를 자동화합니다. 전직 Qualcomm 엔지니어들이 개발했으며, NPU 가속을 최적화하고 200개 이상의 기기에서 벤치마킹하며, 단 세 줄의 코드로 몇 시간 내에 배포를 가능하게 하여 비용과 지연 시간을 줄입니다.

MLOps 및 모델 배포

MLOps 및 모델 배포 137위

도구 보기

모든 기기에서 어떤 모델이든 온디바이스 AI 배포를 자동화합니다. 전직 Qualcomm 엔지니어들이 개발했으며, NPU 가속을 최적화하고 200개 이상의 기기에서 벤치마킹하며, 단 세 줄의 코드로 몇 시간 내에 배포를 가능하게 하여 비용과 지연 시간을 줄입니다.ZETIC Melange는 모든 기기에서 어떤 모델이든 온디바이스 AI 배포를 자동화합니다. 전직 Qualcomm 엔지니어들이 개발했으며, NPU 가속을 최적화하고 200개 이상의 기기에서 벤치마킹하며, 단 세 줄의 코드로 몇 시간 내에 배포를 가능하게 하여 비용과 지연 시간을 줄입니다.

MLOps 및 모델 배포
MLOps 및 모델 배포 137위
1/8