

설명
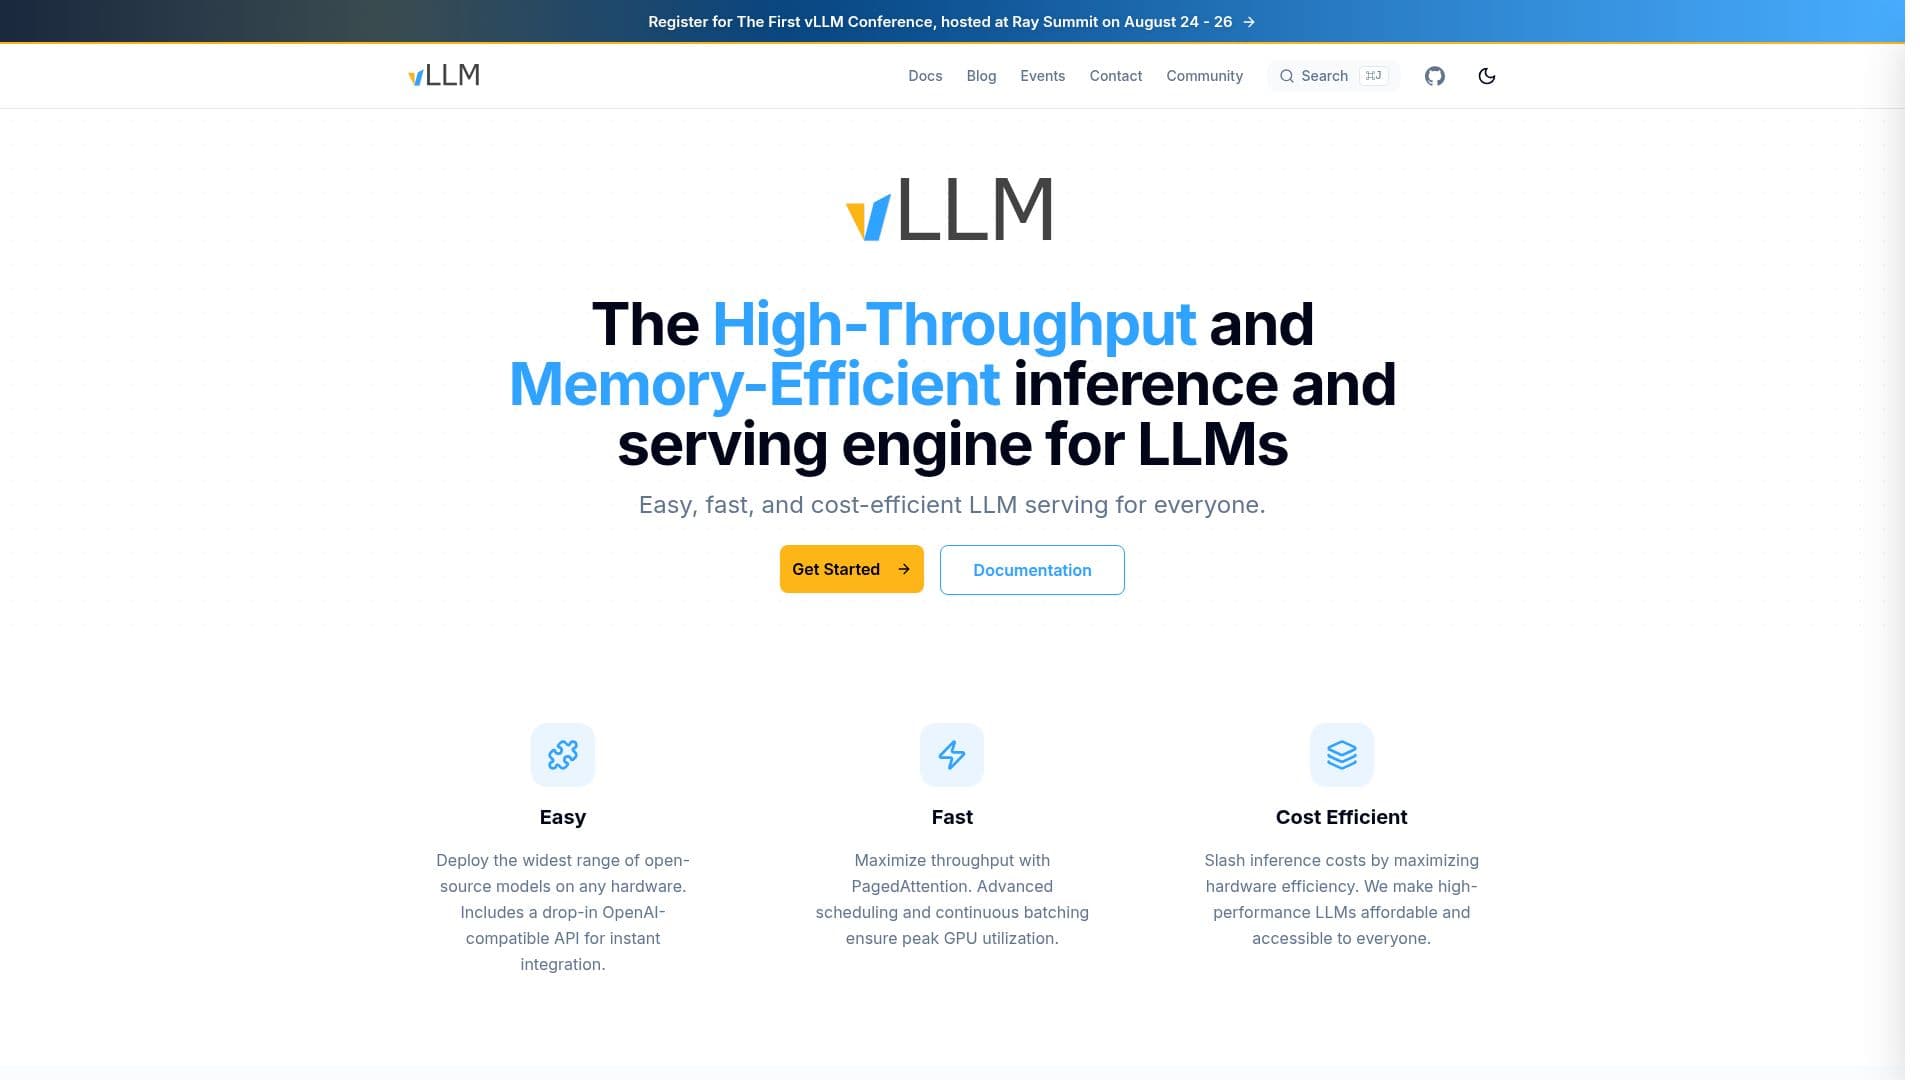
vLLM은 고처리량과 메모리 효율성에 중점을 두고 대형 언어 모델(LLM)의 추론 및 서비스를 최적화하도록 설계되었습니다. 이 엔진은 CUTLASS 및 TRTLLM-GEN과 같은 프레임워크를 활용하여 다양한 정밀도를 위한 최적화된 GEMM/MoE 커널과 같은 고급 기술을 활용합니다. vLLM의 목표는 AI 모델을 배포하는 원활한 경험을 제공하여 사용자가 LLM 서비스와 관련된 복잡성 없이 최첨단 성능을 달성할 수 있도록 하는 것입니다.
더 읽기
이 플랫폼은 범용 호환성을 위해 구축되어 NVIDIA GPU, AMD GPU 및 Google TPU를 포함한 다양한 하드웨어 구성과 통합할 수 있습니다. 이러한 유연성 덕분에 vLLM은 다양한 환경에서 AI 솔루션을 구현하려는 개발자와 조직에 이상적인 선택이 됩니다. 사용자는 간단한 구성 프로세스 덕분에 최소한의 설정으로 vLLM을 신속하게 사용할 수 있습니다.
vLLM은 또한 하드웨어 지원에서 모델 통합에 이르기까지 다양한 주제를 논의할 수 있는 포럼을 제공하는 커뮤니티 중심의 접근 방식을 제공합니다. 이러한 협력적인 환경은 지식 공유를 촉진하고 사용자가 플랫폼 사용을 최적화하는 데 도움을 줍니다. 또한 vLLM은 Llama, BART 및 GPT와 같은 인기 있는 아키텍처를 포함하여 다양한 모델을 지원합니다.
요약하자면, vLLM은 LLM을 효율적으로 배포하려는 모든 사람에게 강력한 도구로 두드러집니다. 성능, 사용 용이성 및 커뮤니티 지원의 조합은 AI의 빠르게 발전하는 분야에서 귀중한 자원으로 자리매김하게 합니다.
- 카테고리MLOps 및 모델 배포
- 요금제오픈 소스
- 배포클라우드
- 플랫폼NVIDIA, AMD, Google TPU
vLLM의 핵심 기능
고처리량
메모리 효율성
범용 호환성
최적화된 GEMM/MoE 커널
다양한 하드웨어 지원
커뮤니티 포럼
빠른 시작 구성
광범위한 모델 지원
vLLM 사용 방법은?
구성: vLLM을 지원하는 하드웨어 환경을 설정합니다.
설치: 문서에 제공된 설치 지침을 따릅니다.
배포: 원하는 AI 모델을 vLLM 엔진에 로드합니다.
최적화: 특정 사용 사례에 따라 성능을 위한 구성을 조정합니다.
vLLM의 사용 사례
- AI 모델 배포
- 성능 최적화
- 커뮤니티 참여
- 사용자 정의 모델 통합
- 크로스 플랫폼 호환성






